
ตัวแปลง Markdown สำหรับเอกสารและหน้าเว็บ
ตัวแปลง Markdown สำหรับเอกสารและหน้าเว็บสาธารณะ: PDF, Word, PowerPoint, Excel, รูปภาพ และ HTML กลายเป็นข้อความที่คุณตรวจสอบ นำกลับมาใช้ และส่งต่อให้เวิร์กโฟลว์ AI ได้
ทดลองใช้แบบไม่ต้องสมัคร · 10 MB · 3 ครั้ง/ชั่วโมง · 10 ครั้ง/วัน
แปลงเป็น Markdown จาก
- DOCX
- PPTX
- XLSX
- PNG / JPG
- HTML
- URL
วิธีการทำงาน
ตัวแปลง Markdown ทำงานอย่างไร
markitdown.ai เป็นตัวแปลง Markdown ที่เปลี่ยนไฟล์ PDF ไฟล์ Office รูปภาพ และหน้าเว็บให้เป็น Markdown ที่สะอาดและพร้อมใช้กับ AI สำหรับ ChatGPT, Claude, ไปป์ไลน์ RAG และเอเจนต์ ผ่านการทดลองใช้แบบไม่ต้องสมัคร หรือบัญชีแบบชำระเงินที่เข้าถึง API สำหรับนักพัฒนา
What happens
อัปโหลดไฟล์หรือวาง URL การแปลงทำงานบนเซิร์ฟเวอร์ของเรา ไม่ใช่แค่คัดลอกวางในเบราว์เซอร์ ไฟล์เดียวกันจึงได้ Markdown แบบเดียวกันไม่ว่าจะเข้ามาทางไหน แต่ละหน้าถูกจัดการตามสิ่งที่อยู่ในนั้น และหัวข้อ รายการ และตารางออกมาเป็นโครงสร้าง Markdown จริง
What you get
- หน้าที่มีชั้นข้อความอ่านโดยตรง ส่วนเอกสารสแกนและรูปภาพผ่าน OCR โดยอัตโนมัติ
- การดึง URL ทำงานจากเซิร์ฟเวอร์ของเรา โดยบล็อกที่อยู่ภายในและที่อยู่ส่วนตัว
- ตัวแปลงสาธารณะ: สูงสุด 10 MB และ 25 หน้า ไม่ต้องเข้าสู่ระบบ
- แพ็กเกจที่เข้าสู่ระบบจะเพิ่มขีดจำกัดทั้งสอง สูงสุด 200 MB และ 200 หน้าใน Pro
What happens
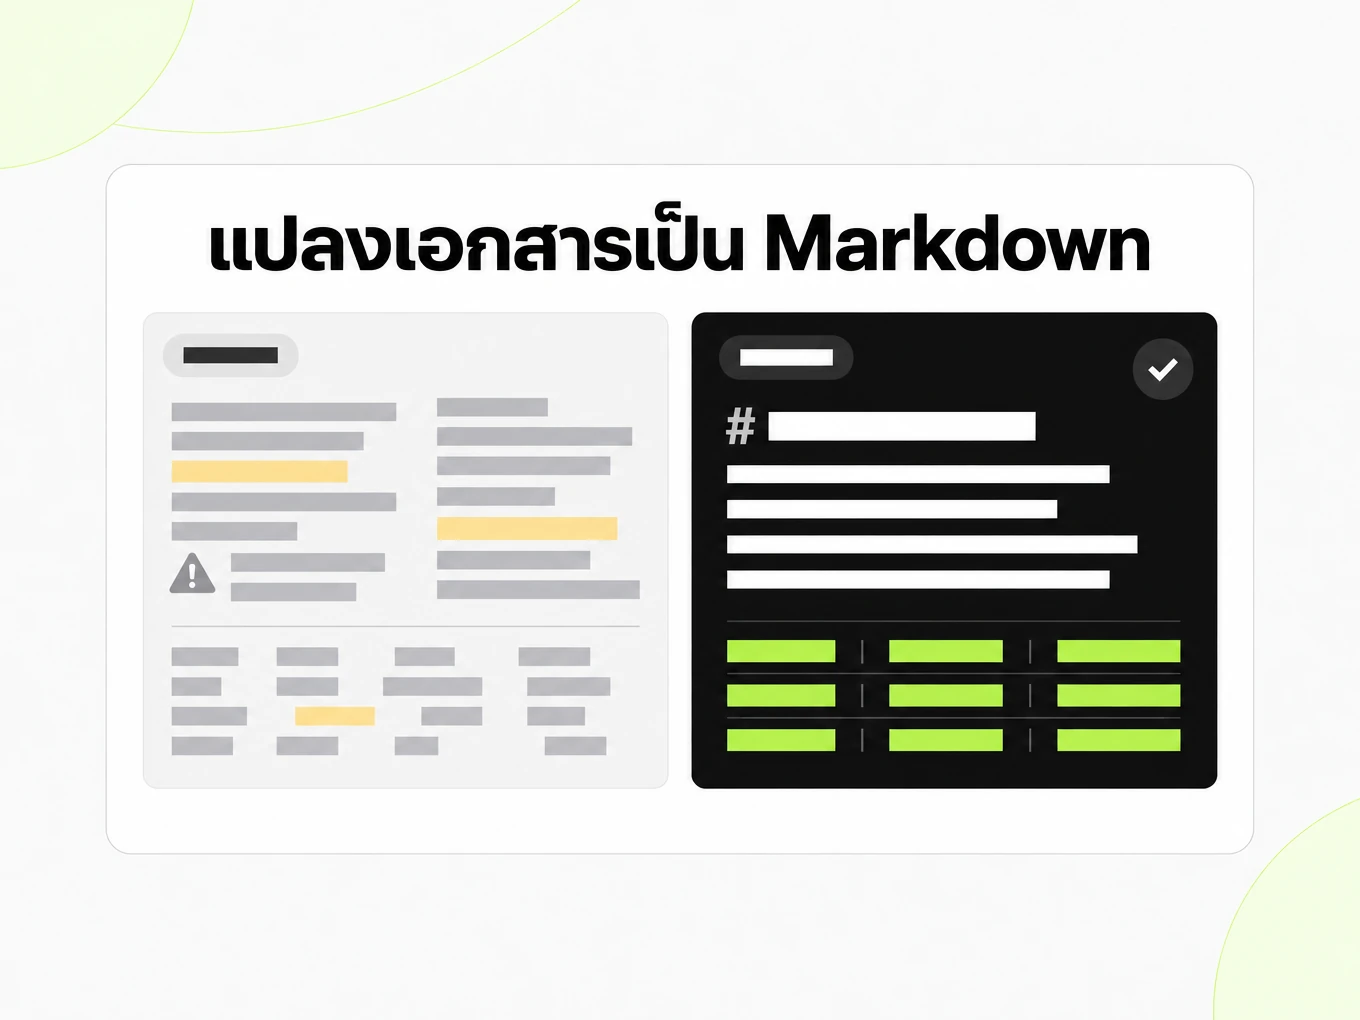
ตัวแสดงผลวางเอกสารต้นฉบับและ Markdown ที่สร้างขึ้นไว้ข้างกัน คุณจึงตรวจสอบหัวข้อ ตาราง และลำดับการอ่านได้ก่อนนำผลลัพธ์ไปใช้ สลับระหว่างตัวอย่างที่เรนเดอร์แล้วกับ Markdown ดิบเพื่อดูว่าสิ่งที่โมเดลหรือไปป์ไลน์จะได้รับคืออะไรกันแน่
What you get
- ต้นฉบับและ Markdown แสดงเคียงกันในตัวแสดงผล
- สลับบานหน้าต่าง Markdown ระหว่างตัวอย่างที่เรนเดอร์แล้วกับซอร์สดิบ
- คัดลอกผลลัพธ์ได้ฟรี ไม่ต้องมีบัญชี
- ดาวน์โหลดไฟล์ .md ได้เมื่อเข้าสู่ระบบแล้ว
What happens
ค่าตั้งที่ใช้ได้ผลกับไฟล์เดียวสามารถใช้ต่อกับไฟล์เป็นชุดหรือการเรียกผ่านไปป์ไลน์ได้ และทุกผลลัพธ์จะอยู่ในคลังของคุณ แบตช์ติดตามแต่ละไฟล์ด้วยสถานะและการลองใหม่ของตัวเอง ส่วน API ส่ง Markdown ชุดเดียวกันให้โค้ดของคุณโดยตรง
What you get
- ใช้เอนจินแยกวิเคราะห์ชุดเดียวกันทั้งเว็บแอป แบตช์ (ZIP หรือรายการ URL) และ API
- POST /v1/convert/{name} คืนค่า Markdown ในการเรียกครั้งเดียวภายใน 60 วินาที หรือคืนค่าการแปลงที่คุณโพลหรือรับผ่าน webhook
- คลังเก็บแต่ละครั้งตามช่วงประวัติของแพ็กเกจคุณ: 30, 60 หรือ 90 วัน
เครดิต
ความแม่นยำของ Markdown คิดราคาต่อหน้า
ใบแจ้งหนี้ที่มีชั้นข้อความกับงบดุลที่สแกนมาราคาต่อหน้าเท่ากัน เพราะไปป์ไลน์เลือกการดึงข้อมูลโดยตรงหรือ OCR ให้คุณเอง ส่วน AI เสริมสำหรับแผนภูมิและรูปภาพเป็นตัวเลือกเสริมที่คิดแยกต่างหาก
- ต่อหน้า ข้อความหรือสแกน
- 1 เครดิต
- ต่อหน้า ข้อความหรือสแกน
PDF ที่มีชั้นข้อความ ไฟล์ Office และ HTML
OCR สำหรับหน้าสแกน ภาพถ่าย และภาพหน้าจอ
อธิบายแผนภูมิและรูปประกอบใน PDF · แพ็กเกจแบบชำระเงิน
อธิบายเนื้อหาในภาพ ไม่ใช่แค่ OCR · แพ็กเกจแบบชำระเงิน
Markdown API
Markdown API สำหรับไปป์ไลน์ RAG ของคุณ
- ใช้ไปป์ไลน์แยกวิเคราะห์ชุดเดียวกับเว็บแอป
- ประมวลผลไฟล์หลายพันไฟล์เป็นชุด พร้อม webhook เมื่อเสร็จ
- API key ที่กำหนดขอบเขตได้ และบันทึกกิจกรรมครบถ้วน
- Markdown ในการเรียกครั้งเดียว หรือคืนค่าการแปลงให้โพลเมื่อไฟล์ใช้เวลามากกว่า 60 วินาที
curl -X POST https://api.markitdown.ai/v1/convert/word \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F file=@vendor-security-review-q3-2026.docx # If HTTP 202, GET the Location URL with the same API key.# Verified local parser output for vendor-security-review-q3-2026.docx:# ## Review Findings# # Risk ratings follow the standard High / Medium / Low scale defined in the vendor risk management policy.# # | Vendor | Risk Rating | Finding | Owner |# | --- | --- | --- | --- |# | CloudScan OCR | Medium | No documented data retention limit on uploaded scans | Security |# | PayBridge | Low | SOC 2 Type II renewed; no open items | Finance |# | LingoTrans API | High | Sub-processor list not disclosed on request | Legal |# | ArchiveNow Storage | Medium | Encryption at rest confirmed; key rotation overdue | Security |ปัญหา
เอกสารยังไม่พร้อมสำหรับ AI
เอกสารส่วนใหญ่ทำมาเพื่อคนและเครื่องพิมพ์ ไม่ใช่เพื่อโมเดลภาษา ก่อนที่ไฟล์จะถูกฝัง ค้นคืน หรือใช้เหตุผลได้ มันต้องกลายเป็นข้อความที่คาดเดาได้ก่อน เรื่องนี้ยากกว่าที่เห็น และเป็นจุดที่การดึงข้อมูลแบบง่าย ๆ ล้มเหลวพอดี
ลำดับการอ่านเสีย
PDF หลายคอลัมน์ หัวกระดาษ และเชิงอรรถสลับปนกัน ข้อความที่ LLM อ่านจึงไม่ตรงกับเอกสารที่คนเห็นอีกต่อไป
ตารางและหัวข้อแบนราบ
การคัดลอกวางทำให้ตารางยุบรวมเป็นตัวเลขยาว ๆ และทิ้งลำดับชั้นหัวข้อที่ให้โครงสร้างกับเอกสาร
เอกสารสแกนต้องใช้ OCR
หน้าแบบรูปภาพและสัญญาที่สแกนมาไม่มีชั้นข้อความเลยจนกว่าจะผ่านการรู้จำอักขระด้วยแสง
ข้อความดิบมีสัญญาณรบกวน
การดึงข้อมูลแบบชั่วคราวทิ้งเลขหน้า การตัดคำผิด และตัวอักษรแปลกปลอมไว้ ปนเปื้อนพรอมป์และผลการค้นคืน
ไปป์ไลน์ RAG และเอเจนต์ต้องการโครงสร้างที่สม่ำเสมอ ไม่ใช่แค่ตัวอักษรที่ดึงออกมา Markdown ที่คาดเดาได้คือสิ่งที่ทำให้การแบ่งชิ้น การฝัง และการค้นคืนทำงานเหมือนกันในเอกสารหลายพันไฟล์ แทนที่จะล้มเหลวเงียบ ๆ กับไฟล์ที่ยุ่งเหยิง ตัวแยกวิเคราะห์ที่จัดการไฟล์ที่ยุ่งเหยิงได้นั่นแหละที่ทำให้ไฟล์สะอาดน่าเชื่อถือ
รูปแบบขาเข้า
แปลงเอกสารเป็น Markdown ได้ทุกแบบ
ทุกรูปแบบขาเข้ามีหน้าตัวแปลงของตัวเอง พร้อมขีดจำกัด หมายเหตุรูปแบบ และตัวอย่างผลลัพธ์ ทุกหน้าใช้เอนจินแยกวิเคราะห์ชุดเดียวกัน เลือกหน้าที่ตรงกับไฟล์ของคุณ:
- PDF เป็น Markdown — รายงาน บทความ คู่มือ และสัญญา PDF ที่มีข้อความจริงจะถูกแยกวิเคราะห์โดยตรงพร้อมประกอบลำดับการอ่านหลายคอลัมน์กลับคืน ส่วน PDF ที่สแกนจะผ่าน OCR ทีละหน้า
- Word เป็น Markdown — ไฟล์ .docx และ .doc รุ่นเก่า โดยเก็บหัวข้อ รายการ ตาราง และความเห็นไว้ ทำให้ประกาศหรือสเปกอ่านเป็นโครงร่างแทนที่จะเป็นก้อนเดียว
- PPT เป็น Markdown — ไฟล์นำเสนอ .pptx และ .ppt ทีละสไลด์ โดยชื่อสไลด์เป็นหัวข้อ และเก็บหัวข้อย่อยกับตารางไว้ ทำให้เด็ค 40 สไลด์ค้นหาได้
- Excel เป็น Markdown — เวิร์กบุ๊ก .xlsx และ .xls ที่แต่ละชีตกลายเป็นตาราง Markdown ภายใต้ชื่อชีตของมัน
- รูปภาพเป็น Markdown — ภาพหน้าจอและเอกสารสแกน PNG และ JPG ผ่าน OCR ส่วน AI ทำความเข้าใจรูปภาพเป็นตัวเลือกแยกที่ต้องเข้าสู่ระบบ
- HTML เป็น Markdown — หน้าที่บันทึกไว้ ไฟล์ส่งออก และเศษโค้ด โดยตัดสคริปต์และสไตล์ออก และเก็บโครงสร้างบทความ ลิงก์ และตารางไว้
- URL เป็น Markdown — วางที่อยู่เว็บสาธารณะแล้วได้หน้าเว็บนั้นเป็น Markdown โดยดึงจากฝั่งเซิร์ฟเวอร์ พร้อมขีดจำกัดขนาดและเวลาหมดอายุ เพื่อไม่ให้ไซต์ที่ช้าทำให้คำขอค้าง
รูปแบบขาออก
จาก Markdown ไปทุกรูปแบบ
Markdown เป็นรูปแบบกลางสลับข้อมูล การแปลงจึงทำย้อนทางได้ด้วย ตัวแก้ไข Markdown ด้านล่างเรนเดอร์ขณะคุณพิมพ์ในเบราว์เซอร์และไม่อัปโหลดข้อความของคุณเลย:
- Markdown เป็น HTML — HTML เชิงความหมายที่สะอาด พร้อมตารางสไตล์ GitHub รายการงาน และการไฮไลต์โค้ด พร้อมวางลง CMS หรืออีเมล
- Markdown เป็นข้อความ — ข้อความล้วนที่หัวข้อ รายการ และตารางถูกทำให้แบนอ่านง่าย สำหรับหน้าต่างแชต ตั๋วงาน และฟอร์ม
- Markdown เป็น PDF — ตัวอย่างก่อนพิมพ์ในเครื่อง ใช้ พิมพ์ / บันทึกเป็น PDF ในเบราว์เซอร์ของคุณ แล้วตรวจหน้าที่บันทึกไว้
การสกัด JSON แบบมีโครงสร้าง และการถอดเสียงและวิดีโอเป็นชั้นที่วางแผนไว้บน Markdown ระบุไว้เป็นโรดแมป ไม่ใช่ฟีเจอร์ที่เปิดให้ใช้แล้ว
กรณีใช้งาน
สร้างมาเพื่อทุกทีม
ตัวแปลง Markdown มีการทดลองใช้แบบไม่ต้องสมัครให้ตรวจผลลัพธ์แรก เหตุผลที่ทีมยังใช้ต่อคือทุกอย่างหลังไฟล์แรก: ประวัติ แบตช์ เอกสารที่ใหญ่ขึ้น และ API ที่ผสานการแปลงเข้ากับระบบที่คุณใช้อยู่แล้ว Markdown ชุดเดียวกันใช้ได้ไม่ว่าผู้บริโภคจะเป็นคน ดัชนีค้นหา หรือโมเดล
RAG และไปป์ไลน์ AI
แปลงเอกสารต้นทางเป็น Markdown ที่สะอาดก่อนแบ่งชิ้น ฝัง หรือประมวลผลด้วยเอเจนต์ โครงสร้างที่คาดเดาได้ทำให้ตัวแบ่งของคุณเห็นหัวข้อและตารางจริง แทนกำแพงข้อความที่ดึงมา ซึ่งช่วยให้การค้นคืนเกี่ยวข้องและพรอมป์ไม่มีสัญญาณรบกวนจากเลย์เอาต์
งานวิจัยและรายงาน
เปลี่ยนบทความ ไวท์เปเปอร์ และสไลด์เป็น Markdown ที่แก้ไขและค้นหาได้ นักวิจัยและนักวิเคราะห์อ้างอิง บันทึก สรุป และนำผลการค้นพบกลับมาใช้ใหม่ได้ โดยไม่ต้องพิมพ์ตารางซ้ำหรือสูญเสียลำดับการอ่านของ PDF ที่แน่นขนัด
เอกสารปฏิบัติการ
ประมวลผลประกาศ สัญญา ใบแจ้งหนี้ และไฟล์ภายในโดยไม่ต้องคัดลอกวางทำความสะอาดด้วยมือ ประวัติ Markdown ที่บันทึกไว้ทำให้งานเอกสารที่เกิดซ้ำตรวจสอบ เทียบ และนำกลับใช้ในงานประจำวันของทีมได้ง่ายขึ้น
ระบบอัตโนมัติสำหรับนักพัฒนา
ใช้ API แปลงไฟล์ภายในงานนำข้อมูลเข้า เครื่องมือภายใน และเวิร์กโฟลว์เอกสาร ส่งคำขอ รับ Markdown แล้วป้อนเข้าสู่ CMS ฐานความรู้ บอตช่วยเหลือ หรือไปป์ไลน์เอเจนต์ ด้วยผลลัพธ์ที่เชื่อถือได้
ฐานความรู้และงานช่วยเหลือ
นำคู่มือผลิตภัณฑ์ บันทึกการออกรุ่น และวิกิภายในมารวมเป็นคลัง Markdown เดียวที่บอตช่วยเหลือหรือผู้ช่วยภายในค้นหาได้ เพราะหัวข้อและตารางยังอยู่ คำตอบจึงชี้ไปยังส่วนที่ถูกต้องแทนที่จะเป็นก้อนขนาดหน้าเว็บ
เอเจนต์และเครื่องมือ
มอบตัวแปลง Markdown สำหรับไฟล์ที่รองรับและ URL สาธารณะให้เอเจนต์ และตรวจสอบว่าทำเสร็จก่อนที่มันจะใช้ผลลัพธ์ อ่านไซต์นี้แบบเดียวกันได้: ทุกหน้าสาธารณะตอบรับ Accept: text/markdown ด้วย Markdown คู่กัน และ llms.txt ระบุไว้ทั้งหมด
คุณภาพผลลัพธ์
เก็บโครงสร้าง ไม่ใช่แค่ข้อความ
ตัวแปลงไฟล์ Markdown ที่มีประโยชน์เก็บรักษามากกว่าตัวอักษรเดี่ยว ๆ จาก PDF เป้าหมายตรงนี้คือ Markdown ที่คงโครงสร้างซึ่งเครื่องมือปลายทางของคุณพึ่งพา โดยผลิตจากไปป์ไลน์แยกวิเคราะห์ฝั่งเซิร์ฟเวอร์ ไม่ใช่การคัดลอกวางในเบราว์เซอร์ที่เปราะบาง
- เก็บหัวข้อ รายการ ตาราง ลิงก์ และลำดับการอ่านในจุดที่ต้นฉบับมี
- จัดการ PDF, Word, PowerPoint, Excel, รูปภาพ, HTML และ URL ผ่านไปป์ไลน์เดียว
- ประมวลผล PDF ที่สแกนและรูปภาพด้วย OCR แล้ววันนี้ คุณภาพการรู้จำขึ้นอยู่กับภาพต้นฉบับ
- รันเอกสารยาวแบบอะซิงโครนัส รายงานและเด็คขนาดใหญ่จึงทำจนจบแทนที่จะหมดเวลา
หน้าเอกสารทั่วไปและหน้า OCR ราคา 1 เครดิตต่อหน้า ส่วนบัญชีที่ใช้แพ็กเกจแบบชำระเงินสามารถใช้ AI ทำความเข้าใจรูปภาพได้ในราคา 5 เครดิตต่อภาพ ผลลัพธ์เป็นไปตาม CommonMark พร้อมตารางสไตล์ GitHub จึงเรนเดอร์ได้ในโปรแกรมดู Markdown ทุกตัว และแยกวิเคราะห์ได้ด้วยไลบรารี Markdown ทุกตัว ทุกการแปลงควรได้ผลงานที่คุณตรวจสอบ บันทึก และนำกลับมาใช้ได้ นั่นคือมาตรฐาน
สามทางเข้า
เบราว์เซอร์ API หรือเอเจนต์
ตัวแปลง Markdown ในเว็บแอปครอบคลุมการแปลงด้วยมือทั้งแบบครั้งเดียวและแบบเกิดซ้ำ แบตช์ครอบคลุมไฟล์เป็นกอง ส่วน API ครอบคลุมทุกอย่างที่ควรเกิดขึ้นอัตโนมัติ รวมถึงเอเจนต์ที่เรียกมันเป็นเครื่องมือ ทั้งสามใช้บัญชีเดียว ยอดเครดิตเดียว และเอนจินแยกวิเคราะห์เดียว ทีมส่วนใหญ่เริ่มในเบราว์เซอร์แล้วย้ายไป API เมื่อการแปลงกลายเป็นส่วนหนึ่งของผลิตภัณฑ์หรือเวิร์กโฟลว์ภายใน
| Aspect | เบราว์เซอร์ | แบตช์ | API |
|---|---|---|---|
| เหมาะกับ | ครั้งละหนึ่งไฟล์ | หลายไฟล์ในการรันครั้งเดียว | ไปป์ไลน์ เครื่องมือ และเอเจนต์ |
| การเข้าสู่ระบบ | ไม่ต้องใช้กับไฟล์แรก | แพ็กเกจแบบชำระเงิน | แพ็กเกจแบบชำระเงิน + API key |
| ข้อมูลเข้า | อัปโหลดหรือ URL | รายการไฟล์อัปโหลดหรือ ID ไฟล์ | อัปโหลด URL ข้อความในบรรทัด หรือ ID ไฟล์ |
| ข้อมูลออก | ดูตัวอย่าง คัดลอก ดาวน์โหลด .md | คลังพร้อมสถานะรายไฟล์ | JSON พร้อม Markdown ผลลัพธ์รายหน้า และ webhook |
| ขีดจำกัด | 10 MB และ 25 หน้าเมื่อไม่เข้าสู่ระบบ | จำนวนงานพร้อมกันตามแพ็กเกจ | 20 ถึง 60 คำขอต่อนาทีตามแพ็กเกจ |
| การรอ | ไม่กี่วินาทีในหน้าเว็บ | ทำงานเบื้องหลัง | ซิงก์ได้ถึง 60 วินาที จากนั้นเป็นการแปลงให้โพล |
เว็บแอป
- อัปโหลดไฟล์หรือวาง URL แล้วดูตัวอย่าง Markdown ที่เรนเดอร์แล้ว
- บันทึกประวัติการแปลงและดาวน์โหลดผลลัพธ์ .md
- แปลงงานที่ทำซ้ำเป็นชุดพร้อมสถานะรายไฟล์
- ติดตามเครดิตและการใช้งานตามแพ็กเกจ
API สำหรับนักพัฒนา
- POST /v1/convert/{name} คืนค่า Markdown ในการเรียกครั้งเดียว หรือคืนค่าการแปลงเมื่อไฟล์ใช้เวลามากกว่า 60 วินาที
- โพลการแปลงหรือรับ webhook เมื่อเสร็จ
- ส่ง Accept: text/markdown เพื่ออ่านหน้าเว็บสาธารณะใด ๆ เป็น Markdown
- สเปกที่เครื่องอ่านได้อยู่ที่ /v1/openapi.json
คำถามที่พบบ่อย
คำถามที่ทีมต่าง ๆ ถามบ่อย
ตัวแปลง Markdown ทำอะไร?
ตัวแปลงเอกสารเป็น Markdown คือเครื่องมือที่อ่าน PDF, Word, PowerPoint, Excel, รูปภาพ หรือหน้าเว็บ แล้วเขียนเนื้อหาใหม่เป็น Markdown: หัวข้อกลายเป็นบรรทัด # ตารางกลายเป็นตารางแบบไปป์ และรายการยังเป็นรายการ สิ่งสำคัญคือข้อความล้วนที่คาดเดาได้ ซึ่งโมเดลภาษา ไปป์ไลน์ RAG และเอเจนต์สามารถแบ่งชิ้น ฝัง และอ้างอิงได้โดยไม่มีสัญญาณรบกวนจากเลย์เอาต์
ตัวแปลงฟรีนั้นฟรีจริงหรือ?
ใช่ หน้าตัวแปลงสาธารณะไม่ต้องมีบัญชีและไม่ต้องใช้บัตร ไฟล์สูงสุด 10 MB และ 25 หน้าแปลงได้ในเบราว์เซอร์ และคุณดูตัวอย่างกับคัดลอก Markdown ได้ การสมัคร Lite, Pro และ Max เริ่มที่ $20 ต่อเดือน และเพิ่มคลังที่บันทึกไว้ แบตช์ และ API
PDF ที่สแกนและรูปภาพทำงานอย่างไร?
หน้าที่มีแต่รูปภาพไม่มีชั้นข้อความ ไปป์ไลน์จึงรัน OCR โดยอัตโนมัติและคืนค่า Markdown เหมือนกับข้อความดิจิทัล หน้าเอกสารทั่วไปและหน้า OCR ราคา 1 เครดิตต่อหน้า คุณภาพการรู้จำขึ้นอยู่กับภาพต้นฉบับ: สแกนที่ 300 dpi อ่านได้ดีกว่าภาพถ่ายหน้าหนึ่งจากมือถือมาก
เรียกใช้จากโค้ดหรือจากเอเจนต์ได้ไหม?
ได้ POST /v1/convert/{name} รับไฟล์อัปโหลด URL หรือข้อความในบรรทัด พร้อม API key และคืนค่า Markdown ในการเรียกครั้งเดียวเมื่อไฟล์เสร็จภายใน 60 วินาที หรือคืนค่าการแปลงที่คุณโพลหรือรับผ่าน webhook ได้ เอเจนต์ขอ Accept: text/markdown บนหน้าเว็บสาธารณะใด ๆ ได้ และสเปกที่เครื่องอ่านได้อยู่ที่ /v1/openapi.json
ไฟล์ของฉันจะเป็นอย่างไรหลังการแปลง?
การลบการแปลงหนึ่งรายการจะนำออกจากคลังของคุณทันที และลบไฟล์ที่จัดเก็บไว้ภายในหนึ่งชั่วโมง ไฟล์ต้นฉบับที่ยังถูกใช้โดยการแปลงอื่นจะถูกเก็บไว้จนกว่าการแปลงนั้นจะถูกลบด้วย การลบบัญชีจะลบไฟล์ต้นฉบับและไฟล์ผลลัพธ์ที่จัดเก็บไว้ทั้งหมด แพ็กเกจแบบชำระเงินเก็บประวัติตามแพ็กเกจ 30, 60 หรือ 90 วัน