
ตัวแปลง
แปลง URL เป็น Markdown
แปลง URL เป็น Markdown คือตัวแปลงฟรีที่เปลี่ยนหน้าเว็บที่เข้าถึงได้แบบสาธารณะให้เป็น Markdown ที่สะอาดของเนื้อหาหลัก — บทความ หน้าเอกสาร หรือกระทู้ โดยไม่มีข้อความนำทางของไซต์ — พร้อมสำหรับ LLM ไปป์ไลน์ RAG และบันทึก ไม่ต้องสมัครเพื่อลอง; การทดลองอนุญาต 3 ครั้งต่อ IP ต่อชั่วโมง และ 10 ครั้งต่อวัน
วิธีใช้
วิธีแปลงหน้าเว็บเป็น Markdown
สิ่งที่คุณวางได้
- หน้า http(s) สาธารณะใดก็ได้ — บทความ เอกสาร โพสต์บล็อก
- หน้าที่อยู่หลังการเข้าสู่ระบบหรือเพย์วอลล์ดึงไม่ได้
- หน้าเว็บถูกดึงบนเซิร์ฟเวอร์ของเรา โดยไม่รัน JavaScript ของมัน
- ลองได้โดยไม่ต้องมีบัญชี: สูงสุด 10 MB และ 25 หน้าต่อไฟล์, 3 ครั้งต่อชั่วโมง และ 10 ครั้งต่อวัน
สิ่งที่ต้องตรวจ
- ดึงฝั่งเซิร์ฟเวอร์ — หน้าเว็บถูกดึงฝั่งเซิร์ฟเวอร์ โดยขอ Markdown ก่อนแล้วจึงขอ HTML; Markdown ของไซต์เองจะถูกใช้ก็ต่อเมื่อผ่านการตรวจสอบคุณภาพ ไม่ต้องใช้ปลั๊กอินเบราว์เซอร์หรือเครื่องมือในเครื่อง
- การสกัดเนื้อหาหลัก — ตัวสกัดหลายตัว — การให้คะแนนความอ่านง่าย การตรวจจับส่วนซ้ำ การวิเคราะห์ความหนาแน่นของข้อความ และองค์ประกอบ main หรือ article ของหน้าเอง — แข่งขันกัน และตัวที่เก็บโครงสร้างและเนื้อความไว้มากที่สุดจะถูกเลือก ไซต์ที่รู้จักดี เช่น เครื่องมือสร้างเอกสาร GitHub และ Wikipedia ใช้กฎเฉพาะไซต์
- หน้าที่เรนเดอร์ด้วย JavaScript — เชลล์แอปพลิเคชันว่างเปล่าจะถูกเรนเดอร์ในเบราว์เซอร์แบบ headless ซึ่งรอให้หน้าเว็บนิ่งแล้วจึงส่ง DOM ที่เรนเดอร์แล้วไปยังการสกัดเนื้อหาเดียวกัน เนื้อหาที่ปรากฏหลังคลิกหรือเลื่อนเท่านั้นจะไม่ถูกจับ
- หน้าสาธารณะ ขนาด และตัวตน — รองรับเฉพาะ URL ที่เข้าถึงได้แบบสาธารณะ: หน้าที่อยู่หลังการยืนยันตัวตน เพย์วอลล์ หรือกำแพงเข้าสู่ระบบดึงไม่ได้ หน้าเว็บที่ดึงอยู่ภายใต้ขีดจำกัดขนาดคำตอบ และ user agent ของตัวดึงมีเอกสารที่ /docs/fetcher
Markdown ไปที่ไหน
- คัดลอก Markdown ตรงจากตัวอย่าง
- ดาวน์โหลดไฟล์ .md และเก็บไว้ในคลังเมื่อเข้าสู่ระบบแล้ว
- แปลงหลายหน้าพร้อมกันด้วยอาร์เรย์ urls บน POST /v1/convert/url
- ทำเป็นอัตโนมัติด้วย POST /v1/convert/url และ API key ของคุณ
ทำไมต้องใช้
ทำไมต้องใช้ตัวแปลง URL เป็น Markdown นี้
หน้าเว็บเขียนขึ้นเพื่อเบราว์เซอร์ Markdown เขียนขึ้นเพื่อคนและโมเดล ตัวแปลงนี้หาส่วนของหน้าที่สื่อความหมาย รักษาโครงสร้างไว้ และทิ้งส่วนตกแต่งของไซต์ไว้ข้างหลัง
เนื้อหาหลัก ไม่ใช่ทั้งหน้า
ตัวสกัดหลายตัวอ่านหน้าเว็บ และผลลัพธ์ที่เก็บเนื้อหาบทความไว้มากที่สุดจะถูกเลือก เมนู แบนเนอร์คุกกี้ ส่วนท้าย และแถบโพสต์ที่เกี่ยวข้องจึงไม่ปรากฏใน Markdown
โครงสร้างที่รอด
หัวข้อ รายการ ตาราง และบล็อกโค้ดออกมาเป็น Markdown และลิงก์หรือพาธรูปภาพแบบสัมพัทธ์ทุกอันจะถูกเขียนใหม่เป็น URL เต็มที่ยังใช้งานได้นอกหน้าเว็บ
หน้าที่ใช้ JavaScript ก็เรนเดอร์ได้
เมื่อ HTML แรกเป็นเชลล์แอปพลิเคชันว่างเปล่า หน้าเว็บจะถูกเรนเดอร์ในเบราว์เซอร์แบบ headless แล้วแปลงเนื้อหาที่เรนเดอร์แล้วแทน
ลองฟรี ไม่ต้องเข้าสู่ระบบ
ดูตัวอย่างและคัดลอก Markdown ได้โดยไม่ต้องมีบัญชี สูงสุด 3 ครั้งต่อชั่วโมง และ 10 ครั้งต่อวัน เข้าสู่ระบบเพื่อดาวน์โหลดไฟล์ .md
ตัวดึงที่สุภาพและระบุตัวตน
ทุกคำขอระบุตัวเองด้วย user agent ที่มีเอกสารกำกับ และเจ้าของไซต์บล็อกได้ — ดูหน้า fetcher ในเอกสาร
เอนจินเดียวกับ API
ตัวแปลงบนหน้านี้กับ POST /v1/convert/url ใช้โค้ดเดียวกัน สคริปต์จึงแปลงได้สูงสุด 20 URL ต่อการเรียก
ปัญหา
ทำไมหน้าเว็บสดจึงมีสัญญาณรบกวนสำหรับโมเดล
หน้าเว็บมีสัญญาณรบกวน
หน้าเว็บสดฝังเนื้อหาไว้ใต้การนำทาง โฆษณา แบนเนอร์ และสคริปต์ — มักมีปริมาณมากกว่าตัวบทความหลายเท่า
มาร์กอัปยุ่งเหยิง
HTML ที่เขียนด้วยมือและที่สร้างขึ้นไม่ค่อยแมปกับโครงสร้างที่อ่านได้อย่างสะอาด
AI ต้องการบทความ
RAG และเอเจนต์ต้องการบทความ ไม่ใช่เปลือกหน้าล้อมรอบ — และบางหน้าจะแสดงบทความก็ต่อเมื่อ JavaScript ทำงานแล้วเท่านั้น
สิ่งที่เก็บไว้
ตัวแปลง URL นี้ดึงอะไร
- ดึงฝั่งเซิร์ฟเวอร์
- หน้าเว็บถูกดึงฝั่งเซิร์ฟเวอร์ โดยขอ Markdown ก่อนแล้วจึงขอ HTML; Markdown ของไซต์เองจะถูกใช้ก็ต่อเมื่อผ่านการตรวจสอบคุณภาพ ไม่ต้องใช้ปลั๊กอินเบราว์เซอร์หรือเครื่องมือในเครื่องSource: RFC 9110: HTTP Semantics
- การสกัดเนื้อหาหลัก
- ตัวสกัดหลายตัว — การให้คะแนนความอ่านง่าย การตรวจจับส่วนซ้ำ การวิเคราะห์ความหนาแน่นของข้อความ และองค์ประกอบ main หรือ article ของหน้าเอง — แข่งขันกัน และตัวที่เก็บโครงสร้างและเนื้อความไว้มากที่สุดจะถูกเลือก ไซต์ที่รู้จักดี เช่น เครื่องมือสร้างเอกสาร GitHub และ Wikipedia ใช้กฎเฉพาะไซต์Source: HTML Living Standard: the main element
- หน้าที่เรนเดอร์ด้วย JavaScript
- เชลล์แอปพลิเคชันว่างเปล่าจะถูกเรนเดอร์ในเบราว์เซอร์แบบ headless ซึ่งรอให้หน้าเว็บนิ่งแล้วจึงส่ง DOM ที่เรนเดอร์แล้วไปยังการสกัดเนื้อหาเดียวกัน เนื้อหาที่ปรากฏหลังคลิกหรือเลื่อนเท่านั้นจะไม่ถูกจับSource: HTML Living Standard
- หน้าสาธารณะ ขนาด และตัวตน
- รองรับเฉพาะ URL ที่เข้าถึงได้แบบสาธารณะ: หน้าที่อยู่หลังการยืนยันตัวตน เพย์วอลล์ หรือกำแพงเข้าสู่ระบบดึงไม่ได้ หน้าเว็บที่ดึงอยู่ภายใต้ขีดจำกัดขนาดคำตอบ และ user agent ของตัวดึงมีเอกสารที่ /docs/fetcherSource: product pipeline
ตัวอย่าง: โพสต์บล็อก markitdown.ai ผ่านการดึง URL· https://markitdown.ai/blog/why-pdfs-break-llms
# Why PDFs break LLMs — and what clean Markdown fixes _Published 2026-06-12 · The markitdown.ai team_ > A PDF that looks perfect to a human often falls apart the moment a model reads it. Here's what goes wrong, and why converting to clean Markdown first makes downstream AI far more reliable. A PDF renders perfectly for a human and falls apart the moment a model reads it. The page you see — columns, tables, headers, footnotes — is a *visual* arrangement, not a logical one. When you pull raw text out of it, that visual order rarely survives, and whatever you feed a language model is only as good as the text it actually receives. ## What actually goes wrong When teams pipe documents straight into an LLM or a retrieval index, a few failure modes show up again and again: - **Reading order breaks.** Multi-column layouts interleave. A two-column page becomes "line 1 left, line 1 right, line 2 left, line 2 right…", so a sentence a human reads top-to-bottom arrives at the model scrambled.- **Tables collapse.** Copy-paste turns a table into a loose run of numbers. The relationship between a header and its cell — the entire point of a table — is gone.- **Headings disappear.** The visual hierarchy (this is a section, this is a subsection) is encoded as font size and weight, not structure. Strip the styling and you get one undifferentiated wall of text. กรณีใช้งาน
กรณีใช้งานของการแปลงเว็บไซต์เป็น Markdown
ตั้งแต่เอเจนต์ AI ไปจนถึงการย้ายเนื้อหา การแปลงหน้าเว็บเป็น Markdown เป็นก้าวเล็ก ๆ ที่หลายเวิร์กโฟลว์ต้องพึ่งพา
ไปป์ไลน์ AI และ LLM
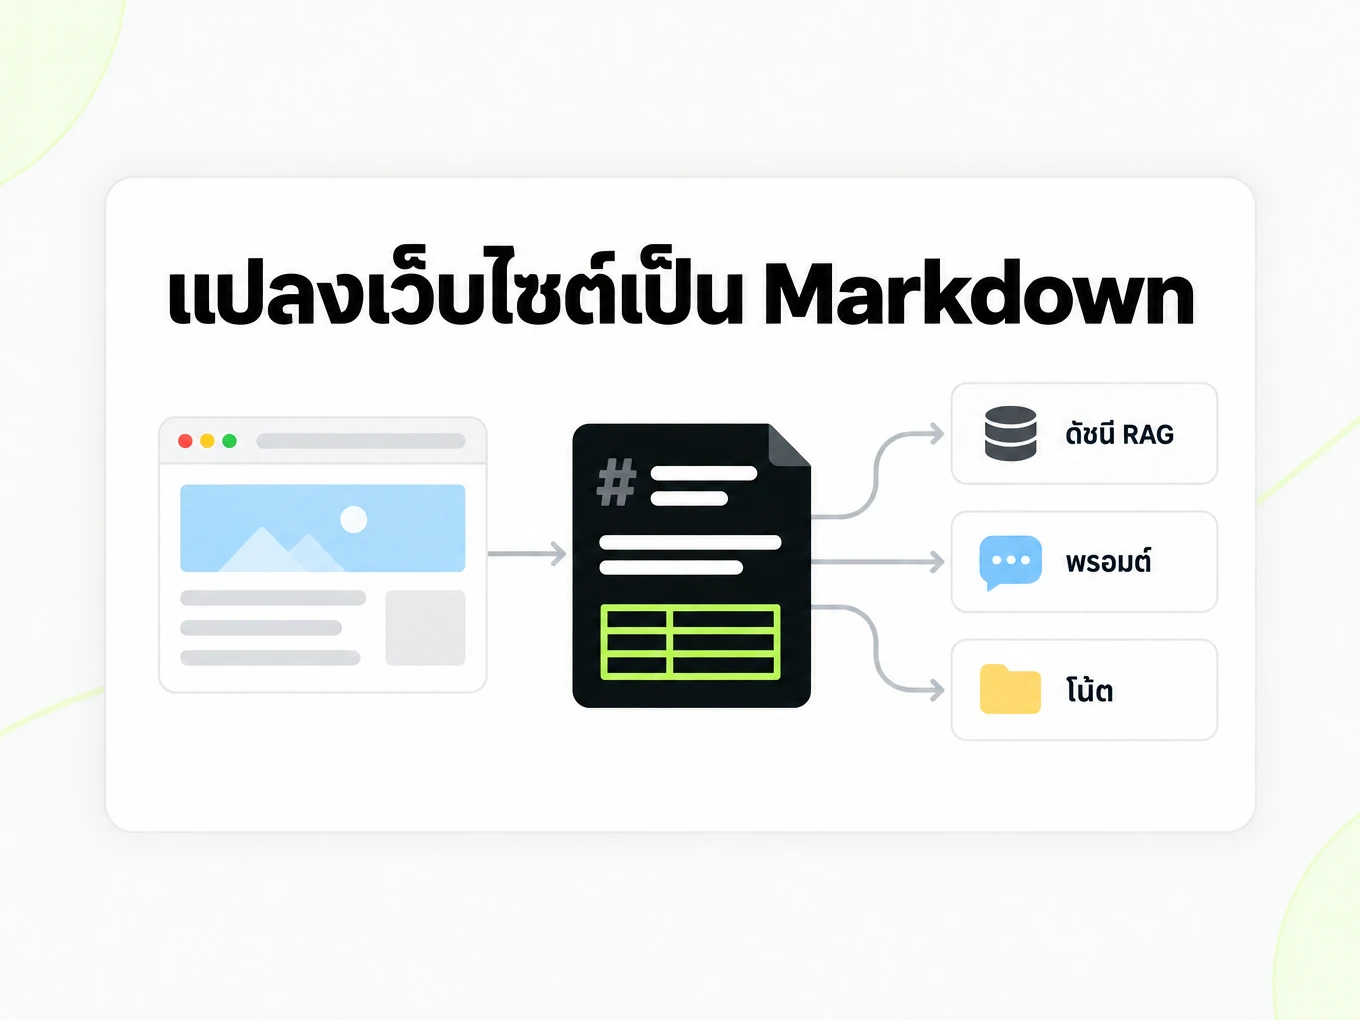
ป้อนบทความและเอกสารเข้าดัชนี RAG เครื่องมือเอเจนต์ และพรอมป์เป็นข้อความสะอาดที่หัวข้อยังอยู่ครบ แทน HTML ดิบ
งานวิจัยและบันทึก
บันทึกต้นทางเป็น Markdown เพื่ออ้างอิง จดบันทึก หรือเก็บใน Obsidian หรือที่เก็บบันทึก — โดยลิงก์ต้นฉบับยังอยู่
ทีมเนื้อหา
ย้ายโพสต์และหน้าศูนย์ช่วยเหลือจาก CMS หนึ่งไปอีก CMS หนึ่ง หรือดึงวัสดุอ้างอิงเข้าสู่ไซต์เอกสารที่ใช้ Markdown
นักพัฒนา
เรียก API จากงานนำข้อมูลเข้าและตัวรวบรวมข้อมูลที่คุณใช้อยู่ และได้ Markdown ชุดเดียวกับที่ตัวแปลงในเบราว์เซอร์แสดง
API
URL เป็น Markdown API สำหรับนักพัฒนา
แปลงหน้าเว็บจากโค้ด? ส่ง URL หนึ่งรายการ — หรือสูงสุด 20 รายการในอาร์เรย์ urls — ไปที่ POST /v1/convert/url พร้อม API key ของคุณ ตั้งค่า render เป็น auto, force หรือ skip เพื่อควบคุมการเรนเดอร์ JavaScript และตั้ง frontmatter เป็น true เพื่อใส่ชื่อหน้า ผู้เขียน และวันที่เผยแพร่ไว้ใน YAML front matter Markdown จะกลับมาในคำตอบเดียวกันเมื่อหน้าเว็บเสร็จภายในหน้าต่างรอ; ไม่เช่นนั้นคุณจะได้การแปลงให้โพล หรือ webhook เมื่อมันเสร็จ การเข้าถึง API อยู่ในแพ็กเกจแบบชำระเงิน
อ่านคู่มือ APIcurl -X POST https://api.markitdown.ai/v1/convert/url \ -H "x-api-key: mdai_…" \ -H "content-type: application/json" \ -d '{"url":"https://markitdown.ai/blog/why-pdfs-break-llms","frontmatter":true}'คู่มือ
ทบทวนผลลัพธ์
ทบทวนผลลัพธ์ URL เป็น Markdown ข้างหน้าเว็บสาธารณะที่คุณส่งไป ตัวแปลงเก็บเนื้อหาหลักและตัดการนำทาง ประกาศคุกกี้ และลิงก์ส่วนท้ายออก แต่หน้าที่ไม่มีบทความชัดเจน — หน้าผลิตภัณฑ์ หน้า landing หรือหน้าแรกที่มีตัวอย่างเนื้อหาจำนวนมาก — ก็ยังอาจขาดแผงด้านข้างหรือเก็บบล็อกที่คุณไม่อยากอ้างอิงไว้ ตรวจย่อหน้าแรกและย่อหน้าสุดท้ายเทียบกับหน้าเว็บก่อนนำผลลัพธ์ไปทำดัชนี หน้าที่สร้างเนื้อหาด้วย JavaScript จะถูกเรนเดอร์ในเบราว์เซอร์ก่อน; แต่หน้าที่โหลดข้อความหลังคลิก เลื่อน หรือเข้าสู่ระบบเท่านั้นยังคงจับไม่ได้ เมื่อไซต์มี Markdown ของตัวเองให้กับไคลเอนต์ที่ร้องขอ ตัวแปลงจะใช้เวอร์ชันนั้นถ้าผ่านการตรวจสอบคุณภาพ และย้อนกลับไปใช้หน้า HTML เมื่อมันดูเหมือนเมนูทั้งไซต์หรือข้อมูลอาร์ไคฟ์ทั้งชุด เก็บ URL ต้นทางไว้กับ Markdown เพื่อให้ผู้อ่านย้อนกลับไปยังหน้าเดิมได้
เก็บบริบทของต้นทาง
เก็บ URL ที่ส่งและวันที่ดึงของคุณไว้กับผลลัพธ์ URL เป็น Markdown ในเวิร์กโฟลว์ของคุณ หน้าเว็บสาธารณะเปลี่ยนได้หลังคุณแปลง ดังนั้นผู้เข้าชมภายหลังอาจเห็นย่อหน้าที่แก้แล้ว เมื่อเปิดใช้ front matter ผลลัพธ์จะเริ่มด้วย URL ต้นทาง canonical URL ชื่อเรื่อง และ — เมื่อหน้าเว็บระบุไว้ — ผู้เขียน วันที่เผยแพร่ คำอธิบาย ชื่อไซต์ ภาษา และภาพหลัก ซึ่งอ่านมาจากเมตาแท็ก structured data และ byline ของหน้า ฟิลด์เหล่านี้แค่พูดซ้ำสิ่งที่หน้าเว็บระบุเกี่ยวกับตัวเอง; ตรวจสอบที่ต้นทางถ้างานวิจัยของคุณต้องพึ่งพามัน ฟิลด์ metadata ของ API ต่างออกไป: มันบรรจุเฉพาะบริบทที่คุณจัดหาเท่านั้น ก่อนอ้างอิงตารางหรือย่อหน้า ให้เทียบกับหน้าและเก็บบริบทแวดล้อมพอที่จะไม่เปลี่ยนความหมายของมัน Markdown ทำให้เนื้อหาเว็บนำไปใช้ซ้ำง่ายขึ้น; ไม่ได้ยืนยันว่าหน้าถูกต้องหรือคุณมีสิทธิ์เผยแพร่ซ้ำหรือไม่
HTML ที่บันทึกกับ URL
เลือกตัวแปลง HTML เมื่อคุณมีสแนปช็อตของหน้าที่ต้องการประมวลผลอยู่แล้ว เลือก URL เป็น Markdown เมื่อที่อยู่ที่เข้าถึงได้แบบสาธารณะเป็นข้อมูลเข้าของการแปลงปัจจุบัน สองอย่างนี้เป็นเวิร์กโฟลว์ที่เกี่ยวข้องกันแต่ควบคุมต้นทางต่างกัน: ไฟล์ที่บันทึกตรึงข้อมูลเข้าที่คุณส่งและถูกแปลงทั้งหมด ส่วน URL ขึ้นกับสิ่งที่เว็บไซต์คืนมาตอนที่ร้องขอและถูกลดเหลือเฉพาะเนื้อหาหลัก ไม่มีเส้นทางใดเลี่ยงข้อจำกัดการเข้าถึง ถ้าไซต์ปฏิเสธตัวดึงหรือต้องเข้าสู่ระบบ ให้ใช้วัสดุที่คุณได้รับอนุญาตให้เข้าถึงผ่านเวิร์กโฟลว์ที่เหมาะสม อย่าลอง URL ที่เข้าถึงไม่ได้ซ้ำ ๆ ราวกับว่าการแปลงอีกครั้งจะให้สิทธิ์เข้าถึง
งานวิจัยด้วย LLM
นักวิจัยวางต้นทาง ไม่ใช่ไฟล์ ตัวแปลงนี้ดึง URL ที่คุณส่ง เก็บเนื้อหาบทความหรือเอกสาร และคืนค่า Markdown ที่คุณอ้างอิง แบ่งชิ้น หรือหย่อนลงคลังบันทึกได้ โดยลิงก์ยังคงใช้งานได้ มันเรนเดอร์หน้าที่ใช้ JavaScript เมื่อเซิร์ฟเวอร์ส่งเชลล์ว่างเปล่ามา และไม่เข้าสู่ระบบหลังเพย์วอลล์
- รองรับเฉพาะ URL ที่เข้าถึงได้แบบสาธารณะ
- ตัวดึงระบุตัวตน; ผู้ดูแลสามารถปฏิเสธ user agent ได้ — ดู /docs/fetcher
- ไฟล์ HTML ที่บันทึกควรใช้ /html-to-markdown ไม่ใช่ที่นี่
ตัวแปลง Markdown อื่น ๆ
- PDF → Markdownข้อความ ตาราง และเอกสารสแกน
- Word → MarkdownDOCX พร้อมหัวข้อและรายการ
- PPT → Markdownข้อความสไลด์ บันทึก และตาราง
- Excel → Markdownทุกชีตเป็นตาราง
- EPUB → Markdownบทของอีบุ๊กเป็นหัวข้อ
- Image → MarkdownOCR สำหรับเอกสารสแกนและภาพหน้าจอ
- HTML → Markdownวางหรืออัปโหลด HTML
- Markdown → HTMLHTML ที่สะอาดและมีความหมาย
- Markdown → Textข้อความล้วนไม่มีมาร์กอัป
- Markdown → PDFพิมพ์เป็น PDF ในเครื่อง
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
คำถามที่พบบ่อย
คำถามที่พบบ่อยเกี่ยวกับ URL เป็น Markdown
แปลง URL เป็น Markdown ทำงานอย่างไร?
แปลง URL เป็น Markdown ดึงหน้าสาธารณะที่คุณวาง เก็บเนื้อหาหลักไว้ และแปลงเป็น Markdown พร้อมลิงก์แบบ URL เต็ม — ไม่มีไฟล์ให้อัปโหลด หน้าที่ต้องใช้ JavaScript จะถูกเรนเดอร์ในเบราว์เซอร์ก่อน
มันลบโฆษณาและการนำทางจากหน้าเว็บสดไหม?
ใช่ สำหรับหน้าที่มีพื้นที่เนื้อหาหลักชัดเจน แปลง URL เป็น Markdown จะเก็บบทความ เนื้อหาเอกสาร หรือกระทู้ไว้ และตัดเมนู แบนเนอร์คุกกี้ และส่วนท้ายออก; หน้า landing หรือหน้าผลิตภัณฑ์ที่ไม่มีบล็อกเนื้อหาหลักเดียวอาจยังเก็บหรือขาดแผงด้านข้างไป จึงควรตรวจผลลัพธ์
มีขีดจำกัดขนาดสำหรับหน้าที่ดึงไหม?
ตัวแปลงสาธารณะทำงานกับหน้าเว็บสาธารณะ หน้าที่ดึงอยู่ภายใต้ขีดจำกัดขนาดคำตอบและอาจถูกปฏิเสธถ้าใหญ่เกินไป
ใช้กับหน้าที่อยู่หลังการเข้าสู่ระบบได้ไหม?
ไม่ได้ รองรับเฉพาะ URL ที่เข้าถึงได้แบบสาธารณะ หน้าที่อยู่หลังการยืนยันตัวตน เพย์วอลล์ หรือกำแพงเข้าสู่ระบบดึงไม่ได้
หน้าที่เรนเดอร์ด้วย JavaScript เป็นอย่างไร?
หน้าที่เรนเดอร์ด้วย JavaScript จะถูกเรนเดอร์ในเบราว์เซอร์แบบ headless เมื่อ HTML แรกเป็นเชลล์ว่างเปล่า แล้วจึงแปลงเหมือนหน้าอื่น ๆ ผ่าน API การตั้งค่า render เป็น force จะเรนเดอร์เสมอ ส่วน skip จะไม่เรนเดอร์เลย ข้อความที่ปรากฏหลังคลิก เลื่อน หรือเข้าสู่ระบบเท่านั้นจะไม่ถูกจับ
แปลงหลาย URL พร้อมกันได้ไหม?
ส่งอาร์เรย์ urls ที่มี URL สาธารณะสูงสุด 20 รายการไปที่ POST /v1/convert/url ติดตามผลแต่ละไฟล์และจัดการคำตอบแบบอะซิงโครนัส ดู /developers
แปลง URL เป็น Markdown ฟรีไหม?
ฟรี การดูตัวอย่างและคัดลอก Markdown ฟรีโดยไม่ต้องมีบัญชี สูงสุด 3 ครั้งต่อชั่วโมง และ 10 ครั้งต่อวัน; การดาวน์โหลดไฟล์ .md ต้องเข้าสู่ระบบ เฉพาะหน้าเว็บสาธารณะ (ห้าม URL ภายในหรือส่วนตัว)
ตัวแปลงเก็บเนื้อหาอะไร?
ตัวแปลงเก็บหัวข้อ ย่อหน้า รายการ ลิงก์ รูปภาพ ตาราง และบล็อกโค้ดของเนื้อหาหลักไว้ โดยลิงก์แบบสัมพัทธ์ถูกเขียนใหม่เป็น URL เต็ม สคริปต์ สไตล์ การนำทาง และส่วนท้ายถูกตัดออก; เมื่อเปิด front matter ชื่อหน้า ผู้เขียน และวันที่เผยแพร่จะอยู่ด้านบนสุด
มี API แปลง URL ไหม?
มี แปลงหน้าเว็บผ่าน URL ด้วยโปรแกรมผ่าน REST API ดู /developers ไฟล์ HTML ที่บันทึกใช้ /html-to-markdown แทน