
Dönüştürücü
PDF'ten Markdown'a dönüştürücü
PDF'ten Markdown'a, çok sütunlu okuma sırasını RAG için yapılandırılmış Markdown'a kuran bir dönüştürücüdür. Herkese açık deneme 10 MB'a kadar dosya kabul eder.
Bir plan seçmeden önce bir dosyayı deneyin.
- Hesap yok: dosya başına 10 MB ve 25 sayfaya kadar, saatte 3 ve günde 10 dönüştürme, tarayıcıda önizleme ve kopyalama.
- Oturum açık: günde 20 ücretsiz dönüştürme, kitaplığınıza kaydedilir.
- Lite, Pro ve Max; dönüştürme kredileri, toplu işleme, API erişimi ve kaydedilmiş geçmiş içerir. Lite 30 günlük geçmiş içerir.
Nasıl yapılır
PDF'ten Markdown'a nasıl dönüştürülür
Neleri yükleyebilirsiniz
- Dosya türleri: .pdf
- Hesapsız deneyin: dosya başına 10 MB ve 25 sayfaya kadar, saatte 3 ve günde 10 dönüştürme
- Lite 100 MB'a, Pro 200 MB'a kadar dosya kabul eder
- Max'in dosya başına boyut sınırı yoktur; dönüştürmeler kredilerle sınırlıdır
Neyi denetlemeli
- Okuma sırasının yeniden kurulması — PDF dönüştürme mantıksal bir okuma sırası yeniden kurmaya çalışır.
- Tablolar ve başlıklar — PDF yapısal üstveri sunduğunda başlık düzeyleri ve tablo verisi korunur; düz metin PDF'ler düz metin çıktısı üretir.
- Taranmış ve yalnızca görsel PDF'ler — Metin katmanı olmayan PDF'ler (taranmış sayfalar ve görsel ekleri) bugün OCR ile işlenir; doğruluk tarama kalitesine bağlıdır.
- Parola korumalı dosyalar — Şifreli PDF'ler ayrıştırılamaz; yüklemeden önce parolayı kaldırın.
Markdown nereye gider
- Markdown'ı doğrudan önizlemeden kopyalayın
- .md dosyasını indirin ve oturum açtıktan sonra kitaplığınızda saklayın
- Bütün klasörleri veya ZIP arşivlerini toplu dönüştürmeyle dönüştürün
- POST /v1/convert/pdf ve API anahtarınızla otomatikleştirin
Neden kullanılır
PDF'ten Markdown'a neden kullanılır
Okunabilir metin olarak raporlar
Bir raporun paragraflarını ve desteklenen yapısını, inceleyebileceğiniz, düzenleyebileceğiniz ve kaynak PDF'in yanında saklayabileceğiniz Markdown'a çevirin.
Taranmış sayfalar için OCR
Yalnızca görsel içeren sayfalar OCR ile tanınabilir. Küçük metni, noktalamayı ve sayısal tabloları özgün taramayla karşılaştırın.
Başlık bağlamı
Notlar ve getirme iş akışları için tanınabilir bölümleri koruyun; görsel olarak biçimlendirilmiş başlıkların doğru yorumlanıp yorumlanmadığını da denetleyin.
Gözden geçirilecek tablolar
Desteklenen tablolar metin tablolarına dönüşür. Dışa aktarılan değerleri kanıt olarak ele almadan önce karmaşık veya birleştirilmiş hücreleri denetleyin.
Yeniden kullanmadan önce önizleyin
Bir pasajı ChatGPT, Claude veya bir dokümantasyon deposuna kopyalamadan önce Markdown kaynağını işlenmiş görünümüyle karşılaştırın.
Tekrarlanabilir bir API yolu
Tarayıcıda temsili çıktıları gözden geçirdikten sonra bir veri alma betiğinde PDF dönüştürme yolunu kullanın.
Sorun
PDF sütunları dil modellerini neden bozar
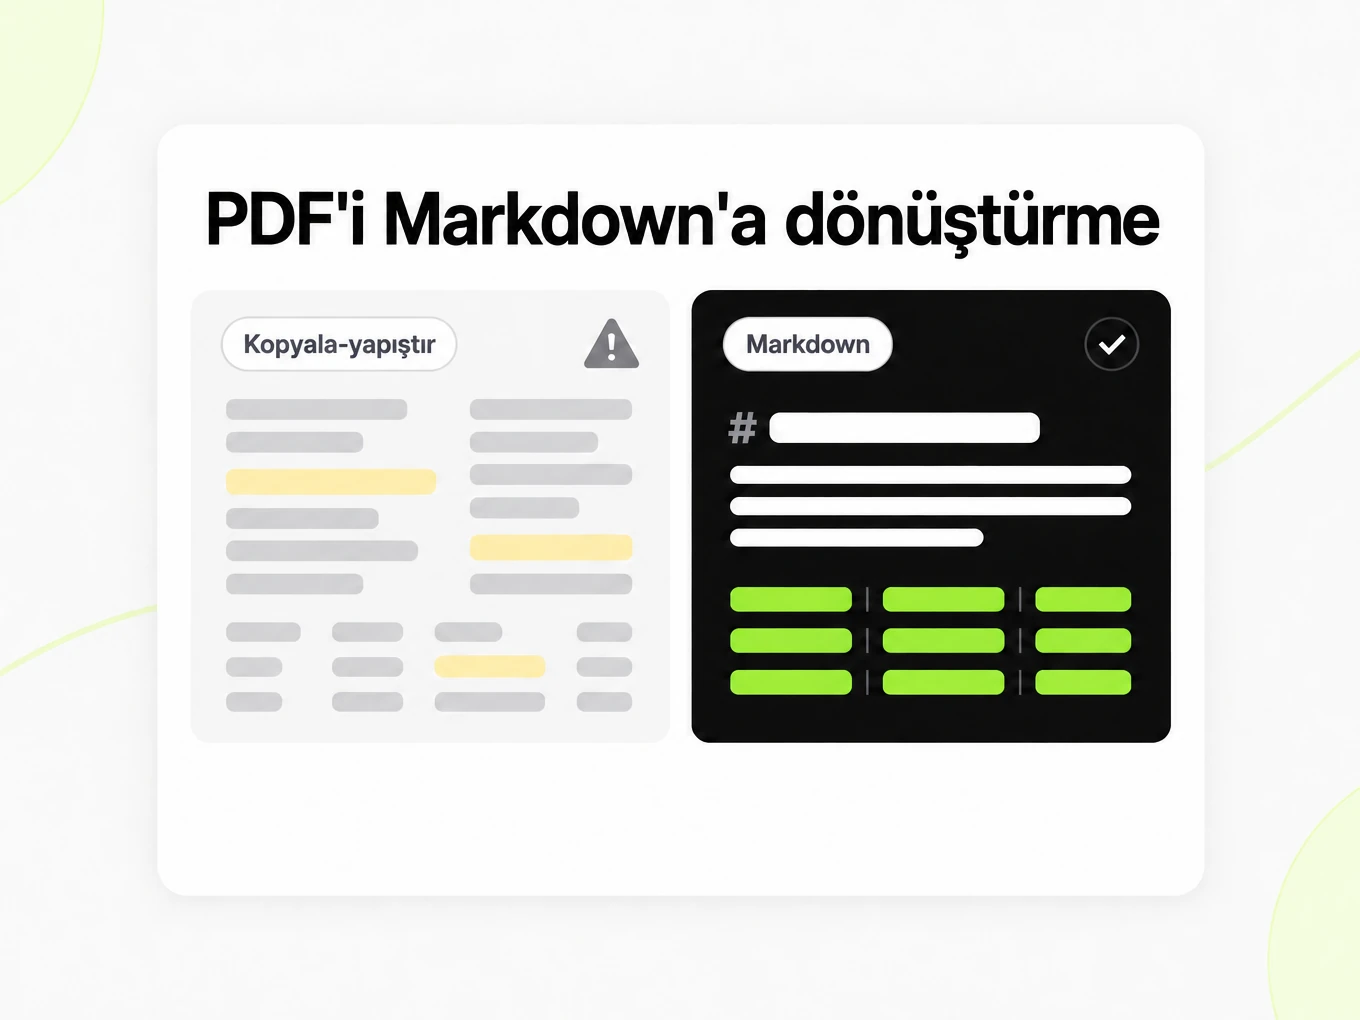
Sütunlar birbirine karışır
Yukarıdan aşağıya okunan iki sütunlu bir rapor, sol ve sağ akışları karıştırır; böylece model, sayfada hiç var olmamış bir cümle görür.
Tablolar ızgarasını kaybeder
Bir PDF'ten kopyala-yapıştır, bir sonuç tablosunu, sonraki bir ayrıştırıcı için başlık satırı olmayan bir sayı dizisine çevirir.
Taramaların metin katmanı yoktur
Yalnızca görsel içeren sayfalar glif değil piksel taşır; bu yüzden taranmış PDF'ler bugün OCR ile işlenir.
Neler korunur
Bu PDF dönüştürücüsü neleri korur
- Okuma sırasının yeniden kurulması
- PDF dönüştürme mantıksal bir okuma sırası yeniden kurmaya çalışır. Sütun geçişlerini özgünle karşılaştırın; özellikle karmaşık raporlar ve makaleler için.Source: ISO 32000-2 (PDF 2.0)
- Tablolar ve başlıklar
- PDF yapısal üstveri sunduğunda başlık düzeyleri ve tablo verisi korunur; düz metin PDF'ler düz metin çıktısı üretir.Source: CommonMark Spec
- Taranmış ve yalnızca görsel PDF'ler
- Metin katmanı olmayan PDF'ler (taranmış sayfalar ve görsel ekleri) bugün OCR ile işlenir; doğruluk tarama kalitesine bağlıdır.Source: product pipeline
- Parola korumalı dosyalar
- Şifreli PDF'ler ayrıştırılamaz; yüklemeden önce parolayı kaldırın.Source: ISO 32000-2 (PDF 2.0)
Örnek: NIST Cybersecurity Framework 2.0, sayfa 15· https://nvlpubs.nist.gov/nistpubs/CSWP/NIST.CSWP.29.pdf
## Appendix A. CSF Core This appendix describes the Functions, Categories, and Subcategories of the CSF Core. Table 1 lists the CSF 2.0 Core Function and Category names and unique alphabetic identifiers. Each Function name in the table is linked to its portion of the appendix. The order of Functions, Categories, and Subcategories of the Core is not alphabetical; it is intended to resonate most with those charged with operationalizing risk management within an organization. The numbering of the Subcategories is intentionally not sequential; gaps in numbering indicate CSF 1.1 Subcategories that were relocated in CSF 2.0. **Table 1. CSF 2.0 Core Function and Category names and identifiers** | Function | Category | Category Identifier || --- | --- | --- || **Govern (GV)** | Organizational Context | GV.OC || | Risk Management Strategy | GV.RM || | Roles, Responsibilities, and Authorities | GV.RR || | Policy | GV.PO || | Oversight | GV.OV || | Cybersecurity Supply Chain Risk Management | GV.SC || **Identify (ID)** | Asset Management | ID.AM || | Risk Assessment | ID.RA || | Improvement | ID.IM || **Protect (PR)** | Identity Management, Authentication, and Access Control | PR.AA || | Awareness and Training | PR.AT || | Data Security | PR.DS || | Platform Security | PR.PS || | Technology Infrastructure Resilience | PR.IR || **Detect (DE)** | Continuous Monitoring | DE.CM || | Adverse Event Analysis | DE.AE | Kullanım durumları
Gerçek iş akışlarında PDF'ten Markdown'a
Araştırma notları
Bir makaleyi düzenlenebilir notlara çıkarın, alıntılanan pasajları doğrulayın ve sonraki inceleme için PDF referansını saklayın.
Rapor veri alma
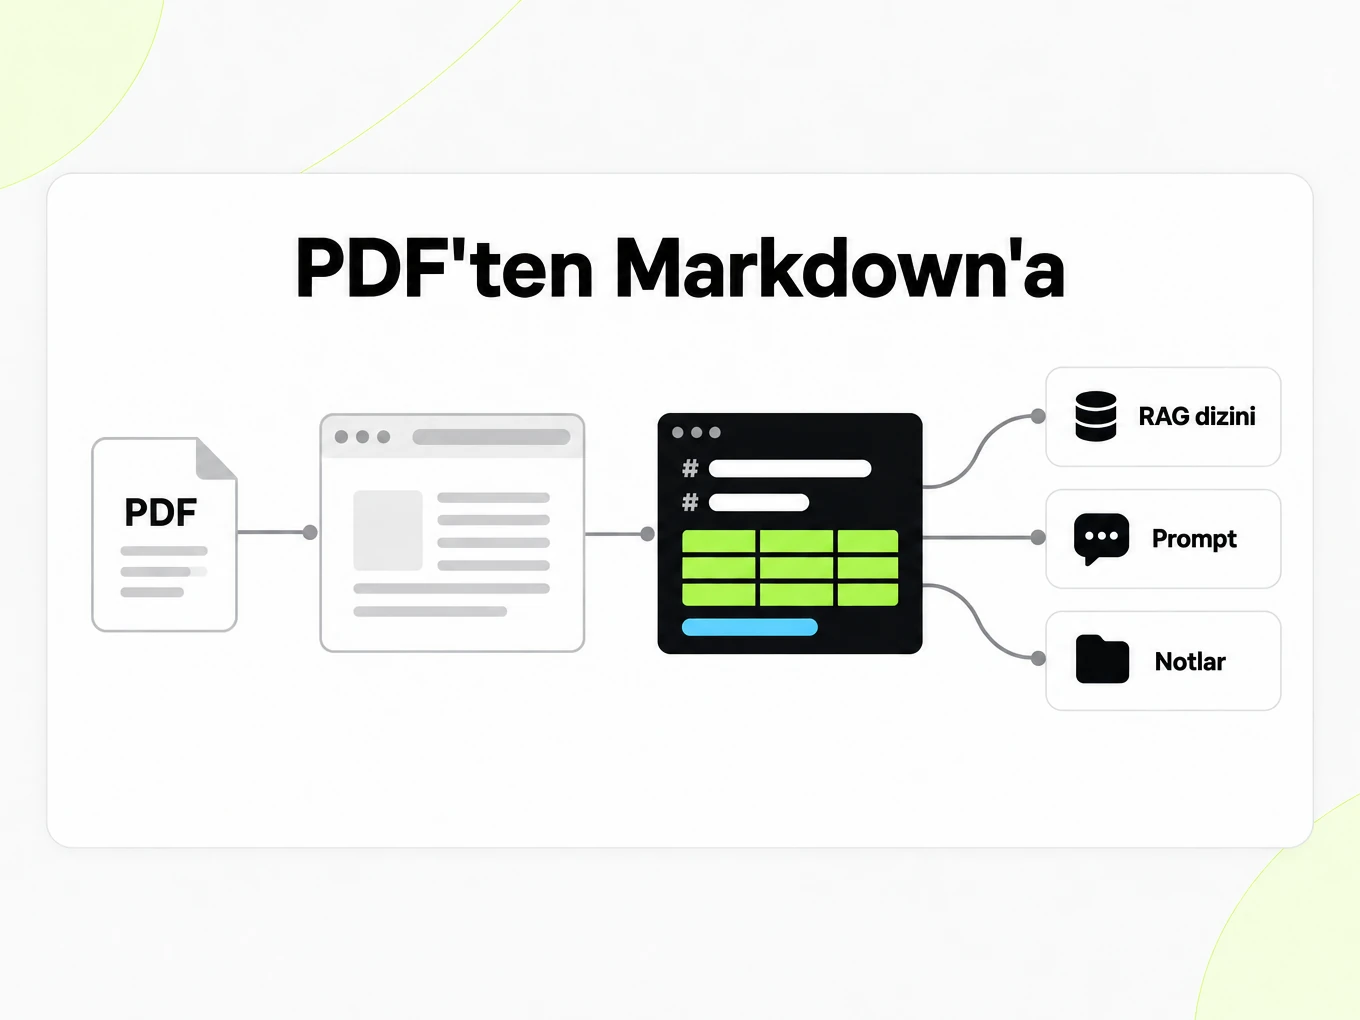
Tablo başlıklarını, bölüm bağlamını ve özgün belgeye bir bağlantıyı korurken raporları parçalamaya hazırlayın.
Politika kitaplıkları
Gözden geçirilmiş bir politikayı aranabilir metne çevirin ve yayımlanmış PDF'i yetkili sürüm olarak koruyun.
Belge değerlendirme
Bir koleksiyonu otomatikleştirmeden önce temsili PDF'leri karşılaştırın; taramalar, sütunlar ve zor bir tablo dahil.
API
PDF'ten Markdown'a API'si
Bir x-api-key başlığı ve desteklenen bir kaynak dosyayla POST /v1/convert/pdf kullanın. Tamamlanan bir istek çıktıları satır içinde döndürebilir; HTTP 202 ise dönüştürmenin hâlâ sürdüğü anlamına gelir. Location yanıt başlığını okuyun ve dosya çıktılarına erişmeden önce onu yoklayın. Bir multipart istek en fazla 100 dosya kabul eder; abonelik ve toplam istek sınırları da geçerlidir. API anahtarlarını sunucu ortamınızda tutun. API erişimi bir Lite, Pro veya Max aboneliği gerektirir.
API kılavuzunu okuyuncurl -i "https://api.markitdown.ai/v1/convert/pdf" \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F "file=@source.pdf"# If HTTP 202, GET the Location URL with the same API key.Kılavuz
Çıktıyı gözden geçirme
PDF'ten Markdown'a çıktısını kanıt olarak kullanmadan önce özgün PDF'le karşılaştırın. Kolay bir başlık sayfası yerine sütunlar, bir dipnot ve bir tablo içeren bir sayfayla başlayın. Bir sütunun son cümlesini ve sonrakinin ilk cümlesini okuyun: PDF'te bir insanın izlediği aynı sırayı oluşturmalıdırlar. Sonra bir tablo başlığını, negatif bir değeri ve bir birimi karşılaştırın. Okunabilir bir Markdown önizlemesi yine de bir OCR ikamesi ya da yanlış yerleştirilmiş bir hücre içerebilir. Belge finansal veya teknik bir karara yön veriyorsa, PDF'i Markdown'ın yanında saklayın ve alıntılamayı düşündüğünüz pasajı doğrulayın. Dönüştürme metinle çalışmayı kolaylaştırır; kaynağı veya transkripsiyonunu belgelemez.
Neler değişir
PDF'ten Markdown'a dönüştürme, görsel konumlandırmayı bir metin yapısıyla değiştirir. Büyük bir başlık bir başlık işaretine dönüşebilir, paragraflar paragraf olur ve desteklenen bir tablo çizgilerle ayrılmış satırlara dönüşür. Sayfa geometrisi, dekoratif çizgiler, yazı tipi seçimleri ve özgün satır kaydırma, çıktı sözleşmesinin parçası değildir. Bu, bir alıntıyı düzenlemek veya bir getirme dizini oluşturmak istediğinizde yararlıdır; ancak amaç bir broşürü birebir çoğaltmaksa uygun değildir. Yetkili düzeni için özgün PDF'i saklayın. Bir düzen basit bir Markdown tablosuyla temsil edilemiyorsa, kısa bir açıklamanın mı yoksa elle gözden geçirilmiş bir tablonun mu sonraki aşama için daha net bir temsil olduğunu denetleyin.
RAG kaynakları
Markdown'ı pasajlara bölerken bağlamı korumak için PDF başlığını ve anlamlı bölüm başlıklarını kullanın. Yalnızca Sonuçlar başlığı taşıyan bir parça, belgeden çıktıktan sonra belirsiz kalabilir; veri alma kodunuz belge adını ve üst başlığı o parçayla birlikte saklayabilir. Bir tablo başlığını satırlarıyla bir arada tutun ve bir listeyi bir koşulun ortasında bölmekten kaçının. Getirilen bir yanıtın okuyucuyu kaynağa geri götürebilmesi için özgün PDF referansını ayrı saklayın. LangChain ve LlamaIndex kendi veri alma sürecinizden metni tüketebilir; ancak ayırıcıyı, gömme modelini ve getirme politikasını seçmek yine uygulamanızın işidir. Getirmeyi, yanıtını PDF'te doğruladığınız sorularla test edin.
PDF'i seçme
Okunabilir metin içerdiğinde özgün PDF çıktısını tercih edin. O PDF'in bir ekran görüntüsü, başka bir görsel tanıma adımı ekler ve dönüştürme başlamadan önce küçük karakterleri kaybedebilir. Taranmış PDF'lerde, döndürülmüş sayfaları düzeltin ve noktalama ile tablo kenarlıklarının normal yakınlaştırmada okunabilir kaldığı bir sürüm kullanın. Şifreli bir PDF'i yüklemeden önce parolayı kaldırın. Uzun bir raporun yalnızca bir kısmı ilgiliyse, ilgili kaynak sayfaları hazırlayın ve notlarınızda özgün referanslarını saklayın. Aynı hasarlı taramayı tekrarlamak, eksik ayrıntıyı düzeltmez; önce kaynağı iyileştirin, sonra yeni PDF'ten Markdown'a çıktısını önceki sonuçla karşılaştırın.
Parça sınırları
Getirme kalitesi, bir insanın okuyacağı belgeyle eşleşen parça sınırlarına bağlıdır. Bu dönüştürücü sütunları yeniden sıralar ve başlık düzeylerini korur; böylece bir ayırıcı, iki sütunlu bir makaleden iç içe geçmiş parçalar yerine pasajlar üretebilir.
- Markdown'ı, parçaladığınız ve gömduğünüz artefakt olarak kullanın; düzleştirilmiş bir metin dökümü olarak değil.
- Standart sayfalar ve OCR sayfaları, oturum açılan planlarda sayfa başına 1 kredi ile faturalanır.
- Parola korumalı dosyaların kilidi yüklemeden önce açılmalıdır; şifreli PDF'ler reddedilir.
Daha fazla Markdown dönüştürücüsü
- Word → MarkdownBaşlıklı ve listeli DOCX
- PPT → MarkdownSlayt metni, notlar ve tablolar
- Excel → MarkdownHer sayfa bir tablo olarak
- Image → MarkdownTaramalar ve ekran görüntüleri için OCR
- HTML → MarkdownHTML yapıştırın veya yükleyin
- URL → MarkdownHerkese açık herhangi bir web sayfası, temizlenmiş
- Markdown → HTMLTemiz, anlamsal HTML
- Markdown → TextBiçimlendirmesiz düz metin
- Markdown → PDFYerel olarak PDF'e yazdırın
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
SSS
PDF'ten Markdown'a soruları
PDF'ten Markdown'a nasıl çalışır?
PDF'ten Markdown'a, desteklenen kaynağı gözden geçirme ve yeniden kullanım için okunabilir Markdown'a çevirir. Anonim deneme, dosya başına 10 MB ve 25 sayfaya kadar kabul eder; IP başına saatte 3, günde 10 dönüştürme yapılabilir. Kullanmadan önce sonucu kaynakla karşılaştırın.
Azami PDF boyutu nedir?
Herkese açık dönüştürücü, 10 MB'a kadar PDF dosyası kabul eder. Lite 100 MB'a kadar dosya destekler; Pro ve Max'ın sınırları daha yüksektir.
Taranmış PDF'leri işler mi?
Evet. Görsel tabanlı PDF'ler bugün OCR ile işlenir; temiz ve yüksek çözünürlüklü taramalar en iyi sonucu verir.
Çok sütunlu araştırma makaleleri işlenir mi?
Evet. PDF'ten Markdown'a okuma sırasını yeniden kurmaya çalışır. Sütun geçişlerini kaynakla karşılaştırın; çünkü karmaşık düzenler yine de düzeltme gerektirebilir.
Finansal tablolar ayakta kalır mı?
Yapısal üstveri taşıyan PDF'lerdeki tablolar Markdown tablolarına dönüştürülür. Düzleştirilmiş görsel tabloların kurtarılması OCR gerektirir.
Parola korumalı PDF'leri dönüştürebilir miyim?
Hayır. Şifreli PDF'ler ayrıştırılamaz. Yüklemeden önce parolayı kaldırın.
Çıktı RAG için parçalamaya yeterince iyi mi?
Markdown, mümkün olduğunda başlıkları, listeleri ve tabloları korur; böylece parçalama ve gömme, kopyala-yapıştıra kıyasla öngörülebilir kalır.
PDF'leri koddan dönüştürebilir miyim?
Evet. Bir API anahtarıyla dosyayı doğrudan /v1/convert/pdf adresine POST edin ve Markdown'ı yanıttan okuyun. /developers sayfasına bakın.
PDF biçimini ölçekli olarak Markdown'a dönüştürün.
Denemesi ücretsiz — kayıt gerekmez.