
Konverter
Konverter PDF ke Markdown
PDF ke Markdown adalah konverter yang menyusun ulang urutan baca multi-kolom menjadi Markdown terstruktur untuk RAG. Uji publik menerima file hingga 10 MB.
Coba satu file sebelum memilih paket.
- Tanpa akun: hingga 10 MB dan 25 halaman per file, 3 konversi per jam dan 10 per hari, dengan pratinjau dan salin di browser.
- Dengan sesi: 20 konversi gratis per hari, tersimpan di pustaka Anda.
- Lite, Pro, dan Max mencakup kredit konversi, pemrosesan batch, akses API, dan riwayat tersimpan. Lite mencakup riwayat 30 hari.
Cara kerja
Cara mengonversi PDF ke Markdown
Apa yang bisa Anda unggah
- Jenis file: .pdf
- Coba tanpa akun: hingga 10 MB dan 25 halaman per file, 3 konversi per jam dan 10 per hari
- Lite menerima file hingga 100 MB, Pro hingga 200 MB
- Max tidak punya batas ukuran per file; konversi dibatasi oleh kredit
Apa yang perlu diperiksa
- Rekonstruksi urutan baca — Konversi PDF berupaya menyusun ulang urutan baca yang logis.
- Tabel dan judul — Tingkat judul dan data tabular dipertahankan saat PDF menampilkan metadata struktural; PDF teks biasa menghasilkan keluaran teks biasa.
- PDF hasil pindai dan hanya gambar — PDF tanpa lapisan teks (halaman hasil pindai dan gambar yang disisipkan) diproses dengan OCR hari ini; akurasinya bergantung pada kualitas hasil pindainya.
- File yang dilindungi kata sandi — PDF terenkripsi tidak bisa diuraikan; hapus kata sandinya sebelum diunggah.
Ke mana Markdown pergi
- Salin Markdown langsung dari pratinjau
- Unduh file .md dan simpan di pustaka Anda setelah masuk
- Konversi folder penuh atau arsip ZIP dengan Konversi batch
- Otomatiskan dengan POST /v1/convert/pdf dan kunci API Anda
Mengapa memakainya
Mengapa memakai PDF ke Markdown
Laporan sebagai teks yang terbaca
Ubah paragraf dan struktur laporan yang didukung menjadi Markdown yang bisa Anda periksa, sunting, dan simpan bersama PDF sumbernya.
OCR untuk halaman hasil pindai
Halaman yang hanya berisi gambar bisa dikenali dengan OCR. Bandingkan teks kecil, tanda baca, dan tabel numeriknya dengan hasil pindai aslinya.
Konteks judul
Pertahankan bagian yang bisa dikenali untuk catatan dan alur pengambilan, sekaligus periksa apakah judul bergaya visual sudah ditafsirkan dengan benar.
Tabel untuk ditinjau
Tabel yang didukung berubah menjadi tabel teks. Tinjau sel yang rumit atau gabungan sebelum memperlakukan nilai yang diekspor sebagai bukti.
Pratinjau sebelum dipakai lagi
Bandingkan kode Markdown dengan tampilan yang dirender sebelum menyalin bagian ke ChatGPT, Claude, atau repositori dokumentasi.
Jalur API yang bisa diulang
Pakai jalur konversi PDF di skrip pengambilan data setelah memeriksa hasil yang representatif di browser.
Masalahnya
Mengapa kolom PDF merusak model bahasa
Kolom saling menyelip
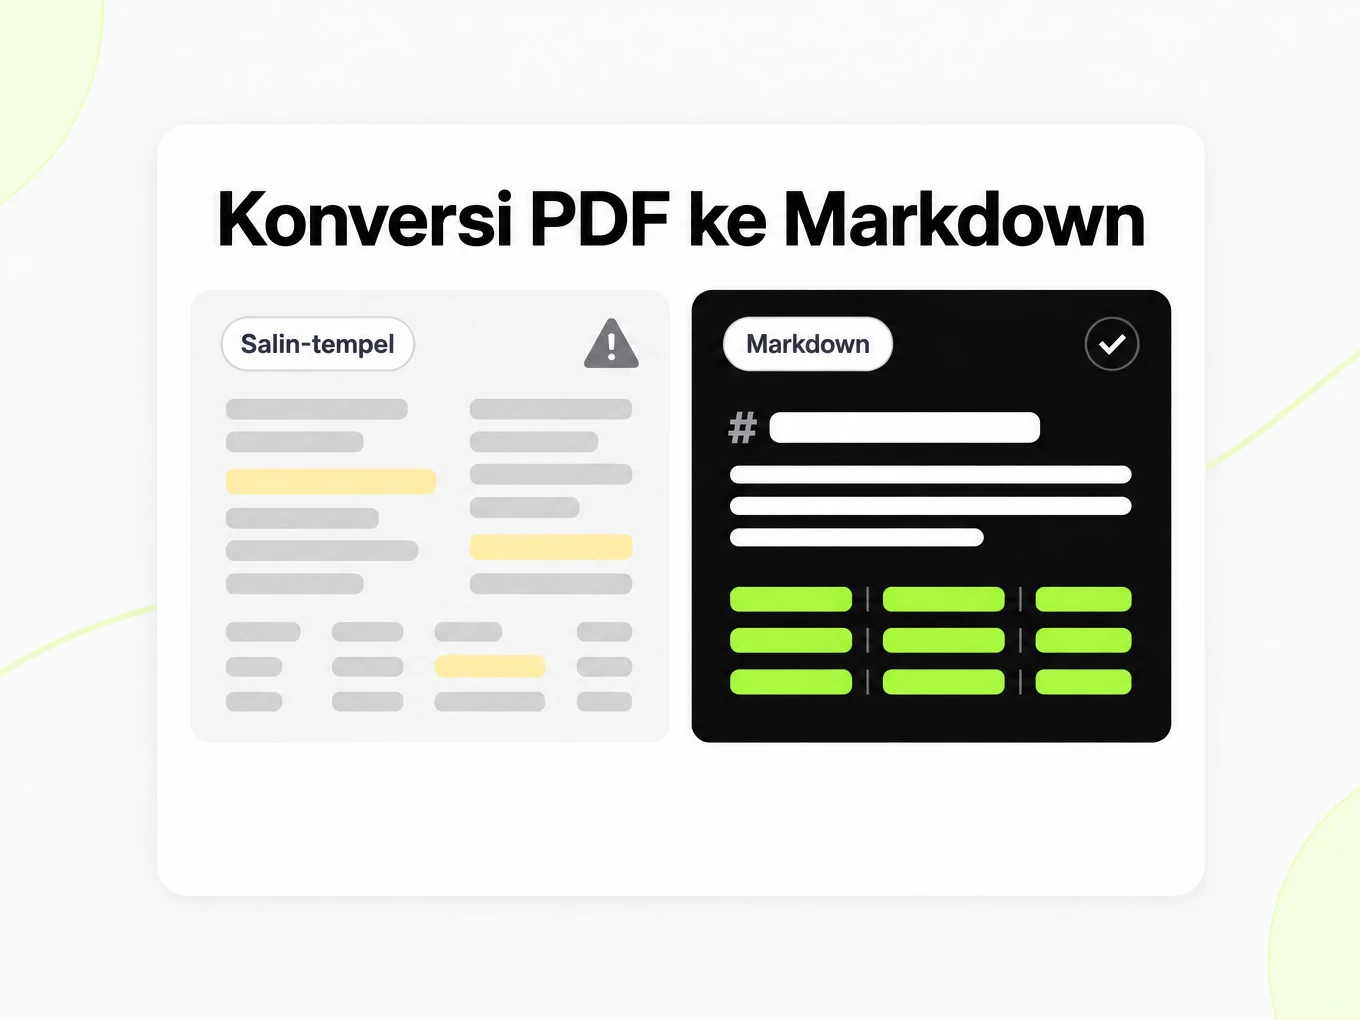
Laporan dua kolom yang dibaca dari atas ke bawah mencampur aliran kiri dan kanannya, sehingga model melihat kalimat yang tidak pernah ada di halaman itu.
Tabel kehilangan kisinya
Salin-tempel dari PDF mengubah tabel hasil menjadi rangkaian angka tanpa baris judul untuk parser setelahnya.
Hasil pindai tidak punya lapisan teks
Halaman yang hanya berisi gambar memuat piksel, bukan glif, sehingga PDF hasil pindai diproses dengan OCR hari ini.
Apa yang dipertahankan
Apa yang dipertahankan konverter PDF ini
- Rekonstruksi urutan baca
- Konversi PDF berupaya menyusun ulang urutan baca yang logis. Periksa transisi antarkolom terhadap aslinya, terutama pada laporan dan artikel yang rumit.Source: ISO 32000-2 (PDF 2.0)
- Tabel dan judul
- Tingkat judul dan data tabular dipertahankan saat PDF menampilkan metadata struktural; PDF teks biasa menghasilkan keluaran teks biasa.Source: CommonMark Spec
- PDF hasil pindai dan hanya gambar
- PDF tanpa lapisan teks (halaman hasil pindai dan gambar yang disisipkan) diproses dengan OCR hari ini; akurasinya bergantung pada kualitas hasil pindainya.Source: product pipeline
- File yang dilindungi kata sandi
- PDF terenkripsi tidak bisa diuraikan; hapus kata sandinya sebelum diunggah.Source: ISO 32000-2 (PDF 2.0)
Contoh: NIST Cybersecurity Framework 2.0, halaman 15· https://nvlpubs.nist.gov/nistpubs/CSWP/NIST.CSWP.29.pdf
## Appendix A. CSF Core This appendix describes the Functions, Categories, and Subcategories of the CSF Core. Table 1 lists the CSF 2.0 Core Function and Category names and unique alphabetic identifiers. Each Function name in the table is linked to its portion of the appendix. The order of Functions, Categories, and Subcategories of the Core is not alphabetical; it is intended to resonate most with those charged with operationalizing risk management within an organization. The numbering of the Subcategories is intentionally not sequential; gaps in numbering indicate CSF 1.1 Subcategories that were relocated in CSF 2.0. **Table 1. CSF 2.0 Core Function and Category names and identifiers** | Function | Category | Category Identifier || --- | --- | --- || **Govern (GV)** | Organizational Context | GV.OC || | Risk Management Strategy | GV.RM || | Roles, Responsibilities, and Authorities | GV.RR || | Policy | GV.PO || | Oversight | GV.OV || | Cybersecurity Supply Chain Risk Management | GV.SC || **Identify (ID)** | Asset Management | ID.AM || | Risk Assessment | ID.RA || | Improvement | ID.IM || **Protect (PR)** | Identity Management, Authentication, and Access Control | PR.AA || | Awareness and Training | PR.AT || | Data Security | PR.DS || | Platform Security | PR.PS || | Technology Infrastructure Resilience | PR.IR || **Detect (DE)** | Continuous Monitoring | DE.CM || | Adverse Event Analysis | DE.AE | Kasus penggunaan
PDF ke Markdown di alur kerja nyata
Catatan riset
Ekstrak sebuah artikel menjadi catatan yang bisa diedit, verifikasi bagian yang dikutip, dan simpan referensi PDF-nya untuk ditinjau nanti.
Pengambilan data laporan
Siapkan laporan untuk dipotong dengan mempertahankan judul tabel, konteks bagian, dan tautan ke dokumen aslinya.
Pustaka regulasi
Ubah regulasi yang sudah ditinjau menjadi teks yang bisa dicari dan simpan PDF terbitannya sebagai versi resmi.
Evaluasi dokumen
Bandingkan PDF yang representatif sebelum mengotomatiskan sebuah koleksi, termasuk hasil pindai, kolom, dan satu tabel yang sulit.
API
API PDF ke Markdown
Pakai POST /v1/convert/pdf dengan header x-api-key dan file sumber yang didukung. Permintaan yang selesai bisa mengembalikan hasilnya di respons itu sendiri; HTTP 202 berarti konversinya masih berjalan. Baca header Location dari respons dan polling ke sana sebelum mengambil file keluaran. Permintaan multipart menerima paling banyak 100 file; batas langganan dan total permintaan juga berlaku. Simpan kunci API di lingkungan server Anda. Akses API memerlukan langganan Lite, Pro, atau Max.
Baca panduan APIcurl -i "https://api.markitdown.ai/v1/convert/pdf" \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F "file=@source.pdf"# If HTTP 202, GET the Location URL with the same API key.Panduan
Meninjau hasilnya
Periksa hasil PDF ke Markdown terhadap PDF aslinya sebelum memakainya sebagai bukti. Mulai dari halaman dengan kolom, catatan kaki, dan tabel alih-alih halaman sampul yang sederhana. Baca kalimat terakhir satu kolom dan kalimat pertama kolom berikutnya: keduanya harus membentuk urutan yang sama seperti yang dibaca orang di PDF. Lalu bandingkan satu judul tabel, satu nilai negatif, dan satu satuan. Pratinjau Markdown yang terbaca tetap bisa memuat salah pengenalan OCR atau sel yang salah tempat. Jika dokumen itu menjadi dasar keputusan finansial atau teknis, simpan PDF-nya di samping Markdown dan verifikasi bagian yang hendak Anda kutip. Konversi memudahkan pekerjaan dengan teksnya; konversi tidak mensertifikasi sumbernya atau transkripsinya.
Apa yang berubah
Konversi PDF ke Markdown menggantikan posisi visual dengan struktur teks. Judul besar bisa menjadi penanda judul, paragraf tetap paragraf, dan tabel yang didukung berubah menjadi baris yang dipisahkan pipa. Geometri halaman, garis dekoratif, fonta, dan pemenggalan baris aslinya bukan bagian dari kontrak keluaran. Ini berguna saat Anda ingin menyunting kutipan atau membangun indeks pengambilan, tetapi tidak cocok saat tujuannya mereproduksi brosur dengan persis. Simpan PDF aslinya untuk tata letak resminya. Ketika sebuah tata letak tidak bisa diwakilkan dengan tabel Markdown sederhana, periksa apakah penjelasan singkat atau tabel yang ditinjau manual adalah representasi lanjutan yang paling jelas.
Sumber untuk RAG
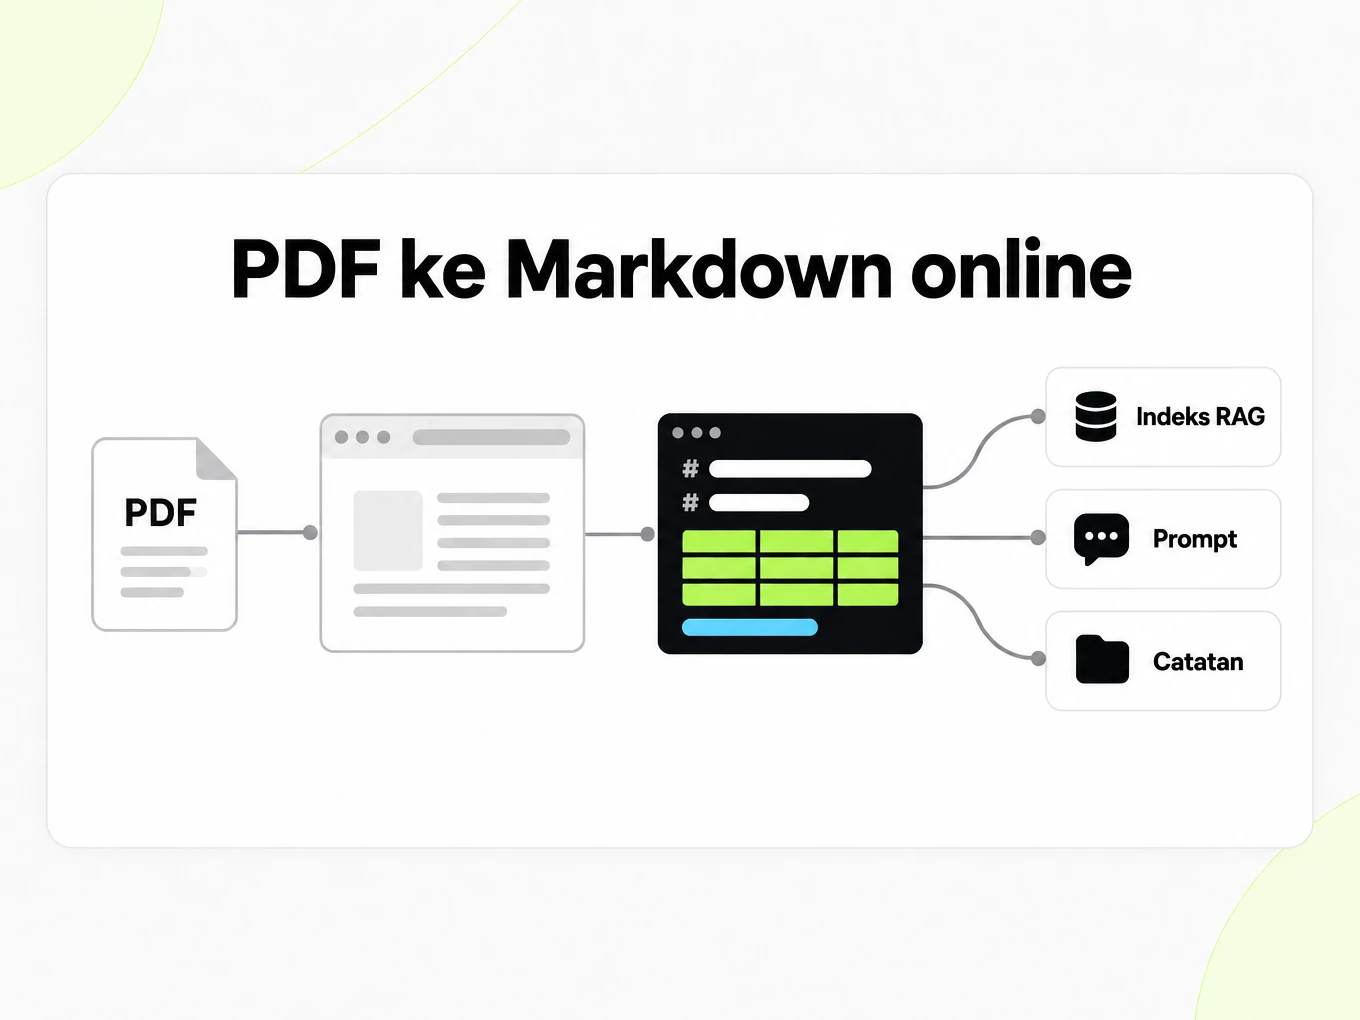
Gunakan judul PDF dan judul bagian yang bermakna untuk mempertahankan konteks saat memotong Markdown menjadi bagian-bagian. Bagian yang hanya berjudul Hasil bisa menjadi ambigu saat keluar dari dokumennya; kode pengambilan data Anda bisa menyimpan nama dokumen dan judul induknya bersama bagian itu. Pertahankan judul tabel bersama baris-barisnya dan hindari memotong daftar di tengah kondisi. Simpan referensi PDF aslinya secara terpisah agar jawaban hasil pengambilan bisa membawa pembaca kembali ke sumbernya. LangChain dan LlamaIndex bisa mengonsumsi teks dari proses pengambilan data Anda sendiri, tetapi memilih pemisah, model penyematan, dan kebijakan pengambilan tetap tugas aplikasi Anda. Uji pengambilan dengan pertanyaan yang jawabannya sudah Anda verifikasi di PDF.
Memilih PDF
Utamakan PDF hasil ekspor asli saat memuat teks yang bisa dibaca. Tangkapan layar dari PDF itu menambah satu langkah pengenalan gambar dan bisa kehilangan karakter kecil sebelum konversi dimulai. Untuk PDF hasil pindai, luruskan halaman yang miring dan pakai versi yang tanda bacanya serta tepi tabelnya tetap terbaca pada zoom normal. Hapus kata sandinya sebelum mengunggah PDF terenkripsi. Jika hanya sebagian laporan panjang yang relevan, siapkan halaman sumber yang bersangkutan dan simpan referensi aslinya di catatan Anda. Mengulang pindaian rusak yang sama tidak akan memperbaiki detail yang hilang; perbaiki sumbernya dulu, lalu bandingkan hasil PDF ke Markdown yang baru dengan yang sebelumnya.
OCR PDF dan lapisan teks
Kualitas pengambilan bergantung pada batas bagian yang cocok dengan dokumen yang akan dibaca orang. Konverter ini menyusun ulang kolom dan mempertahankan tingkat judul agar pemisah bisa menghasilkan bagian utuh alih-alih potongan yang saling menyelip dari artikel dua kolom. Halaman yang hanya berisi gambar tanpa lapisan teks melewati OCR, sedangkan PDF dengan lapisan teks dibaca langsung; keduanya berakhir sebagai Markdown, termasuk saat Anda perlu mengubah PDF ke teks lebih dulu.
- Pakai Markdown sebagai artefak yang Anda potong dan sematkan, bukan buangan teks yang diratakan.
- Halaman standar dan halaman OCR ditagih 1 kredit per halaman di paket dengan sesi masuk.
- File yang dilindungi kata sandi harus dibuka sebelum diunggah; PDF terenkripsi ditolak.
Konverter Markdown lainnya
- Word → MarkdownDOCX dengan judul dan daftar
- PPT → MarkdownTeks slide, catatan, dan tabel
- Excel → MarkdownSetiap sheet sebagai tabel
- Image → MarkdownOCR untuk hasil pindai dan screenshot
- HTML → MarkdownTempel atau unggah HTML
- URL → MarkdownHalaman web publik apa pun, dibersihkan
- Markdown → HTMLHTML bersih dan semantik
- Markdown → TextTeks biasa tanpa markup
- Markdown → PDFCetak ke PDF secara lokal
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
Pertanyaan tentang PDF ke Markdown
Bagaimana PDF ke Markdown bekerja?
PDF ke Markdown mengubah sumber yang didukung menjadi Markdown yang terbaca untuk ditinjau dan dipakai lagi. Uji anonim menerima hingga 10 MB dan 25 halaman per file, dengan 3 konversi per IP per jam dan 10 per hari. Bandingkan hasilnya dengan sumbernya sebelum dipakai.
Berapa ukuran maksimum sebuah PDF?
Konverter publik menerima file PDF hingga 10 MB. Lite mendukung file hingga 100 MB; Pro dan Max punya batas yang lebih tinggi.
Apakah OCR PDF hasil pindai didukung?
Ya. PDF berbasis gambar diproses dengan OCR hari ini; hasil pindai yang tajam dan beresolusi tinggi memberi hasil terbaik. Cara termudah mengubah PDF ke teks adalah mengunggahnya ke sini, lalu meninjau keluarannya.
Apakah artikel riset multi-kolom ditangani?
Ya. PDF ke Markdown berupaya menyusun ulang urutan baca. Bandingkan transisi antarkolom dengan sumbernya, karena tata letak yang rumit masih bisa perlu koreksi.
Apakah tabel finansial akan bertahan?
Tabel dari PDF yang membawa metadata struktural berubah menjadi tabel Markdown. Tabel dari gambar yang diratakan perlu OCR untuk diambil.
Bisakah saya mengonversi PDF yang dilindungi kata sandi?
Tidak. PDF terenkripsi tidak bisa diuraikan. Hapus kata sandinya sebelum diunggah.
Apakah hasilnya berguna untuk dipotong untuk RAG?
Markdown-nya mempertahankan judul, daftar, dan tabel bila memungkinkan, sehingga pemotongan dan penyisipan penyematan tetap bisa diprediksi dibandingkan salin-tempel.
Bisakah saya mengonversi PDF dari kode?
Bisa. Pakai kunci API untuk mengirim file langsung ke /v1/convert/pdf dan baca Markdown-nya di respons. Lihat /developers.
Konversi PDF ke Markdown dalam skala besar.
Gratis untuk dicoba — tanpa perlu mendaftar.