
文書と Web ページのマークダウン 変換。
文書と公開 Web ページのためのマークダウン 変換ツールです。PDF・Word・PowerPoint・Excel・画像・HTML を、確認して再利用でき、AI ワークフローに渡せるテキストに変えます。
匿名トライアル・最大 10 MB・毎時 3 回・1 日 10 回
Markdown に変換できる形式
- DOCX
- PPTX
- XLSX
- PNG / JPG
- HTML
- URL
仕組み
マークダウン 変換ツールの仕組み
markitdown.ai は、PDF・Office ファイル・画像・Web ページを、ChatGPT や Claude、RAG パイプライン、エージェントが使えるクリーンで AI 向けの Markdown に変換するマークダウン 変換ツールです。匿名トライアル、または開発者 API にアクセスできる有料アカウントで利用できます。
What happens
ファイルをアップロードするか URL を貼り付けます。変換はブラウザー上のコピー&ペーストの裏技ではなく当社のサーバーで実行されるため、同じファイルはどこから入っても同じ Markdown になります。各ページは実際に載っている内容に応じて処理され、見出し・リスト・表は本物の Markdown 構造として出力されます。
What you get
- テキストレイヤーのあるページは直接読み取り、スキャンと画像は自動で OCR を通します
- URL の取得は当社のサーバーから実行し、プライベート・内部アドレスはブロックします
- 公開コンバーター:最大 10 MB・25 ページ、ログイン不要
- ログイン済みプランでは両方の上限が上がり、Pro では最大 200 MB・200 ページ
What happens
ビューアーは元の文書と生成された Markdown を並べて表示するので、結果を使う前に見出し・表・読み順を確認できます。レンダリングされたプレビューと生の Markdown を切り替えれば、モデルやパイプラインが受け取る内容をそのまま確かめられます。
What you get
- ビューアーで元ファイルと Markdown を並べて表示
- Markdown パネルはレンダリング済みプレビューと生のソースを切り替え可能
- コピーは無料、アカウントは不要
- ログインすると .md ファイルをダウンロードできます
What happens
1 つのファイルでうまくいった設定は、そのまま複数ファイルやパイプライン呼び出しにも引き継がれ、結果はすべてライブラリに残ります。バッチはファイルごとに状態と再試行を管理し、API は同じ Markdown をそのままコードに渡します。
What you get
- Web アプリ・バッチ(ZIP または URL リスト)・API が同じ解析エンジンを使用
- POST /v1/convert/{name} は 60 秒以内なら 1 回の呼び出しで Markdown を返し、それ以上かかる場合はポーリングまたは webhook で受け取る変換を返します
- ライブラリは各実行をプランの履歴期間(Lite 30 日、Pro 60 日、Max 90 日)保持します
クレジット
Markdown の精度を、ページ単位の料金で。
テキストレイヤーのある請求書も、スキャンした貸借対照表も、1 ページあたりの料金は同じです。直接抽出か OCR かはパイプラインが選びます。図や画像向けの AI 追加処理は任意で、別途計量されます。
- 1 ページあたり、テキストまたはスキャン
- 1 クレジット
- 1 ページあたり、テキストまたはスキャン
テキストレイヤー付き PDF・Office ファイル・HTML
スキャンページ・写真・スクリーンショットの OCR
PDF 内のグラフや図を説明文に · 有料プラン
OCR だけでなく画像の内容を説明 · 有料プラン
Markdown API
RAG パイプラインのための Markdown API。
- Web アプリと同じ解析パイプライン
- 完了時に webhook を受け取るバッチで、数千ファイルを処理
- スコープ付き API キーと完全なアクティビティログ
- 1 回の呼び出しで Markdown、または 60 秒を超えるファイルではポーリングできる変換を返します
curl -X POST https://api.markitdown.ai/v1/convert/word \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F file=@vendor-security-review-q3-2026.docx # If HTTP 202, GET the Location URL with the same API key.# Verified local parser output for vendor-security-review-q3-2026.docx:# ## Review Findings# # Risk ratings follow the standard High / Medium / Low scale defined in the vendor risk management policy.# # | Vendor | Risk Rating | Finding | Owner |# | --- | --- | --- | --- |# | CloudScan OCR | Medium | No documented data retention limit on uploaded scans | Security |# | PayBridge | Low | SOC 2 Type II renewed; no open items | Finance |# | LingoTrans API | High | Sub-processor list not disclosed on request | Legal |# | ArchiveNow Storage | Medium | Encryption at rest confirmed; key rotation overdue | Security |課題
文書はまだ AI の準備ができていない
ほとんどの文書は人とプリンターのために作られ、言語モデルのために作られていません。ファイルを埋め込み、検索し、推論するには、まず予測可能なテキストにする必要があります。それは見た目より難しく、単純な抽出が破綻するのはまさにそこです。
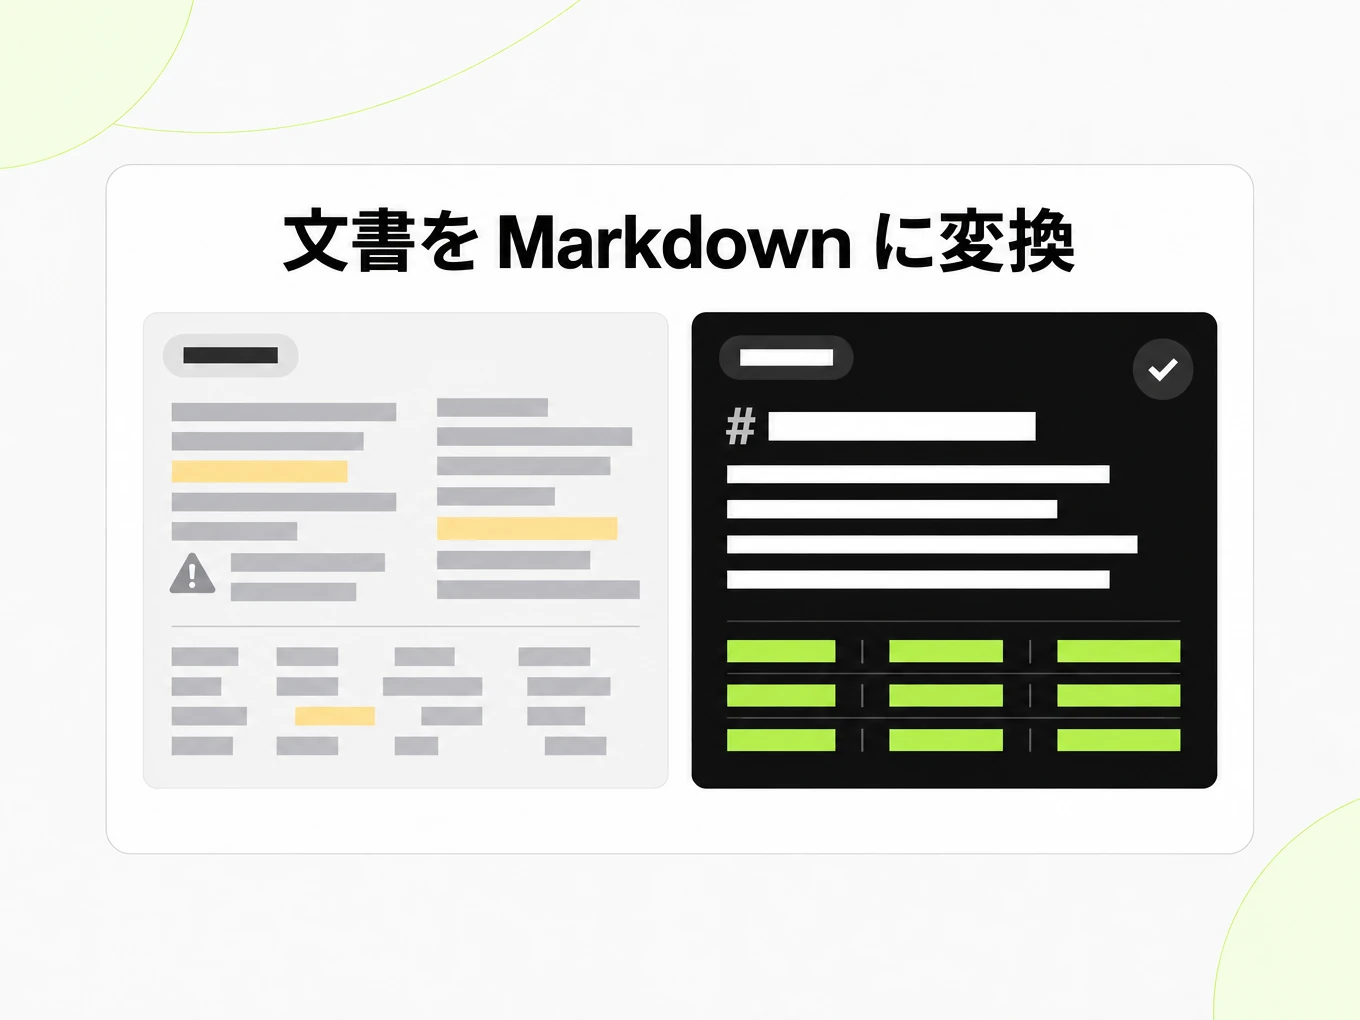
読み順が崩れる
複数カラムの PDF やヘッダー、脚注が入り交じり、LLM が読むテキストが人が見る文書と一致しなくなります。
表と見出しが平坦化する
コピー&ペーストでは表が数字の羅列につぶれ、文書に構造を与える見出し階層が失われます。
スキャンには OCR が必要
画像ベースのページやスキャンした契約書には、光学文字認識を通すまでテキストレイヤーがまったくありません。
生テキストはノイズだらけ
場当たり的な抽出はページ番号や不自然な改行、余計な文字を残し、プロンプトや検索結果を汚します。
RAG パイプラインとエージェントに必要なのは、抽出した文字だけでなく一貫した構造です。予測可能な Markdown があれば、何千もの文書でチャンク化・埋め込み・検索が同じように機能し、乱れた文書で静かに失敗することがありません。厄介なファイルを扱えるパーサーこそが、きれいなファイルの信頼性を保ちます。
入力形式
あらゆる文書を Markdown に変換
入力形式ごとに専用の変換ページがあり、上限・形式の注意・出力例を掲載しています。どのページも同じ解析エンジンを共有するので、ファイルに合うページを選んでください:
- PDF から Markdown — レポート、論文、マニュアル、契約書。テキストが入った PDF は直接解析し、複数カラムの読み順も再構築します。スキャンした PDF は 1 ページずつ OCR を通します。
- Word から Markdown — .docx と旧式の .doc ファイル。見出し・リスト・表・コメントを保つので、ポリシーや仕様書が 1 つの塊ではなくアウトラインとして読めます。
- PPT から Markdown — .pptx と .ppt のスライドを 1 枚ずつ変換。スライドタイトルは見出しになり、箇条書きと表も残るので、40 枚のスライドも検索可能になります。
- Excel から Markdown — .xlsx と .xls のブック。各シートがシート名の下の Markdown テーブルになります。
- 画像から Markdown — PNG と JPG のスクリーンショットやスキャンを OCR で処理。AI 画像理解はログインが必要な別オプションです。
- HTML から Markdown — 保存したページ、エクスポート、断片。スクリプトとスタイルを除き、記事の構造・リンク・表はそのまま残します。
- URL から Markdown — 公開 Web アドレスを貼り付けると、そのページを Markdown で取得します。取得はサーバー側で行い、サイズ上限とタイムアウトを設けているので、遅いサイトでもリクエストが固まりません。
出力形式
Markdown からあらゆる形式へ
Markdown は交換形式なので、変換は逆方向にもできます。以下の Markdown エディターはブラウザー内で入力と同時にレンダリングし、テキストをアップロードしません:
- Markdown から HTML — GitHub 風の表・タスクリスト・コードハイライトに対応したクリーンで意味的な HTML。CMS やメールにそのまま貼り付けられます。
- Markdown からテキスト — 見出し・リスト・表を読みやすく平坦化したプレーンテキスト。チャット欄・チケット・フォームに適しています。
- Markdown から PDF — ローカルの印刷プレビュー。ブラウザーの「印刷 / PDF に保存」を使い、保存したページを確認します。
構造化 JSON 抽出と、音声・動画の文字起こしは、Markdown の上に載る計画中の機能です。実装済みではなくロードマップとして記載しています。
ユースケース
あらゆるチームのために
マークダウン 変換ツールには、最初の結果を確かめるための匿名トライアルがあります。チームが使い続ける理由は、最初の 1 ファイルの後に続くものすべてにあります。履歴、バッチ、より大きな文書、そして変換を既存のシステムに組み込む API です。利用者が人でも検索インデックスでもモデルでも、同じ Markdown が機能します。
RAG と AI パイプライン
チャンク化・埋め込み・エージェント処理の前に、元文書をクリーンな Markdown に変換します。予測可能な構造のおかげで、分割ツールは抽出テキストの壁ではなく本物の見出しや表を見られ、検索の関連性を保ち、プロンプトからレイアウトのノイズを除けます。
研究とレポート
論文、ホワイトペーパー、スライドを編集・検索できる Markdown に変換します。研究者やアナリストは、表を打ち直したり密度の高い PDF の読み順を失ったりせずに、知見を引用・注釈・要約・再利用できます。
運用ドキュメント
ポリシー、契約書、請求書、社内ファイルを手作業のコピー&ペーストなしで処理します。保存された Markdown の履歴により、日々の運用で繰り返す文書作業をレビュー・比較・再利用しやすくなります。
開発者の自動化
API を使えば、データ取り込みジョブ、社内ツール、文書ワークフローの中でファイルを変換できます。リクエストを送って Markdown を受け取り、信頼できる出力として CMS・ナレッジベース・サポートボット・エージェントパイプラインに流し込めます。
ナレッジベースとサポート
製品マニュアル、リリースノート、社内 wiki を 1 つの Markdown コーパスにまとめ、サポートボットや社内アシスタントから検索できるようにします。見出しと表が残るので、回答はページ大の塊ではなく正しいセクションを指します。
エージェントとツール
対応ファイルと公開 URL を扱えるマークダウン 変換ツールをエージェントに渡し、結果を使う前に完了を確認させます。このサイトも同じ方法で読めます。公開ページはすべて Accept: text/markdown に対して Markdown の双子を返し、llms.txt が全ページを一覧します。
出力品質
テキストだけでなく、構造を
役に立つマークダウン 変換ツールは、PDF から抽出した孤立した文字以上のものを保ちます。ここでの目的は、後続ツールが依存する構造を保った Markdown を、壊れやすいブラウザーのコピー&ペーストではなくサーバー側の解析パイプラインで生成することです。
- 元ファイルに構造がある箇所では、見出し・リスト・表・リンク・読み順を保持します。
- PDF・Word・PowerPoint・Excel・画像・HTML・URL を 1 つのパイプラインで処理します。
- スキャンした PDF と画像は現在 OCR で処理します。認識品質は元画像に依存します。
- 長い文書は非同期で実行するので、大きなレポートやスライドもタイムアウトせずに完了します。
標準ページと OCR ページはどちらも 1 ページ 1 クレジット。有料プランのアカウントでは、AI 画像理解を 1 画像 5 クレジットで利用できます。 出力は CommonMark と GitHub 風の表に従うため、どの Markdown ビューアーでも表示でき、どの Markdown ライブラリでも解析できます。すべての変換は、確認・保存・再利用できる成果物を生み出すべきです。それが基準です。
3 つの入口
ブラウザー、API、エージェント
Web アプリのマークダウン 変換ツールは、単発および繰り返しの手動変換を担います。バッチはまとまったファイルを担います。API は、ツールとして呼び出すエージェントも含め、自動で起きるべきことすべてを担います。3 つは同じアカウント・同じクレジット残高・同じ解析エンジンを共有します。多くのチームはブラウザーから始め、変換が製品や社内ワークフローの一部になった段階で API に移行します。
| Aspect | ブラウザー | バッチ | API |
|---|---|---|---|
| 最適 | 1 ファイルずつ | 1 回の実行で多数のファイル | パイプライン・ツール・エージェント |
| ログイン | 最初のファイルは不要 | 有料プラン | 有料プラン + API キー |
| 入力 | アップロードまたは URL | アップロード一覧またはファイル ID | アップロード、URL、インラインテキスト、ファイル ID |
| 出力 | プレビュー、コピー、.md のダウンロード | ファイルごとの状態付きライブラリ | Markdown 付き JSON、ページ単位の出力、webhook |
| 上限 | ログインなしで 10 MB・25 ページ | プランの同時実行数 | プラン別に毎分 20〜60 リクエスト |
| 待ち時間 | ページ内で数秒 | バックグラウンド | 同期は最大 60 秒、その後はポーリングできる変換 |
Web アプリ
- ファイルをアップロードするか URL を貼り付け、レンダリングされた Markdown をプレビュー
- 変換履歴を保存し、.md の結果をダウンロード
- ファイルごとの状態付きで繰り返し作業をバッチ変換
- プラン別にクレジットと使用量を確認
開発者 API
- POST /v1/convert/{name} は 1 回の呼び出しで Markdown、または 60 秒を超えるファイルでは変換を返します
- 変換をポーリングするか、完了時に webhook を受け取る
- Accept: text/markdown を送ると、公開ページを Markdown として読めます
- 機械可読な仕様は /v1/openapi.json
FAQ
マークダウン 変換に関するよくある質問
マークダウン 変換ツールは何をするものですか?
文書から Markdown への変換ツールは、PDF・Word・PowerPoint・Excel・画像・Web ページを読み取り、その内容を Markdown として書き直すツールです。見出しは # 行に、表はパイプ表に、リストはリストのまま変換されます。狙いは、言語モデルや RAG パイプライン、エージェントがレイアウトのノイズなしにチャンク化・埋め込み・引用できる、予測可能なプレーンテキストを得ることです。
無料のコンバーターは本当に無料ですか?
はい。公開コンバーターページはアカウントもカードも不要です。最大 10 MB・25 ページまでのファイルをブラウザーで変換し、Markdown をプレビュー・コピーできます。Lite・Pro・Max のサブスクリプションは月額 $20 からで、保存ライブラリ・バッチ・API が加わります。
スキャンした PDF と画像はどう処理されますか?
画像だけのページにはテキストレイヤーがないため、パイプラインが自動で OCR を実行し、デジタルテキストと同じように Markdown を返します。標準ページと OCR ページはどちらも 1 ページ 1 クレジット。認識品質は元画像に依存します。300 dpi のスキャンは、スマートフォンで撮ったページの写真よりはるかに読み取れます。
コードやエージェントから実行できますか?
はい。POST /v1/convert/{name} はアップロード、URL、またはインラインテキストを API キーとともに受け取り、ファイルが 60 秒以内に完了すれば 1 回の呼び出しで Markdown を返し、それ以外はポーリングまたは webhook で受け取る変換を返します。エージェントは任意の公開ページで Accept: text/markdown を要求でき、機械可読な仕様は /v1/openapi.json にあります。
変換後、ファイルはどうなりますか?
変換を削除すると、その変換はすぐにライブラリから消え、保存ファイルも 1 時間以内に消去されます。別の変換と共有している元ファイルは、その変換も削除されるまで保持されます。アカウントを削除すると、保存されているすべての元ファイルと結果ファイルが消去されます。有料プランはプランに応じて履歴を Lite 30 日、Pro 60 日、Max 90 日保持します。