
変換ツール
URL を Markdown に変換するツール
URL を Markdown に変換する無料の変換ツールです。公開されている Web ページから、サイトのナビゲーションを含まない記事・ドキュメントページ・スレッドの本文だけを取り出し、クリーンな Markdown に変えます。LLM、RAG パイプライン、ノートにそのまま使えます。試すのに登録は不要で、トライアルは 1 IP あたり 1 時間に 3 回、1 日 10 回までです。
使い方
Web ページを Markdown に変換する方法
貼り付けできるもの
- 公開されている任意の http(s) ページ — 記事、ドキュメント、ブログ記事
- ログインやペイウォールの内側のページは取得できません
- ページはサーバー側で取得され、その JavaScript は実行しません
- アカウントなしで試せます。1 ファイルあたり最大 10 MB、25 ページ、1 時間に 3 回、1 日 10 回まで
確認すべきこと
- サーバー側での取得 — ページはサーバー側で取得されます。まず Markdown を求め、次に HTML を求めます。サイト自身の Markdown は、品質チェックを通った場合にのみ使われます。ブラウザのプラグインやローカルツールは不要です。
- 本文抽出 — 可読性スコアリング、定型文の検出、テキスト密度分析、そしてページ自身の main や article 要素という複数の抽出方法が競い合い、もっとも多くの構造と本文を残したものが採用されます。ドキュメント生成ツール、GitHub、Wikipedia のような有名なサイトはサイト専用のルールを使います。
- JavaScript でレンダリングされるページ — 空のアプリケーションの外枠は、ヘッドレスブラウザでレンダリングされます。ブラウザはページが落ち着くのを待ってから、レンダリング後の DOM を同じ抽出処理に渡します。クリックやスクロールの後にだけ現れる内容は取得されません。
- 公開ページ、サイズと身元 — 対応するのは公開されている URL のみです。認証、ペイウォール、ログイン画面の内側のページは取得できません。取得したページはレスポンスサイズの上限に従い、取得ツールのユーザーエージェントは /docs/fetcher に文書化されています。
Markdown の行き先
- プレビューから Markdown をそのままコピー
- .md ファイルをダウンロードし、ログイン後はライブラリに保管
- POST /v1/convert/url の urls 配列で多数のページをまとめて変換
- POST /v1/convert/url と API キーで自動化
使う理由
この URL から Markdown への変換ツールを使う理由
Web ページはブラウザ向けに書かれています。Markdown は人とモデル向けに書かれています。この変換ツールはページの中で意味を担う部分を見つけ、その構造を保ちながら、サイトの装飾を取り除きます。
ページ全体ではなく本文だけ
複数の抽出ツールがページを読み取り、記事をもっとも多く残した結果が採用されるので、メニュー、Cookie バナー、フッター、関連記事欄は Markdown に含まれません。
残る構造
見出し、リスト、表、コードブロックが Markdown として届き、ページ内のすべての相対リンクと画像パスは、ページの外でも機能する完全な URL に書き換えられます。
JavaScript ページもレンダリング
最初の HTML が空のアプリケーションの外枠だけのとき、ページはヘッドレスブラウザでレンダリングされ、レンダリング後の内容が変換されます。
無料で試せてログイン不要
アカウントなしで Markdown をプレビュー・コピーできます。1 時間に 3 回、1 日 10 回まで。.md ファイルのダウンロードにはログインが必要です。
礼儀正しく身元を示す取得
すべてのリクエストは文書化されたユーザーエージェントで身元を示し、サイト所有者はブロックできます。ドキュメントの取得ツールのページを参照してください。
API と同じエンジン
このページの変換ツールと POST /v1/convert/url は同じコードを実行するので、スクリプトは 1 回の呼び出しで最大 20 件の URL を変換できます。
課題
生きたページがモデルにとってノイズが多い理由
ページはノイズが多い
生きた Web ページは内容をナビゲーション、広告、バナー、スクリプトの下に埋もれさせます。しかもその量は記事本体の何倍にもなることがあります。
マークアップは乱雑
手書きと生成の HTML が、読める構造にきれいに対応することはめったにありません。
AI は記事を必要とする
RAG とエージェントは周囲のページの外枠ではなく記事を求めます。ページによっては JavaScript が実行された後にしか記事が表示されません。
保たれるもの
この URL 変換ツールが取得するもの
- サーバー側での取得
- ページはサーバー側で取得されます。まず Markdown を求め、次に HTML を求めます。サイト自身の Markdown は、品質チェックを通った場合にのみ使われます。ブラウザのプラグインやローカルツールは不要です。Source: RFC 9110: HTTP Semantics
- 本文抽出
- 可読性スコアリング、定型文の検出、テキスト密度分析、そしてページ自身の main や article 要素という複数の抽出方法が競い合い、もっとも多くの構造と本文を残したものが採用されます。ドキュメント生成ツール、GitHub、Wikipedia のような有名なサイトはサイト専用のルールを使います。Source: HTML Living Standard: the main element
- JavaScript でレンダリングされるページ
- 空のアプリケーションの外枠は、ヘッドレスブラウザでレンダリングされます。ブラウザはページが落ち着くのを待ってから、レンダリング後の DOM を同じ抽出処理に渡します。クリックやスクロールの後にだけ現れる内容は取得されません。Source: HTML Living Standard
- 公開ページ、サイズと身元
- 対応するのは公開されている URL のみです。認証、ペイウォール、ログイン画面の内側のページは取得できません。取得したページはレスポンスサイズの上限に従い、取得ツールのユーザーエージェントは /docs/fetcher に文書化されています。Source: product pipeline
例:URL 取得による markitdown.ai ブログ記事· https://markitdown.ai/blog/why-pdfs-break-llms
# Why PDFs break LLMs — and what clean Markdown fixes _Published 2026-06-12 · The markitdown.ai team_ > A PDF that looks perfect to a human often falls apart the moment a model reads it. Here's what goes wrong, and why converting to clean Markdown first makes downstream AI far more reliable. A PDF renders perfectly for a human and falls apart the moment a model reads it. The page you see — columns, tables, headers, footnotes — is a *visual* arrangement, not a logical one. When you pull raw text out of it, that visual order rarely survives, and whatever you feed a language model is only as good as the text it actually receives. ## What actually goes wrong When teams pipe documents straight into an LLM or a retrieval index, a few failure modes show up again and again: - **Reading order breaks.** Multi-column layouts interleave. A two-column page becomes "line 1 left, line 1 right, line 2 left, line 2 right…", so a sentence a human reads top-to-bottom arrives at the model scrambled.- **Tables collapse.** Copy-paste turns a table into a loose run of numbers. The relationship between a header and its cell — the entire point of a table — is gone.- **Headings disappear.** The visual hierarchy (this is a section, this is a subsection) is encoded as font size and weight, not structure. Strip the styling and you get one undifferentiated wall of text. 用途
Web サイトから Markdown への変換の用途
AI エージェントからコンテンツ移行まで、Web ページを Markdown に変換するのは多くのワークフローが依存する小さな一歩です。
AI と LLM のパイプライン
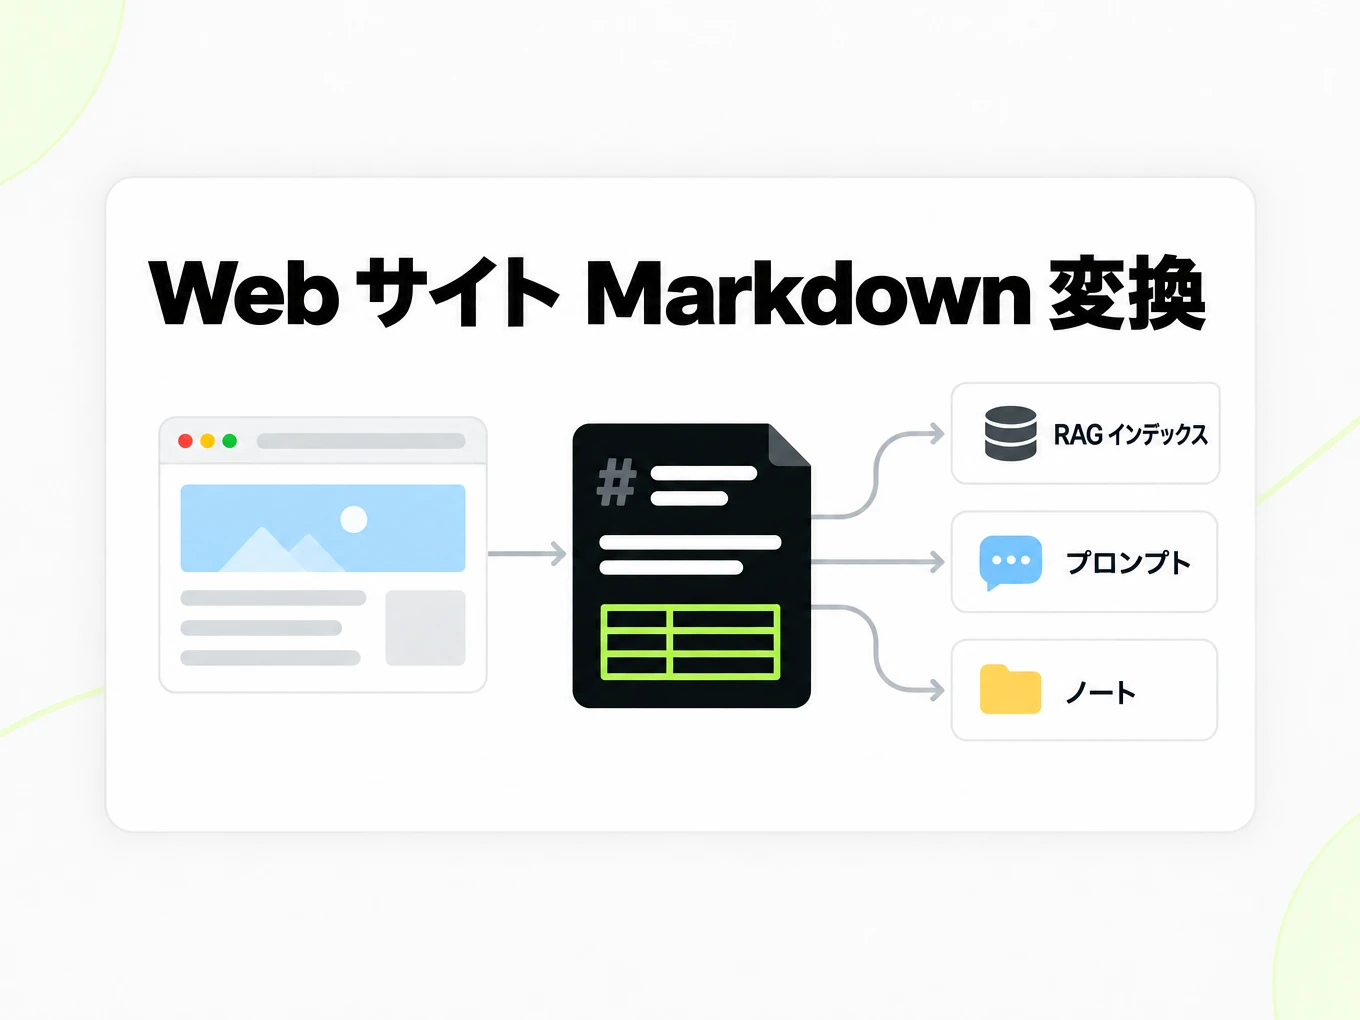
生の HTML ではなく、記事とドキュメントを見出しを保ったクリーンなテキストとして RAG インデックス、エージェントのツール、プロンプトに流し込みます。
調査とノート
引用、注記、Obsidian やノートリポジトリでの保管のために、元のリンクを残したまま資料を Markdown として保存します。
コンテンツチーム
投稿やヘルプセンターのページをある CMS から別の CMS へ移したり、参考資料を Markdown ベースのドキュメントサイトに取り込みます。
開発者
すでに動かしている取り込みジョブやクローラーから API を呼び、ブラウザの変換ツールが表示するのと同じ Markdown を得ます。
API
開発者向け URL から Markdown への API
コードからページを変換しますか? 1 件の URL、または urls 配列で最大 20 件を、API キーを添えて POST /v1/convert/url に送ります。render を auto、force、skip のいずれかに設定すると JavaScript のレンダリングを制御でき、frontmatter を true にするとページのタイトル、著者、公開日を YAML の front matter に入れられます。ページが待機ウィンドウ内に完了すれば Markdown が同じレスポンスで返ります。そうでなければ、ポーリングする変換、または確定時の webhook を受け取ります。API アクセスは有料プランです。
API ガイドを読むcurl -X POST https://api.markitdown.ai/v1/convert/url \ -H "x-api-key: mdai_…" \ -H "content-type: application/json" \ -d '{"url":"https://markitdown.ai/blog/why-pdfs-break-llms","frontmatter":true}'ガイド
出力を確認する
送信した公開ページのそばで、URL から Markdown への出力を確認します。変換ツールは本文を保ち、ナビゲーション、Cookie の通知、フッターのリンクを取り除きますが、明確な記事構造を持たないページ — 製品ページ、ランディングページ、多数のティーザーを持つホームページ — では、サイドパネルが失われたり、引用したくないブロックが残ったりすることがあります。結果をインデックスする前に、先頭と末尾の段落をページと照らし合わせて確認してください。JavaScript で内容を構築するページはまずブラウザでレンダリングされます。クリック、スクロール、ログインの後にだけ読み込まれるテキストは、それでも取得できません。サイトがすでに Markdown を求めるクライアントに自身の Markdown を返している場合、それが品質チェックを通れば変換ツールはその版を使い、サイト全体のメニューやアーカイブのダンプのように見えるときは HTML ページにフォールバックします。元の URL を Markdown と一緒に保ち、読者が元のページに戻れるようにします。
ソースの文脈を保つ
送信した URL と取得日を、自分のワークフローで URL から Markdown への結果と一緒に保ちます。公開ページは変換後に変わることがあるので、後から訪れる人は改訂された箇所を見るかもしれません。front matter を有効にすると、結果の冒頭に元の URL、canonical URL、タイトル、そしてページが示している場合は著者、公開日、説明、サイト名、言語、リード画像が入ります。これらはページの meta タグ、構造化データ、署名から読み取られます。これらの項目はページ自身が述べている内容を繰り返すだけなので、調査でそれらに依存するなら原本で確認してください。API の metadata フィールドはこれとは別物で、あなたが渡す文脈だけを載せます。表や段落を引用する前にページと比較し、意味が変わらないよう周囲の文脈を十分に保ちます。Markdown は Web コンテンツを再利用しやすくしますが、そのページが正確か、再公開の許可があるかを確定するものではありません。
保存した HTML と URL
処理したい正確なページのスナップショットがすでに手元にあるときは、HTML 変換ツールを選びます。今回の変換の入力が公開されているアドレスであるときは、URL から Markdown を選びます。これらは入力の制御が異なる関連ワークフローです。保存したファイルは送信する入力を固定し、そのまま全体が変換されます。URL はリクエスト時にサイトが返す内容に依存し、本文だけに絞り込まれます。どちらの経路もアクセス制限を回避しません。サイトが取得を拒否したりログインを要求する場合は、適切なワークフローで取得を許可された素材を使ってください。アクセスできない URL を、別の変換の試行でアクセスが許されるかのように繰り返し再試行しないでください。
LLM リサーチ
研究者はファイルではなくソースを貼り付けます。この変換ツールは送信された URL を取得し、記事やドキュメントの本文を保って、引用・チャンク化・ノート保管庫への投入ができ、リンクも機能したままの Markdown を返します。サーバーが空の外枠を返したときは JavaScript ページをレンダリングし、ペイウォールにはログインしません。
- 公開されている URL のみに対応します。
- 取得ツールは身元を示します。運営者はユーザーエージェントを拒否できます — /docs/fetcher を参照してください。
- 保存した HTML ファイルは /html-to-markdown の担当で、ここではありません。
その他の Markdown 変換ツール
- PDF → Markdownテキスト、表、スキャン
- Word → Markdown見出しとリストのある DOCX
- PPT → Markdownスライドのテキスト、ノート、表
- Excel → Markdownすべてのシートを表として
- EPUB → Markdown電子書籍の章を見出しに
- Image → Markdownスキャンとスクリーンショット向けの OCR
- HTML → MarkdownHTML を貼り付けまたはアップロード
- Markdown → HTMLクリーンで意味のある HTML
- Markdown → Textマークアップなしのプレーンテキスト
- Markdown → PDFローカルで PDF に印刷
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
URL を Markdown に変換する際のよくある質問
URL から Markdown はどう動作しますか?
URL から Markdown は、貼り付けた公開ページを取得し、その本文を保って、完全な URL のリンク付きの Markdown に変換します。アップロードするファイルはありません。JavaScript が必要なページはまずブラウザでレンダリングされます。
生きたページから広告とナビゲーションを除去しますか?
明確な本文領域があるページなら、はい。URL から Markdown は記事、ドキュメント本文、スレッドを保ち、メニュー、Cookie バナー、フッターを取り除きます。明確な本文ブロックを持たないランディングページや製品ページでは、サイドパネルが残ったり失われたりすることがあるので、結果を確認してください。
取得したページにサイズ上限はありますか?
公開変換ツールは公開 Web ページに対して機能します。取得したページはレスポンスサイズの上限に従い、大きすぎる場合は拒否されることがあります。
ログインの内側のページでも機能しますか?
いいえ。公開されている URL のみに対応します。認証、ペイウォール、ログイン画面の内側のページは取得できません。
JavaScript で描画されるページはどうなりますか?
最初の HTML が空の外枠のとき、JavaScript でレンダリングされるページはヘッドレスブラウザでレンダリングされ、その後は他のページと同じように変換されます。API では render を force にすると常にレンダリングし、skip にすると常にレンダリングしません。クリック、スクロール、ログインの後にだけ現れるテキストは取得されません。
複数の URL を一度に変換できますか?
最大 20 件の公開 URL を urls 配列で POST /v1/convert/url に送ります。各ファイルの結果を追跡し、非同期のレスポンスを処理してください。/developers を参照してください。
URL から Markdown は無料ですか?
はい。Markdown のプレビューとコピーはアカウントなしで無料、1 時間に 3 回、1 日 10 回までです。.md ファイルのダウンロードにはログインが必要です。公開 Web ページのみ(内部または非公開の URL は不可)。
変換ツールはどの内容を保ちますか?
変換ツールは本文の見出し、段落、リスト、リンク、画像、表、コードブロックを保ち、相対リンクは完全な URL に書き換えます。スクリプト、スタイル、ナビゲーション、フッターは破棄されます。front matter を有効にすると、ページのタイトル、著者、公開日が先頭に入ります。
URL 変換の API はありますか?
はい。REST API を通じてプログラムから Web ページを URL で変換できます。/developers を参照してください。保存した HTML ファイルには代わりに /html-to-markdown を使います。