
Conversor
Conversor de PDF para Markdown
PDF para Markdown é um conversor que reconstrói a ordem de leitura de várias colunas em Markdown estruturado para RAG. O teste público aceita arquivos de até 10 MB.
Teste um arquivo antes de escolher um plano.
- Sem conta: até 10 MB e 25 páginas por arquivo, 3 conversões por hora e 10 ao dia, com pré-visualização e cópia no navegador.
- Com login: 20 conversões grátis por dia, salvas na sua biblioteca.
- Lite, Pro e Max incluem créditos de conversão, processamento em lote, acesso à API e histórico salvo. O Lite inclui 30 dias de histórico.
Como funciona
Como converter PDF em Markdown
O que você pode enviar
- Tipos de arquivo: .pdf
- Teste sem conta: até 10 MB e 25 páginas por arquivo, 3 conversões por hora e 10 ao dia
- O Lite aceita arquivos de até 100 MB e o Pro de até 200 MB
- O Max não tem limite de tamanho por arquivo; as conversões são limitadas por créditos
O que conferir
- Reconstrução da ordem de leitura — A conversão de PDF tenta reconstruir uma ordem de leitura lógica.
- Tabelas e títulos — Os níveis de título e os dados tabulares são preservados quando o PDF expõe metadados estruturais; PDFs de texto simples produzem uma saída de texto simples.
- PDFs digitalizados e só de imagem — PDFs sem camada de texto (páginas digitalizadas e imagens inseridas) são processados hoje com OCR; a precisão depende da qualidade da digitalização.
- Arquivos protegidos com senha — PDFs criptografados não podem ser analisados; remova a senha antes de enviá-los.
Para onde vai o Markdown
- Copie o Markdown direto da pré-visualização
- Baixe o arquivo .md e guarde-o na sua biblioteca ao entrar
- Converta pastas inteiras ou arquivos ZIP com a conversão em lote
- Automatize com POST /v1/convert/pdf e sua chave de API
Por que usar
Por que usar PDF para Markdown
Relatórios como texto legível
Converta os parágrafos e a estrutura aceita de um relatório em Markdown que você pode inspecionar, editar e conservar junto do PDF de origem.
OCR para páginas digitalizadas
As páginas só de imagem podem ser reconhecidas com OCR. Compare o texto pequeno, a pontuação e as tabelas numéricas com a digitalização original.
Contexto dos títulos
Conserve seções reconhecíveis para anotações e fluxos de recuperação, e verifique ao mesmo tempo se os títulos com estilo visual foram interpretados corretamente.
Tabelas para revisar
As tabelas aceitas viram tabelas de texto. Revise as células complexas ou mescladas antes de tratar os valores exportados como evidência.
Pré-visualize antes de reutilizar
Compare o código Markdown com sua exibição renderizada antes de copiar um trecho para o ChatGPT, o Claude ou um repositório de documentação.
Uma rota de API repetível
Use a rota de conversão de PDF em um script de ingestão depois de revisar no navegador resultados representativos.
O problema
Por que as colunas de um PDF quebram os modelos de linguagem
As colunas se entrelaçam
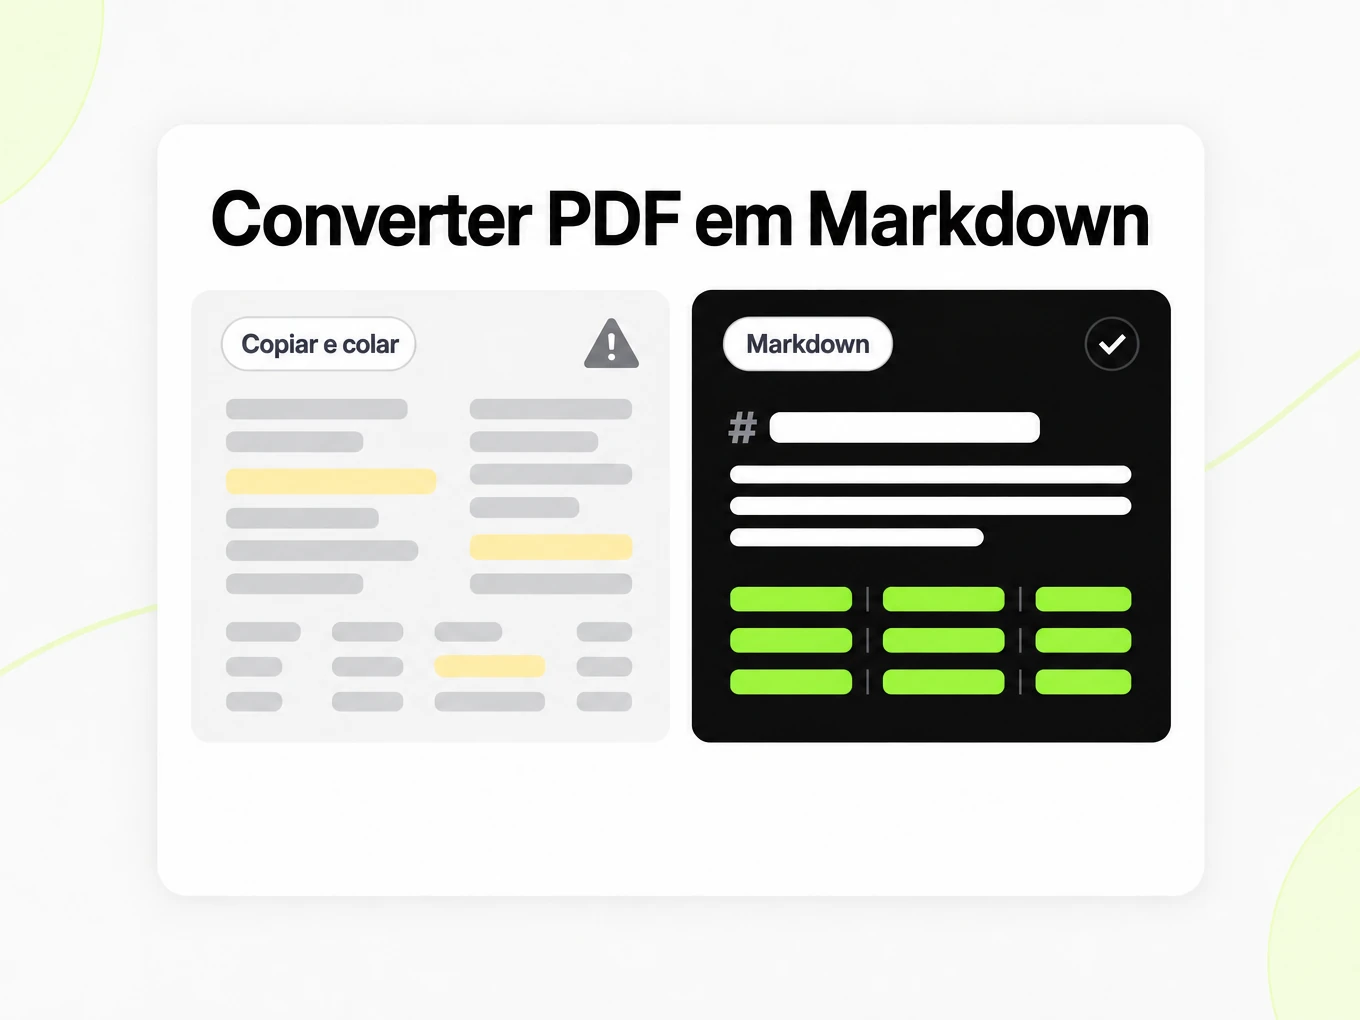
Um relatório em duas colunas lido de cima para baixo mistura o fluxo esquerdo e o direito, então o modelo vê uma frase que nunca existiu na página.
As tabelas perdem sua grade
Copiar e colar de um PDF transforma uma tabela de resultados em uma sucessão de números sem linha de cabeçalho para um analisador posterior.
As digitalizações não têm camada de texto
Páginas só de imagem contêm pixels, não glifos, então PDFs digitalizados são processados hoje com OCR.
O que é preservado
O que este conversor de PDF preserva
- Reconstrução da ordem de leitura
- A conversão de PDF tenta reconstruir uma ordem de leitura lógica. Revise as transições entre colunas contra o original, sobretudo em relatórios e artigos complexos.Source: ISO 32000-2 (PDF 2.0)
- Tabelas e títulos
- Os níveis de título e os dados tabulares são preservados quando o PDF expõe metadados estruturais; PDFs de texto simples produzem uma saída de texto simples.Source: CommonMark Spec
- PDFs digitalizados e só de imagem
- PDFs sem camada de texto (páginas digitalizadas e imagens inseridas) são processados hoje com OCR; a precisão depende da qualidade da digitalização.Source: product pipeline
- Arquivos protegidos com senha
- PDFs criptografados não podem ser analisados; remova a senha antes de enviá-los.Source: ISO 32000-2 (PDF 2.0)
Exemplo: NIST Cybersecurity Framework 2.0, página 15· https://nvlpubs.nist.gov/nistpubs/CSWP/NIST.CSWP.29.pdf
## Appendix A. CSF Core This appendix describes the Functions, Categories, and Subcategories of the CSF Core. Table 1 lists the CSF 2.0 Core Function and Category names and unique alphabetic identifiers. Each Function name in the table is linked to its portion of the appendix. The order of Functions, Categories, and Subcategories of the Core is not alphabetical; it is intended to resonate most with those charged with operationalizing risk management within an organization. The numbering of the Subcategories is intentionally not sequential; gaps in numbering indicate CSF 1.1 Subcategories that were relocated in CSF 2.0. **Table 1. CSF 2.0 Core Function and Category names and identifiers** | Function | Category | Category Identifier || --- | --- | --- || **Govern (GV)** | Organizational Context | GV.OC || | Risk Management Strategy | GV.RM || | Roles, Responsibilities, and Authorities | GV.RR || | Policy | GV.PO || | Oversight | GV.OV || | Cybersecurity Supply Chain Risk Management | GV.SC || **Identify (ID)** | Asset Management | ID.AM || | Risk Assessment | ID.RA || | Improvement | ID.IM || **Protect (PR)** | Identity Management, Authentication, and Access Control | PR.AA || | Awareness and Training | PR.AT || | Data Security | PR.DS || | Platform Security | PR.PS || | Technology Infrastructure Resilience | PR.IR || **Detect (DE)** | Continuous Monitoring | DE.CM || | Adverse Event Analysis | DE.AE | Casos de uso
PDF para Markdown em fluxos de trabalho reais
Anotações de pesquisa
Extraia um artigo para anotações editáveis, verifique os trechos citados e conserve a referência do PDF para revisar depois.
Ingestão de relatórios
Prepare relatórios para a divisão em blocos conservando os cabeçalhos de tabela, o contexto de seção e um link para o documento original.
Bibliotecas de normas
Converta uma norma revisada em texto pesquisável e conserve o PDF publicado como versão autorizada.
Avaliação de documentos
Compare PDFs representativos antes de automatizar uma coleção, incluindo digitalizações, colunas e uma tabela difícil.
API
PDF para Markdown API
Use POST /v1/convert/pdf com um cabeçalho x-api-key e um arquivo de origem aceito. Uma solicitação concluída pode devolver os resultados na própria resposta; um HTTP 202 significa que a conversão continua em andamento. Leia o cabeçalho Location da resposta e faça polling nele antes de acessar os arquivos de saída. Uma solicitação multipart aceita no máximo 100 arquivos; os limites de assinatura e totais de solicitação também se aplicam. Guarde as chaves de API no ambiente do seu servidor. O acesso à API exige uma assinatura Lite, Pro ou Max.
Ler o guia da APIcurl -i "https://api.markitdown.ai/v1/convert/pdf" \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F "file=@source.pdf"# If HTTP 202, GET the Location URL with the same API key.Guia
Revisar o resultado
Confira o resultado de PDF para Markdown contra o PDF original antes de usá-lo como evidência. Comece por uma página com colunas, uma nota de rodapé e uma tabela em vez de uma capa simples. Leia a última frase de uma coluna e a primeira da seguinte: elas devem formar a mesma sequência que uma pessoa segue no PDF. Depois compare um cabeçalho de tabela, um valor negativo e uma unidade. Uma pré-visualização de Markdown legível pode conter igualmente uma substituição do OCR ou uma célula mal posicionada. Se o documento orienta uma decisão financeira ou técnica, guarde o PDF junto do Markdown e verifique o trecho que você pretende citar. A conversão facilita trabalhar com o texto; ela não certifica a fonte nem sua transcrição.
O que muda
A conversão de PDF para Markdown substitui a posição visual por uma estrutura de texto. Um título grande pode virar um marcador de cabeçalho, os parágrafos continuam parágrafos e uma tabela aceita se transforma em linhas separadas por barras. A geometria da página, as linhas decorativas, as fontes e a quebra de linha original não fazem parte do contrato de saída. Isso é útil quando você quer editar um trecho ou construir um índice de recuperação, mas não serve quando o objetivo é reproduzir um folheto com exatidão. Guarde o PDF original pelo seu layout autorizado. Quando um layout não puder ser representado por uma tabela Markdown simples, verifique se uma breve explicação ou uma tabela revisada à mão é a representação posterior mais clara.
Fontes para RAG
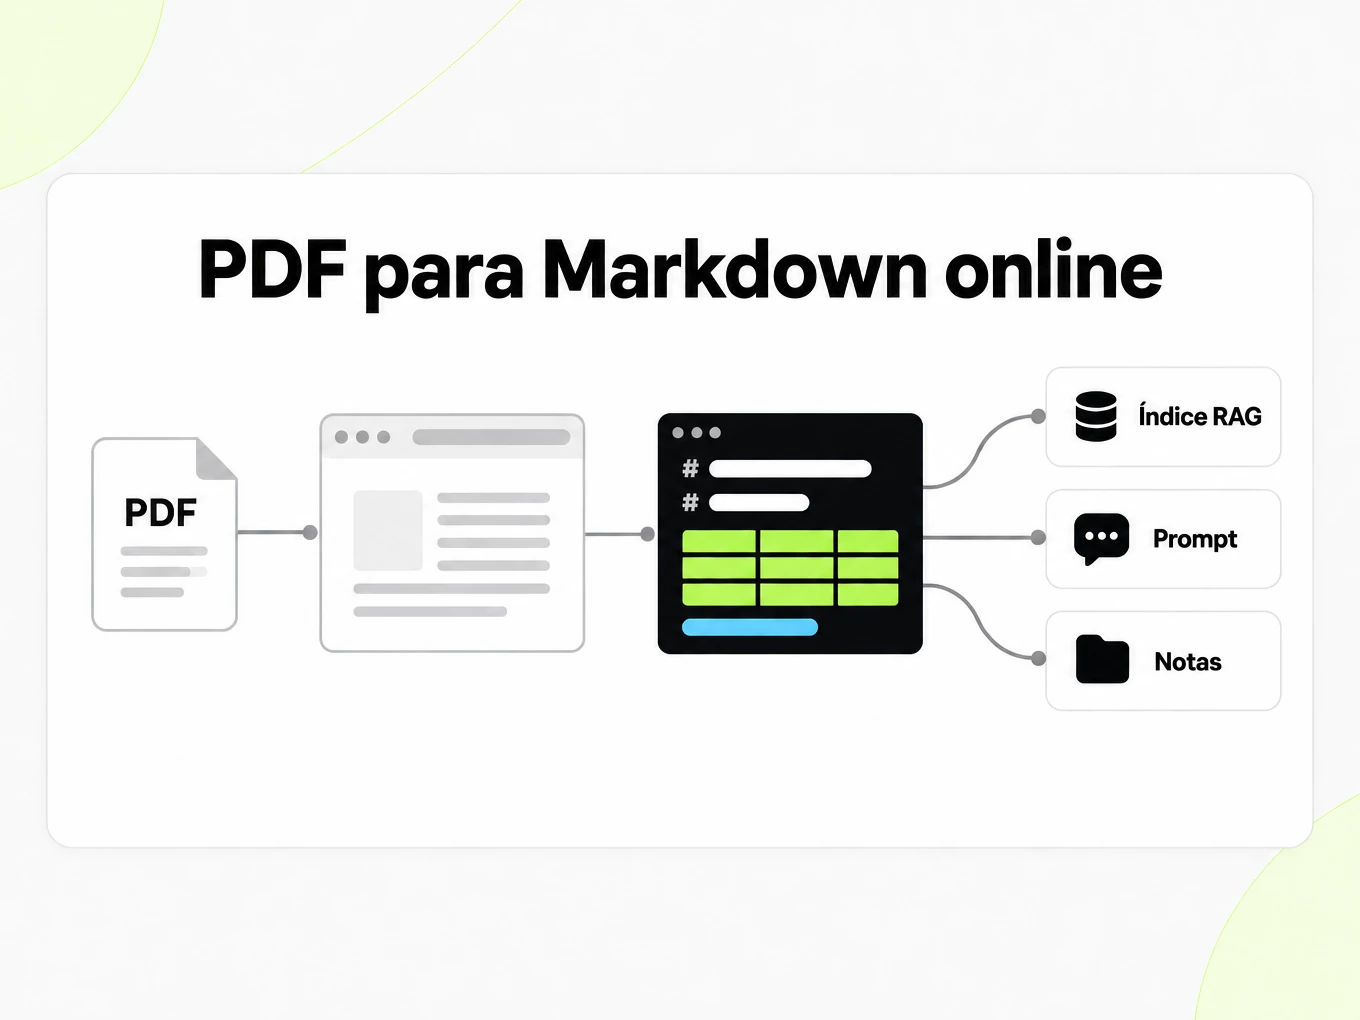
Use o título do PDF e cabeçalhos de seção significativos para preservar o contexto ao dividir o Markdown em blocos. Um bloco que só leva como cabeçalho Resultados pode ficar ambíguo quando sai do documento; seu código de ingestão pode conservar o nome do documento e o cabeçalho pai junto desse bloco. Mantenha um cabeçalho de tabela junto com suas linhas e evite cortar uma lista no meio de uma condição. Guarde a referência do PDF original à parte para que uma resposta recuperada possa levar o leitor de volta à fonte. LangChain e LlamaIndex podem consumir texto do seu próprio processo de ingestão, mas escolher o divisor, o modelo de embeddings e a política de recuperação continua sendo tarefa da sua aplicação. Teste a recuperação com perguntas cuja resposta você verificou no PDF.
Escolher o PDF
Dê preferência ao PDF exportado original quando ele contiver texto legível. Uma captura de tela desse PDF adiciona outra etapa de reconhecimento de imagem e pode perder caracteres pequenos antes que a conversão comece. Em PDFs digitalizados, endireite as páginas giradas e use uma versão em que a pontuação e as bordas das tabelas continuem legíveis com o zoom normal. Remova a senha antes de enviar um PDF criptografado. Se só uma parte de um relatório longo for relevante, prepare as páginas de origem pertinentes e conserve sua referência original nas suas notas. Repetir a mesma digitalização danificada dificilmente vai corrigir o detalhe que falta; melhore a fonte primeiro e depois compare o novo resultado de PDF para Markdown com o anterior.
Limites dos blocos
A qualidade da recuperação depende de os limites dos blocos coincidirem com o documento que uma pessoa leria. Este conversor reordena as colunas e preserva os níveis de título para que um divisor possa emitir passagens em vez de fragmentos entrelaçados de um artigo em duas colunas.
- Use o Markdown como o artefato que você divide e incorpora, não um despejo de texto achatado.
- As páginas padrão e as páginas com OCR são cobradas a 1 crédito por página nos planos com login.
- Arquivos protegidos com senha precisam ser desbloqueados antes do envio; PDFs criptografados são recusados.
Mais conversores de Markdown
- Word → MarkdownDOCX com títulos e listas
- PPT → MarkdownTexto, notas e tabelas de slides
- Excel → MarkdownCada planilha como tabela
- Image → MarkdownOCR para digitalizações e capturas de tela
- HTML → MarkdownCole ou envie HTML
- URL → MarkdownQualquer página web pública, limpa
- Markdown → HTMLHTML limpo e semântico
- Markdown → TextTexto simples sem marcação
- Markdown → PDFImprima localmente em PDF
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
Perguntas sobre PDF para Markdown
Como funciona PDF para Markdown?
PDF para Markdown converte a fonte aceita em Markdown legível para revisar e reutilizar. O teste anônimo aceita até 10 MB e 25 páginas por arquivo, com 3 conversões por IP e hora e 10 ao dia. Compare o resultado com a fonte antes de usá-lo.
Qual é o tamanho máximo de um PDF?
O conversor público aceita arquivos PDF de até 10 MB. O Lite aceita arquivos de até 100 MB; Pro e Max têm limites maiores.
Aceita PDFs digitalizados?
Sim. PDFs baseados em imagem são processados hoje com OCR; digitalizações nítidas e de alta resolução dão os melhores resultados.
Artigos de pesquisa com várias colunas são tratados?
Sim. PDF para Markdown tenta reconstruir a ordem de leitura. Compare as transições entre colunas com a fonte, porque layouts complexos ainda podem precisar de correção.
As tabelas financeiras vão sobreviver?
As tabelas dos PDFs que trazem metadados estruturais viram tabelas de Markdown. As tabelas de imagem achatada precisam de OCR para serem recuperadas.
Posso converter PDFs protegidos com senha?
Não. PDFs criptografados não podem ser analisados. Remova a senha antes de enviá-los.
O resultado serve para dividir em blocos para RAG?
O Markdown preserva títulos, listas e tabelas quando possível, de modo que a divisão em blocos e a inserção de embeddings continuam previsíveis em comparação com copiar e colar.
Posso converter PDF a partir de código?
Sim. Use uma chave de API para enviar o arquivo direto para /v1/convert/pdf e ler o Markdown na resposta. Veja /developers.
Converta PDF para Markdown em escala.
Teste de graça: não precisa se cadastrar.