
Conversor
Conversor de URL para Markdown
URL para Markdown é um conversor gratuito que transforma uma página web de acesso público em Markdown limpo do seu conteúdo principal — o artigo, a página de documentação ou a thread, sem a navegação do site — pronto para LLM, processos de RAG e anotações. Não precisa se cadastrar para testar; o teste permite 3 conversões por IP e hora e 10 ao dia.
Como funciona
Como converter uma página web para Markdown
O que você pode colar
- Qualquer página pública http(s): artigos, documentos, posts de blog
- Páginas atrás de um login ou de um paywall não podem ser baixadas
- A página é baixada no nosso servidor, sem executar o JavaScript dela
- Teste sem conta: até 10 MB e 25 páginas por arquivo, 3 conversões por hora e 10 ao dia
O que conferir
- Download no servidor — A página é baixada no servidor, pedindo primeiro Markdown e depois HTML; o Markdown próprio de um site só é usado se ele passar em um controle de qualidade.
- Extração do conteúdo principal — Vários extratores — pontuação de legibilidade, detecção de modelo repetido (boilerplate), análise de densidade de texto e o próprio elemento main ou article da página — competem entre si, e vence o que preserva mais estrutura e prosa.
- Páginas renderizadas com JavaScript — Um shell de aplicação vazio é renderizado em um navegador headless, que espera a página se estabilizar e então entrega o DOM renderizado para a mesma extração.
- Páginas públicas, tamanho e identidade — Só URLs de acesso público são aceitas: páginas atrás de autenticação, paywalls ou telas de login não podem ser baixadas.
Para onde vai o Markdown
- Copie o Markdown direto da pré-visualização
- Baixe o arquivo .md e guarde-o na sua biblioteca ao entrar
- Converta muitas páginas de uma vez com um array urls em POST /v1/convert/url
- Automatize com POST /v1/convert/url e sua chave de API
Por que usar
Por que usar este conversor de URL para Markdown
Uma página web é escrita para um navegador. O Markdown é escrito para pessoas e modelos. Este conversor encontra a parte da página que carrega o significado, preserva sua estrutura e deixa para trás os elementos decorativos do site.
Conteúdo principal, não a página inteira
Vários extratores leem a página e vence o resultado que preserva mais do artigo, então menus, avisos de cookies, rodapés e carrosséis de posts relacionados ficam fora do Markdown.
Estrutura que dura
Títulos, listas, tabelas e blocos de código chegam como Markdown, e todo link ou caminho de imagem relativo é reescrito como uma URL completa que continua funcionando fora da página.
Páginas com JavaScript também são renderizadas
Quando o HTML inicial é um shell de aplicação vazio, a página é renderizada em um navegador headless e esse conteúdo renderizado é convertido.
Grátis para testar, sem login
Pré-visualize e copie o Markdown sem conta, até 3 conversões por hora e 10 ao dia. Entre para baixar o arquivo .md.
Um baixador educado e identificado
Cada solicitação se identifica com um user agent documentado, e os donos dos sites podem bloqueá-lo: veja a página do baixador na documentação.
O mesmo motor da API
O conversor desta página e POST /v1/convert/url rodam o mesmo código, então um script pode converter até 20 URLs por chamada.
O problema
Por que uma página ativa é ruidosa para os modelos
As páginas são ruidosas
Páginas web ativas enterram o conteúdo sob navegação, anúncios, banners e scripts — muitas vezes com várias vezes mais texto que o próprio artigo.
A marcação é bagunçada
O HTML escrito à mão e o gerado raramente correspondem de forma limpa a uma estrutura legível.
A IA precisa do artigo
RAG e agentes querem o artigo, não os elementos de interface ao redor, e algumas páginas só mostram o artigo depois que o JavaScript é executado.
O que é preservado
O que este conversor de URL baixa
- Download no servidor
- A página é baixada no servidor, pedindo primeiro Markdown e depois HTML; o Markdown próprio de um site só é usado se ele passar em um controle de qualidade. Não é preciso nenhum plugin do navegador nem ferramenta local.Source: RFC 9110: HTTP Semantics
- Extração do conteúdo principal
- Vários extratores — pontuação de legibilidade, detecção de modelo repetido (boilerplate), análise de densidade de texto e o próprio elemento main ou article da página — competem entre si, e vence o que preserva mais estrutura e prosa. Sites conhecidos, como geradores de documentação, GitHub e Wikipédia, usam regras específicas do site.Source: HTML Living Standard: the main element
- Páginas renderizadas com JavaScript
- Um shell de aplicação vazio é renderizado em um navegador headless, que espera a página se estabilizar e então entrega o DOM renderizado para a mesma extração. Conteúdo que só aparece depois de um clique ou de uma rolagem não é capturado.Source: HTML Living Standard
- Páginas públicas, tamanho e identidade
- Só URLs de acesso público são aceitas: páginas atrás de autenticação, paywalls ou telas de login não podem ser baixadas. As páginas baixadas estão sujeitas a limites de tamanho de resposta, e o user agent do baixador está documentado em /docs/fetcher.Source: product pipeline
Exemplo: post do blog do markitdown.ai via download por URL· https://markitdown.ai/blog/why-pdfs-break-llms
# Why PDFs break LLMs — and what clean Markdown fixes _Published 2026-06-12 · The markitdown.ai team_ > A PDF that looks perfect to a human often falls apart the moment a model reads it. Here's what goes wrong, and why converting to clean Markdown first makes downstream AI far more reliable. A PDF renders perfectly for a human and falls apart the moment a model reads it. The page you see — columns, tables, headers, footnotes — is a *visual* arrangement, not a logical one. When you pull raw text out of it, that visual order rarely survives, and whatever you feed a language model is only as good as the text it actually receives. ## What actually goes wrong When teams pipe documents straight into an LLM or a retrieval index, a few failure modes show up again and again: - **Reading order breaks.** Multi-column layouts interleave. A two-column page becomes "line 1 left, line 1 right, line 2 left, line 2 right…", so a sentence a human reads top-to-bottom arrives at the model scrambled.- **Tables collapse.** Copy-paste turns a table into a loose run of numbers. The relationship between a header and its cell — the entire point of a table — is gone.- **Headings disappear.** The visual hierarchy (this is a section, this is a subsection) is encoded as font size and weight, not structure. Strip the styling and you get one undifferentiated wall of text. Casos de uso
Casos de uso da conversão de sites para Markdown
De agentes de IA a migrações de conteúdo, converter uma página web em Markdown é um passo pequeno do qual dependem muitos fluxos de trabalho.
Processos de IA e LLM
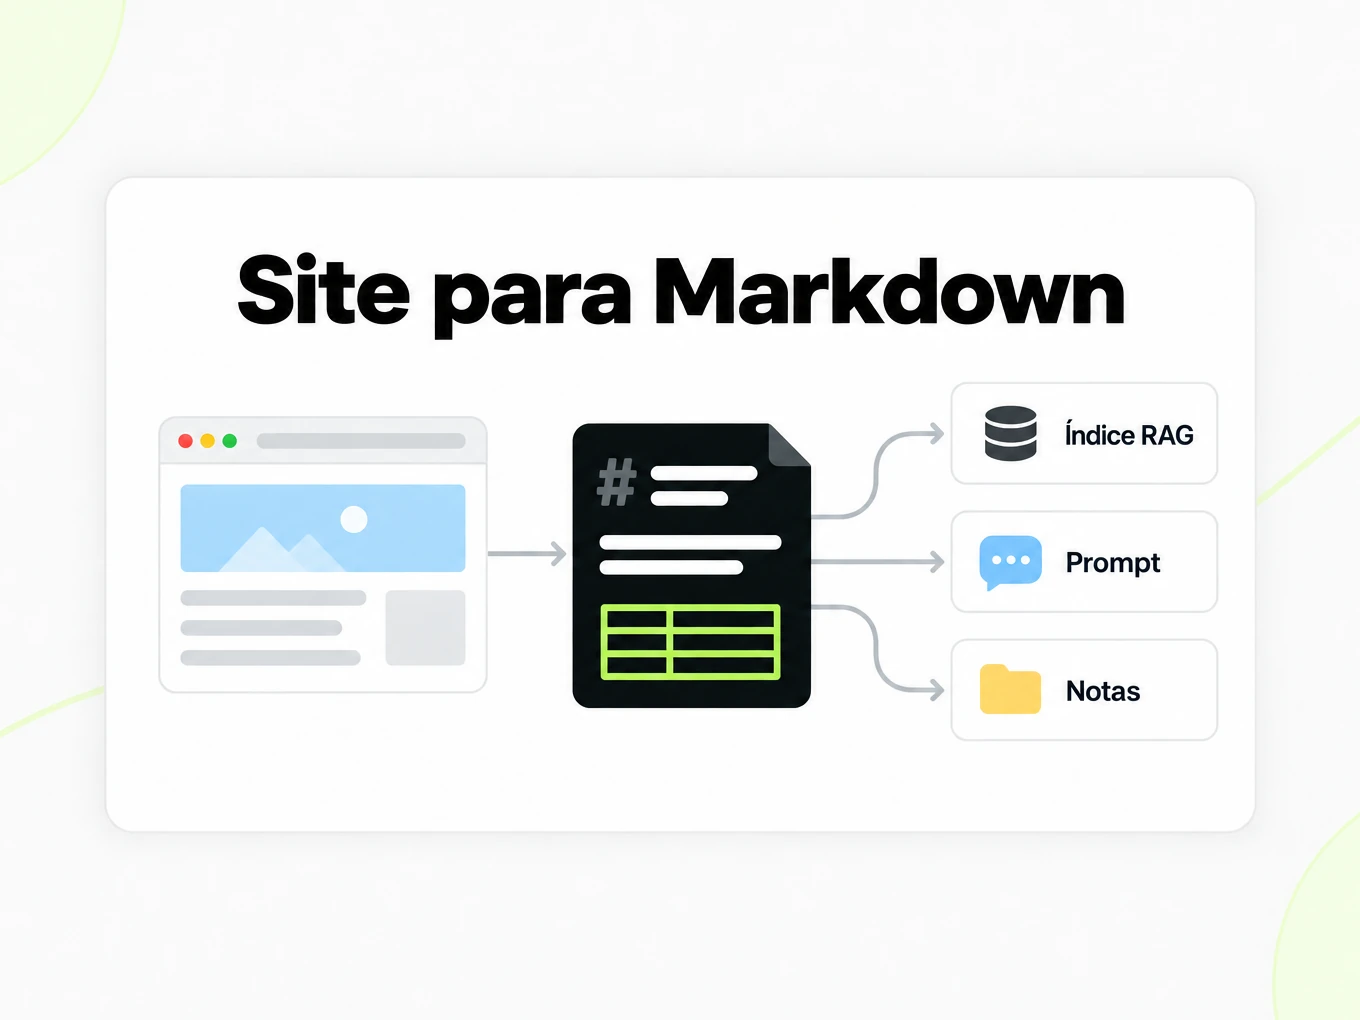
Alimente índices de RAG, ferramentas de agentes e prompts com artigos e documentação como texto limpo e com seus títulos intactos, em vez de HTML bruto.
Pesquisa e anotações
Guarde uma fonte como Markdown para citá-la, anotá-la ou conservá-la no Obsidian ou em um repositório de notas, com os links originais ainda no lugar.
Equipes de conteúdo
Leve posts e páginas de ajuda de um CMS para outro, ou leve material de referência para um site de documentação baseado em Markdown.
Desenvolvedores
Chame a API de jobs de ingestão e rastreadores que você já executa e obtenha o mesmo Markdown que o conversor do navegador mostra.
API
API de URL para Markdown para desenvolvedores
Vai converter páginas a partir de código? Envie uma URL —ou até 20 em um array urls— para POST /v1/convert/url com sua chave de API. Use render como auto, force ou skip para controlar a renderização de JavaScript, e frontmatter como true para colocar o título, o autor e a data de publicação da página no front matter YAML. O Markdown volta na mesma resposta quando a página termina dentro da janela de espera; caso contrário, você recebe uma conversão para consultar ou um webhook quando ela terminar. O acesso à API está nos planos pagos.
Ler o guia da APIcurl -X POST https://api.markitdown.ai/v1/convert/url \ -H "x-api-key: mdai_…" \ -H "content-type: application/json" \ -d '{"url":"https://markitdown.ai/blog/why-pdfs-break-llms","frontmatter":true}'Guia
Revisar o resultado
Revise o resultado de URL para Markdown junto da página pública que você enviou. O conversor preserva o conteúdo principal e deixa de fora navegação, avisos de cookies e links de rodapé, mas uma página sem um artigo claro — uma página de produto, uma landing page, uma página inicial com muitas chamadas — ainda pode perder um painel lateral ou manter um bloco que você não citaria. Confira os primeiros e os últimos parágrafos em relação à página antes de indexar o resultado. Páginas que constroem o conteúdo com JavaScript são renderizadas antes em um navegador; uma página que carrega o texto só depois de um clique, uma rolagem ou um login ainda não pode ser capturada. Quando um site já oferece seu próprio Markdown para clientes que o pedem, o conversor usa essa versão se ela passar em um controle de qualidade, e recorre à página HTML quando ela parece um menu do site inteiro ou um despejo de arquivo. Guarde a URL de origem junto do Markdown para que um leitor possa voltar à página original.
Preservar o contexto de origem
Guarde a URL enviada e a sua data de recuperação junto de um resultado de URL para Markdown no seu próprio fluxo de trabalho. Uma página pública pode mudar depois que você a converte, então um visitante posterior pode ver um trecho revisado. Com o front matter ativado, o resultado começa com a URL de origem, a URL canônica, o título e, quando a página os declara, o autor, a data de publicação, a descrição, o nome do site, o idioma e a imagem principal, lidos das meta tags, dos dados estruturados e da assinatura da página. Esses campos repetem o que a página diz sobre si mesma; confira-os na fonte se a sua pesquisa depender deles. O campo de metadados da API é diferente: ele só carrega o contexto que você fornece. Antes de citar uma tabela ou um parágrafo, compare-o com a página e conserve contexto suficiente ao redor para não mudar seu significado. O Markdown torna o conteúdo web mais fácil de reutilizar; ele não determina se a página é exata nem se você tem permissão para republicá-la.
HTML salvo versus URL
Escolha o conversor de HTML quando você já tiver o instantâneo exato da página que precisa processar. Escolha URL para Markdown quando um endereço de acesso público for a entrada da conversão atual. São fluxos de trabalho relacionados com controles de origem distintos: um arquivo salvo fixa a entrada que você envia e é convertido por completo, enquanto uma URL depende do que o site devolve no momento da solicitação e é reduzida ao seu conteúdo principal. Nenhuma das duas rotas contorna as restrições de acesso. Se um site nega o baixador ou exige login, use material que você está autorizado a obter por um fluxo de trabalho adequado. Não tente repetidamente uma URL inacessível como se outra tentativa de conversão concedesse acesso.
Pesquisa com LLM
Pesquisadores colam uma fonte, não um arquivo. Este conversor baixa a URL que você envia, preserva o corpo do artigo ou da documentação e devolve Markdown que você pode citar, dividir em blocos ou deixar cair em um gerenciador de notas, com links que continuam funcionando. Ele renderiza páginas com JavaScript quando o servidor envia um shell vazio, e não faz login atrás de paywalls.
- Só URLs de acesso público são aceitas.
- O baixador se identifica; os operadores podem negar o user agent: veja /docs/fetcher.
- Arquivos HTML salvos vão em /html-to-markdown, não aqui.
Mais conversores de Markdown
- PDF → MarkdownTexto, tabelas e digitalizações
- Word → MarkdownDOCX com títulos e listas
- PPT → MarkdownTexto, notas e tabelas de slides
- Excel → MarkdownCada planilha como tabela
- EPUB → MarkdownCapítulos de ebooks como títulos
- Image → MarkdownOCR para digitalizações e capturas de tela
- HTML → MarkdownCole ou envie HTML
- Markdown → HTMLHTML limpo e semântico
- Markdown → TextTexto simples sem marcação
- Markdown → PDFImprima localmente em PDF
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
Perguntas sobre URL para Markdown
Como funciona URL para Markdown?
URL para Markdown baixa a página pública que você cola, preserva seu conteúdo principal e converte isso em Markdown com links de URL completa — sem arquivo para enviar. Páginas que precisam de JavaScript são renderizadas antes em um navegador.
Ele remove os anúncios e a navegação de uma página ativa?
Sim, em páginas com uma área de conteúdo principal clara. URL para Markdown preserva o artigo, o corpo da documentação ou a thread e descarta menus, avisos de cookies e rodapés; uma landing page ou página de produto sem um bloco principal claro ainda pode manter ou perder um painel lateral, então confira o resultado.
Há limites de tamanho para uma página baixada?
O conversor público funciona com páginas web públicas. As páginas baixadas estão sujeitas a limites de tamanho de resposta e podem ser recusadas se forem grandes demais.
Funciona em páginas atrás de um login?
Não. Só URLs de acesso público são aceitas. Páginas atrás de autenticação, paywalls ou telas de login não podem ser baixadas.
E as páginas renderizadas com JavaScript?
Páginas renderizadas com JavaScript são renderizadas em um navegador headless quando o HTML inicial é um shell vazio, e depois convertidas como qualquer outra página. Na API, render definido como force sempre renderiza e skip nunca renderiza. Texto que só aparece depois de um clique, uma rolagem ou um login não é capturado.
Posso converter várias URLs de uma vez?
Envie um array urls com até 20 URLs públicas para POST /v1/convert/url. Acompanhe o resultado de cada arquivo e lide com as respostas assíncronas. Veja /developers.
URL para Markdown é grátis?
Sim. Pré-visualizar e copiar o Markdown é grátis sem conta, até 3 conversões por hora e 10 ao dia; baixar o arquivo .md exige login. Apenas páginas web públicas (sem URLs internas nem privadas).
Que conteúdo o conversor preserva?
O conversor preserva os títulos, parágrafos, listas, links, imagens, tabelas e blocos de código do conteúdo principal, com os links relativos reescritos como URLs completas. Scripts, estilos, navegação e rodapés são descartados; com o front matter ativado, o título, o autor e a data de publicação da página ficam no topo.
Existe uma API de conversão por URL?
Sim. Converta páginas web por URL de forma programática pela API REST. Veja /developers. Arquivos HTML salvos usam /html-to-markdown.
Converta URL para Markdown em escala.
Teste de graça: não precisa se cadastrar.