
Convertidor de Markdown para documentos y páginas web.
Un convertidor de Markdown para documentos y páginas web públicas: PDF, Word, PowerPoint, Excel, imágenes y HTML se convierten en texto que puedes inspeccionar, reutilizar y pasar a un flujo de trabajo con IA.
Prueba anónima · 10 MB · 3 conversiones / hora · 10 / día
Convierte a Markdown desde
- DOCX
- PPTX
- XLSX
- PNG / JPG
- HTML
- URL
Cómo funciona
Convertidor de Markdown: cómo funciona
markitdown.ai es un convertidor de Markdown que convierte PDF, archivos de Office, imágenes y páginas web en Markdown limpio y listo para IA para ChatGPT, Claude, pipelines RAG y agentes, mediante una prueba anónima o una cuenta de pago con acceso a la API para desarrolladores.
What happens
Sube un archivo o pega una URL. La conversión se ejecuta en nuestros servidores, no como un copiar y pegar del navegador, así que el mismo archivo produce el mismo Markdown venga de donde venga. Cada página se procesa según lo que contiene, y los encabezados, las listas y las tablas salen como estructura Markdown real.
What you get
- Las páginas con capa de texto se leen directamente; los escaneos y las imágenes pasan por OCR automáticamente
- Las descargas de URL se ejecutan desde nuestros servidores, con direcciones privadas e internas bloqueadas
- Convertidor público: hasta 10 MB y 25 páginas, sin iniciar sesión
- Los planes con sesión suben ambos límites, hasta 200 MB y 200 páginas en Pro
What happens
El visor coloca el documento de origen y el Markdown generado uno al lado del otro, para que compruebes encabezados, tablas y orden de lectura antes de usar el resultado. Cambia entre la vista previa renderizada y el Markdown sin procesar para ver exactamente lo que recibirá un modelo o un pipeline.
What you get
- El origen y el Markdown se muestran en paralelo en el visor
- Cambia el panel de Markdown entre la vista previa renderizada y el código sin procesar
- Copia el resultado gratis, sin necesidad de cuenta
- Descarga el archivo .md cuando inicies sesión
What happens
Los mismos ajustes que funcionaron para un archivo sirven para una pila de archivos o una llamada de pipeline, y cada resultado queda en tu Biblioteca. Batch sigue cada archivo con su propio estado y reintento, y la API entrega el mismo Markdown directamente a tu código.
What you get
- El mismo motor de análisis para la aplicación web, Batch (ZIP o una lista de URL) y la API
- POST /v1/convert/{name} devuelve Markdown en una sola llamada en 60 segundos, o una conversión que consultas o recibes por webhook
- La Biblioteca conserva cada ejecución durante la ventana de historial de tu plan: 30, 60 o 90 días
Créditos
Precisión en Markdown, con precio por página.
Una factura con capa de texto y un balance escaneado cuestan lo mismo por página: el pipeline elige la extracción directa o el OCR por ti. Los extras de IA para figuras e imágenes son opcionales y se miden por separado.
- por página, texto o escaneo
- 1 crédito
- por página, texto o escaneo
PDF con capa de texto, archivos de Office y HTML
OCR para páginas escaneadas, fotos y capturas de pantalla
Gráficos y figuras descritos en PDF · planes de pago
Contenido de la imagen descrito, no solo OCR · planes de pago
API de Markdown
Una API de Markdown para tu pipeline RAG.
- El mismo pipeline de análisis que la aplicación web
- Miles de archivos por lotes con webhooks al completarse
- Claves de API con alcance y un registro de actividad completo
- Markdown en una sola llamada, o una conversión que consultar cuando un archivo tarda más de 60 segundos
curl -X POST https://api.markitdown.ai/v1/convert/word \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F file=@vendor-security-review-q3-2026.docx # If HTTP 202, GET the Location URL with the same API key.# Verified local parser output for vendor-security-review-q3-2026.docx:# ## Review Findings# # Risk ratings follow the standard High / Medium / Low scale defined in the vendor risk management policy.# # | Vendor | Risk Rating | Finding | Owner |# | --- | --- | --- | --- |# | CloudScan OCR | Medium | No documented data retention limit on uploaded scans | Security |# | PayBridge | Low | SOC 2 Type II renewed; no open items | Finance |# | LingoTrans API | High | Sub-processor list not disclosed on request | Legal |# | ArchiveNow Storage | Medium | Encryption at rest confirmed; key rotation overdue | Security |Precios
Precios simples para la conversión a Markdown.
El problema
Los documentos no están listos para la IA
La mayoría de los documentos se crearon para personas e impresoras, no para modelos de lenguaje. Antes de poder incrustar, recuperar o razonar sobre un archivo, hay que convertirlo en texto predecible. Eso es más difícil de lo que parece, y es exactamente donde falla la extracción ingenua.
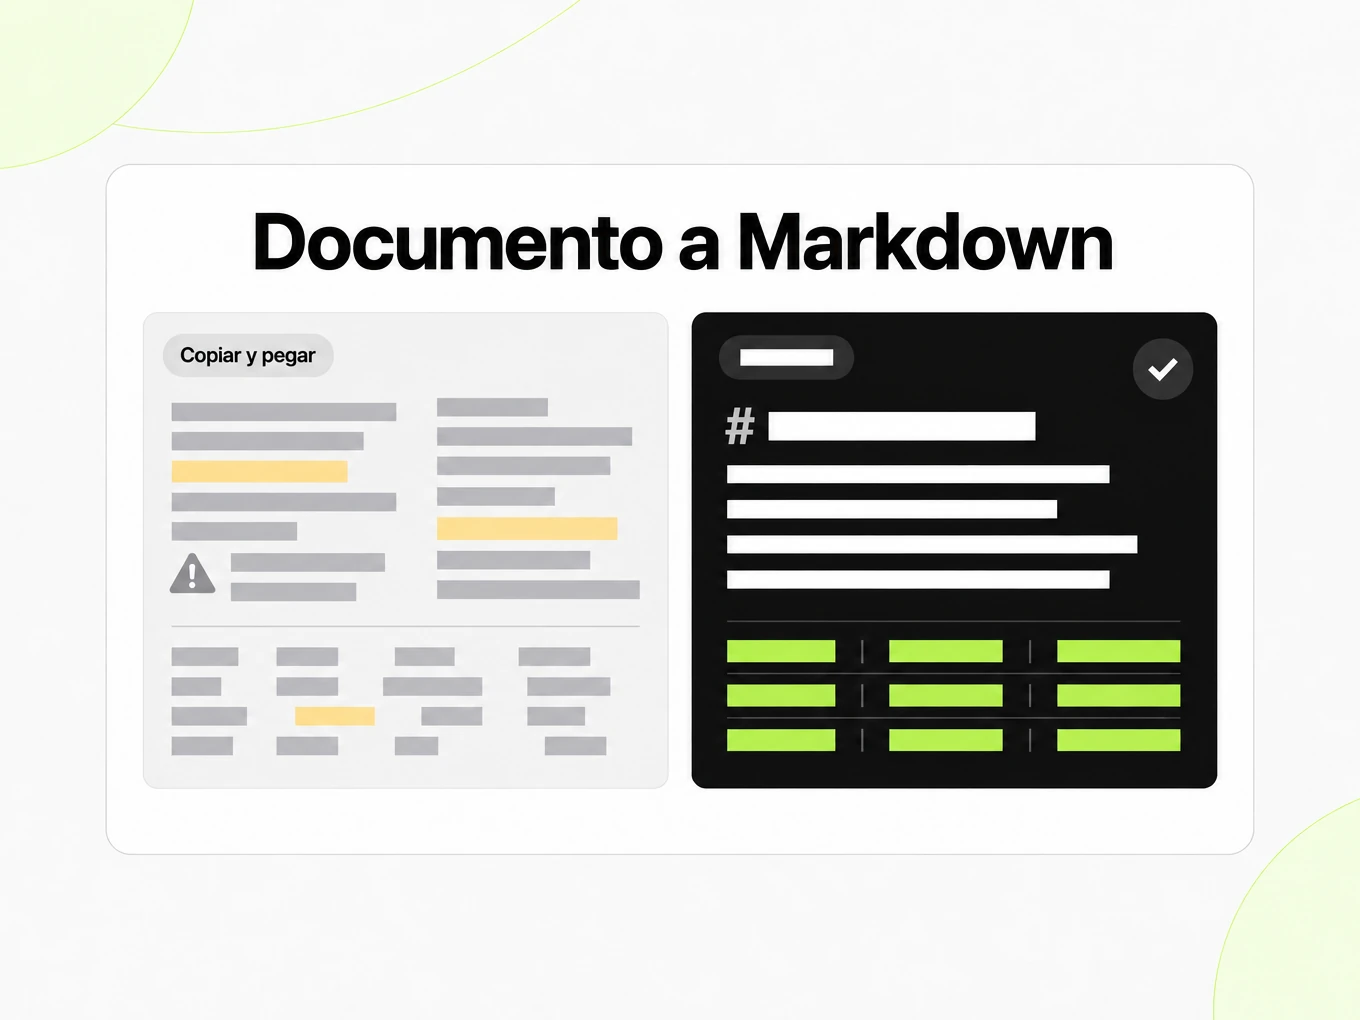
El orden de lectura se rompe
Los PDF a varias columnas, los encabezados y las notas al pie se entrelazan, y el texto que lee un LLM ya no coincide con el documento que ve una persona.
Las tablas y los encabezados se aplanan
Copiar y pegar colapsa las tablas en series de números y elimina la jerarquía de encabezados que da estructura al documento.
Los escaneos necesitan OCR
Las páginas basadas en imagen y los contratos escaneados no tienen ninguna capa de texto hasta que pasan por reconocimiento óptico de caracteres.
El texto sin procesar tiene ruido
La extracción improvisada deja números de página, guiones partidos y caracteres sueltos que contaminan los prompts y los resultados de recuperación.
Los pipelines RAG y los agentes necesitan una estructura coherente, no solo caracteres extraídos. El Markdown predecible es lo que hace que el troceado, la incrustación y la recuperación se comporten igual en miles de documentos en lugar de fallar en silencio con los más desordenados. El analizador que maneja los archivos difíciles es lo que mantiene fiables los limpios.
Formatos de entrada
Convierte cualquier documento a Markdown
Cada formato de entrada tiene su propia página de conversión con límites, notas de formato y una muestra de salida. Todas comparten un mismo motor de análisis, así que elige la página que corresponda a tu archivo:
- PDF a Markdown — informes, artículos, manuales y contratos. Los PDF con texto nativo se analizan directamente y se reconstruye el orden de lectura a varias columnas; los PDF escaneados pasan por OCR página a página.
- Word a Markdown — archivos .docx y .doc heredados con encabezados, listas, tablas y comentarios conservados, para que una política o una especificación se lean como un esquema en lugar de un solo bloque.
- PPT a Markdown — presentaciones .pptx y .ppt diapositiva a diapositiva, con los títulos de diapositiva como encabezados y las viñetas y tablas conservadas, lo que hace que una presentación de 40 diapositivas sea buscable.
- Excel a Markdown — libros .xlsx y .xls en los que cada hoja se convierte en una tabla Markdown bajo el nombre de la hoja.
- Imagen a Markdown — capturas de pantalla y escaneos PNG y JPG mediante OCR. La comprensión de imágenes con IA es una opción aparte, con sesión iniciada.
- HTML a Markdown — páginas guardadas, exportaciones y fragmentos, con los scripts y estilos eliminados y la estructura del artículo, los enlaces y las tablas conservados.
- URL a Markdown — pega una dirección web pública y obtén la página en Markdown, descargada en el servidor con un límite de tamaño y un tiempo de espera para que un sitio lento no bloquee la solicitud.
Formatos de salida
De Markdown a cualquier formato
Markdown es el formato de intercambio, así que la conversión también funciona en sentido contrario. Los editores de Markdown de abajo se renderizan mientras escribes en el navegador y nunca suben tu texto:
- Markdown a HTML — HTML semántico y limpio con tablas estilo GitHub, listas de tareas y resaltado de código, listo para pegar en un CMS o un correo.
- Markdown a texto — texto plano con encabezados, listas y tablas aplanados de forma legible para ventanas de chat, tickets y formularios.
- Markdown a PDF — una vista previa de impresión local; usa Imprimir / Guardar como PDF en tu navegador y revisa las páginas guardadas.
La extracción de JSON estructurado y la transcripción de audio y vídeo son capas planificadas sobre Markdown. Se listan como hoja de ruta, no como funciones ya disponibles.
Casos de uso
Hecho para todos los equipos
El convertidor de Markdown ofrece una prueba anónima para comprobar un primer resultado. La razón por la que los equipos siguen usándolo es todo lo que viene después del primer archivo: historial, lotes, documentos más grandes y una API que integra la conversión en los sistemas que ya usas. El mismo Markdown funciona tanto si lo consume una persona como un índice de búsqueda o un modelo.
RAG y pipelines de IA
Convierte documentos de origen en Markdown limpio antes del troceado, la incrustación o el procesamiento por agentes. Una estructura predecible hace que tu divisor vea encabezados y tablas reales en lugar de un muro de texto extraído, lo que mantiene la recuperación relevante y los prompts libres de ruido de maquetación.
Investigación e informes
Convierte artículos, libros blancos y presentaciones en Markdown editable y buscable. Los investigadores y analistas pueden citar, anotar, resumir y reutilizar hallazgos sin volver a teclear tablas ni perder el orden de lectura de un PDF denso.
Documentos de operaciones
Procesa políticas, contratos, facturas y archivos internos sin limpiar copiar y pegar a mano. Un historial de Markdown guardado hace que el trabajo documental recurrente sea más fácil de revisar, comparar y reutilizar en el día a día de un equipo.
Automatización para desarrolladores
Usa la API para convertir archivos dentro de trabajos de ingesta, herramientas internas y flujos de documentos. Envía una solicitud, recibe Markdown y llévalo a un CMS, una base de conocimiento, un bot de soporte o un pipeline de agentes con una salida fiable.
Bases de conocimiento y soporte
Lleva manuales de producto, notas de versión y wikis internas a un único corpus Markdown que un bot de soporte o un asistente interno pueda buscar. Como los encabezados y las tablas sobreviven, las respuestas apuntan a la sección correcta en lugar de a un bloque del tamaño de una página.
Agentes y herramientas
Dale a un agente un convertidor de Markdown para archivos compatibles y URL públicas, y comprueba la finalización antes de que consuma el resultado. Lee este sitio del mismo modo: cada página pública responde a Accept: text/markdown con un gemelo en Markdown, y llms.txt los lista todos.
Calidad de salida
Estructura, no solo texto
Un convertidor de Markdown útil conserva más que caracteres aislados de un PDF. El objetivo aquí es un Markdown que mantenga la estructura de la que dependen tus herramientas posteriores, producido por un pipeline de análisis en el servidor en lugar de un frágil copiar y pegar del navegador.
- Conserva encabezados, listas, tablas, enlaces y orden de lectura allí donde el origen los tiene.
- Maneja PDF, Word, PowerPoint, Excel, imágenes, HTML y URL con un solo pipeline.
- Procesa PDF escaneados e imágenes con OCR hoy; la calidad del reconocimiento depende de la imagen de origen.
- Ejecuta documentos largos de forma asíncrona, para que los informes y presentaciones grandes terminen en lugar de agotar el tiempo.
Las páginas estándar y las páginas OCR cuestan 1 crédito por página; las cuentas con plan de pago pueden usar la comprensión de imágenes con IA a 5 créditos por imagen. La salida sigue CommonMark con tablas estilo GitHub, así que se renderiza en cualquier visor de Markdown y se analiza con cualquier biblioteca de Markdown. Cada conversión debe producir un artefacto que puedas inspeccionar, guardar y reutilizar: ese es el listón.
Tres formas de entrar
Navegador, API o agente
El convertidor de Markdown en la aplicación web cubre la conversión manual puntual y recurrente. Batch cubre pilas de archivos. La API cubre todo lo que deba ocurrir de forma automática, incluidos los agentes que la llaman como herramienta. Los tres comparten una cuenta, un saldo de créditos y un motor de análisis. La mayoría de los equipos empiezan en el navegador y pasan a la API cuando la conversión forma parte de un producto o de un flujo de trabajo interno.
| Aspect | Navegador | Batch | API |
|---|---|---|---|
| Ideal para | Un archivo a la vez | Muchos archivos en una ejecución | Pipelines, herramientas y agentes |
| Inicio de sesión | No hace falta para el primer archivo | Planes de pago | Planes de pago, clave de API |
| Entrada | Subida o URL | Una lista de subidas o IDs de archivo | Subida, URL, texto en línea o ID de archivo |
| Salida | Vista previa, copia, descarga .md | Biblioteca con estado por archivo | JSON con Markdown, salida por página, webhooks |
| Límites | 10 MB y 25 páginas sin iniciar sesión | Concurrencia del plan | 20 a 60 solicitudes por minuto según el plan |
| Espera | Segundos, en la página | En segundo plano | Sincronización hasta 60 s, luego una conversión que consultar |
Aplicación web
- Sube archivos o pega URL y previsualiza el Markdown renderizado
- Guarda el historial de conversiones y descarga los resultados .md
- Convierte por lotes el trabajo repetido con estado por archivo
- Controla los créditos y el uso por plan
API para desarrolladores
- POST /v1/convert/{name} devuelve Markdown en una sola llamada, o una conversión cuando un archivo tarda más de 60 segundos
- Consulta conversiones o recibe webhooks cuando terminan
- Envía Accept: text/markdown para leer cualquier página pública como Markdown
- Especificación legible por máquina en /v1/openapi.json
FAQ
Preguntas que hacen los equipos
Convertidor de Markdown: ¿qué hace?
Un convertidor de documento a Markdown es una herramienta que lee un PDF, Word, PowerPoint, Excel, una imagen o una página web y reescribe su contenido como Markdown: los encabezados pasan a líneas #, las tablas a tablas de barras y las listas siguen siendo listas. La idea es obtener texto plano predecible que los modelos de lenguaje, los pipelines RAG y los agentes puedan trocear, incrustar y citar sin ruido de maquetación.
¿El convertidor gratuito es de verdad gratuito?
Sí. Las páginas del convertidor público no necesitan cuenta ni tarjeta. Los archivos de hasta 10 MB y 25 páginas se convierten en el navegador, y puedes previsualizar y copiar el Markdown. Las suscripciones Lite, Pro y Max empiezan en $20 al mes y añaden biblioteca guardada, lotes y la API.
¿Cómo funcionan los PDF escaneados y las imágenes?
Las páginas solo de imagen no tienen capa de texto, así que el pipeline ejecuta OCR automáticamente y devuelve Markdown igual que con texto digital. Las páginas estándar y las páginas OCR cuestan 1 crédito por página. La calidad del reconocimiento depende de la imagen de origen: un escaneo a 300 dpi se lee mucho mejor que la foto de una página hecha con el móvil.
¿Puedo ejecutarlo desde código o desde un agente?
Sí. POST /v1/convert/{name} acepta una subida, una URL o texto en línea con una clave de API y devuelve Markdown en una sola llamada cuando el archivo termina en 60 segundos, o una conversión que puedes consultar o recibir por webhook. Los agentes pueden pedir Accept: text/markdown en cualquier página pública, y la especificación legible por máquina está en /v1/openapi.json.
¿Qué pasa con mis archivos después de la conversión?
Al eliminar una conversión, esta desaparece de tu biblioteca de inmediato y sus archivos almacenados se borran en el plazo de una hora; un archivo de origen compartido con otra conversión se conserva hasta que esa también se elimine. Al eliminar tu cuenta se borran todos los archivos de origen y de resultado almacenados. Los planes de pago conservan el historial durante 30, 60 o 90 días según el plan.
Convierte tu primer archivo a Markdown.
Pruébalo gratis: no hace falta registrarse.