
Convertidor
Convertidor de PDF a Markdown
PDF a Markdown es un conversor que reconstruye el orden de lectura de varias columnas en Markdown estructurado para RAG. La prueba pública acepta archivos de hasta 10 MB.
Prueba un archivo antes de elegir un plan.
- Sin cuenta: hasta 10 MB y 25 páginas por archivo, 3 conversiones por hora y 10 al día, con vista previa y copia en el navegador.
- Con sesión: 20 conversiones gratis al día, guardadas en tu biblioteca.
- Lite, Pro y Max incluyen créditos de conversión, procesamiento por lotes, acceso a la API e historial guardado. Lite incluye 30 días de historial.
Cómo se hace
Cómo convertir PDF a Markdown
Qué puedes subir
- Tipos de archivo: .pdf
- Pruébalo sin cuenta: hasta 10 MB y 25 páginas por archivo, 3 conversiones por hora y 10 al día
- Lite admite archivos de hasta 100 MB y Pro de hasta 200 MB
- Max no tiene límite de tamaño por archivo; las conversiones se limitan por créditos
Qué revisar
- Reconstrucción del orden de lectura — La conversión de PDF intenta reconstruir un orden de lectura lógico.
- Tablas y encabezados — Los niveles de encabezado y los datos tabulares se conservan cuando el PDF expone metadatos estructurales; los PDF de texto plano producen una salida de texto plano.
- PDF escaneados y solo de imagen — Los PDF sin capa de texto (páginas escaneadas e imágenes insertadas) se procesan hoy con OCR; la precisión depende de la calidad del escaneo.
- Archivos protegidos con contraseña — Los PDF cifrados no se pueden analizar; elimina la contraseña antes de subirlos.
A dónde va el Markdown
- Copia el Markdown directamente desde la vista previa
- Descarga el archivo .md y guárdalo en tu biblioteca al iniciar sesión
- Convierte carpetas enteras o archivos ZIP con la conversión por lotes
- Automatízalo con POST /v1/convert/pdf y tu clave de API
Por qué usarlo
Por qué usar PDF a Markdown
Informes como texto legible
Convierte los párrafos y la estructura compatible de un informe en Markdown que puedes inspeccionar, editar y conservar junto al PDF de origen.
OCR para páginas escaneadas
Las páginas solo de imagen se pueden reconocer con OCR. Compara el texto pequeño, la puntuación y las tablas numéricas con el escaneo original.
Contexto de los encabezados
Conserva secciones reconocibles para apuntes y flujos de recuperación, y comprueba al mismo tiempo si los encabezados con estilo visual se interpretaron correctamente.
Tablas que revisar
Las tablas compatibles se convierten en tablas de texto. Revisa las celdas complejas o combinadas antes de tratar los valores exportados como evidencia.
Previsualiza antes de reutilizar
Compara el código Markdown con su vista renderizada antes de copiar un pasaje en ChatGPT, Claude o un repositorio de documentación.
Una ruta de API repetible
Usa la ruta de conversión de PDF en un script de ingesta después de revisar en el navegador resultados representativos.
El problema
Por qué las columnas de un PDF rompen los modelos de lenguaje
Las columnas se entrelazan
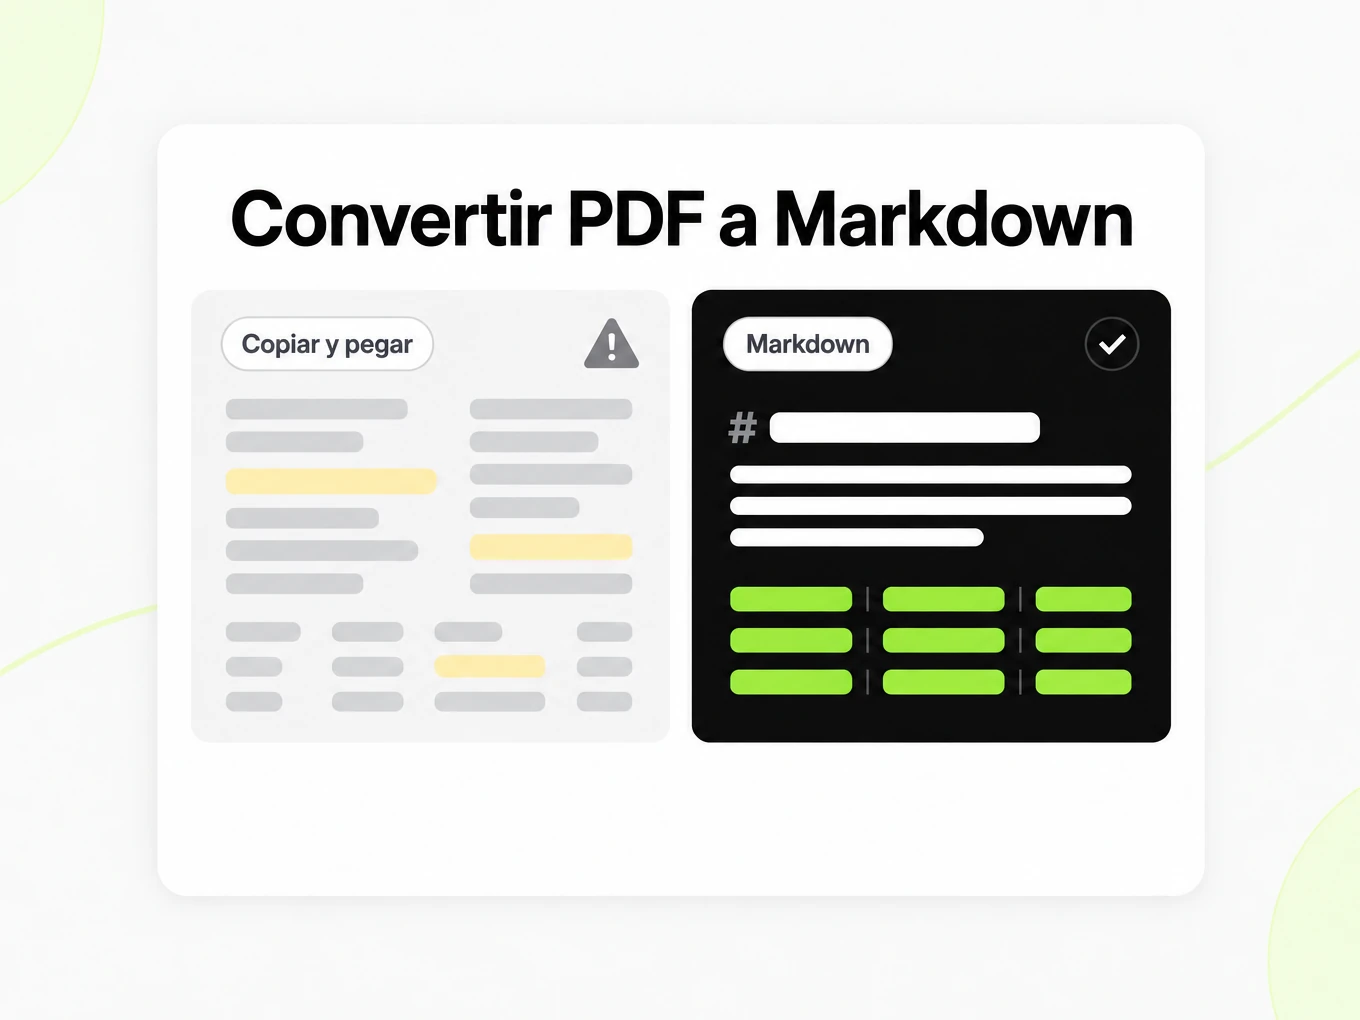
Un informe a dos columnas leído de arriba abajo mezcla el flujo izquierdo y el derecho, así que el modelo ve una frase que nunca existió en la página.
Las tablas pierden su cuadrícula
Copiar y pegar desde un PDF convierte una tabla de resultados en una sucesión de números sin fila de encabezado para un analizador posterior.
Los escaneos no tienen capa de texto
Las páginas solo de imagen contienen píxeles, no glifos, así que los PDF escaneados se procesan hoy con OCR.
Qué se conserva
Qué conserva este conversor de PDF
- Reconstrucción del orden de lectura
- La conversión de PDF intenta reconstruir un orden de lectura lógico. Revisa las transiciones entre columnas contra el original, sobre todo en informes y artículos complejos.Source: ISO 32000-2 (PDF 2.0)
- Tablas y encabezados
- Los niveles de encabezado y los datos tabulares se conservan cuando el PDF expone metadatos estructurales; los PDF de texto plano producen una salida de texto plano.Source: CommonMark Spec
- PDF escaneados y solo de imagen
- Los PDF sin capa de texto (páginas escaneadas e imágenes insertadas) se procesan hoy con OCR; la precisión depende de la calidad del escaneo.Source: product pipeline
- Archivos protegidos con contraseña
- Los PDF cifrados no se pueden analizar; elimina la contraseña antes de subirlos.Source: ISO 32000-2 (PDF 2.0)
Ejemplo: NIST Cybersecurity Framework 2.0, página 15· https://nvlpubs.nist.gov/nistpubs/CSWP/NIST.CSWP.29.pdf
## Appendix A. CSF Core This appendix describes the Functions, Categories, and Subcategories of the CSF Core. Table 1 lists the CSF 2.0 Core Function and Category names and unique alphabetic identifiers. Each Function name in the table is linked to its portion of the appendix. The order of Functions, Categories, and Subcategories of the Core is not alphabetical; it is intended to resonate most with those charged with operationalizing risk management within an organization. The numbering of the Subcategories is intentionally not sequential; gaps in numbering indicate CSF 1.1 Subcategories that were relocated in CSF 2.0. **Table 1. CSF 2.0 Core Function and Category names and identifiers** | Function | Category | Category Identifier || --- | --- | --- || **Govern (GV)** | Organizational Context | GV.OC || | Risk Management Strategy | GV.RM || | Roles, Responsibilities, and Authorities | GV.RR || | Policy | GV.PO || | Oversight | GV.OV || | Cybersecurity Supply Chain Risk Management | GV.SC || **Identify (ID)** | Asset Management | ID.AM || | Risk Assessment | ID.RA || | Improvement | ID.IM || **Protect (PR)** | Identity Management, Authentication, and Access Control | PR.AA || | Awareness and Training | PR.AT || | Data Security | PR.DS || | Platform Security | PR.PS || | Technology Infrastructure Resilience | PR.IR || **Detect (DE)** | Continuous Monitoring | DE.CM || | Adverse Event Analysis | DE.AE | Casos de uso
PDF a Markdown en flujos de trabajo reales
Notas de investigación
Extrae un artículo a notas editables, verifica los pasajes citados y conserva la referencia del PDF para revisarlo más tarde.
Ingesta de informes
Prepara informes para su fragmentación conservando los encabezados de tabla, el contexto de sección y un enlace al documento original.
Bibliotecas de normativas
Convierte una normativa revisada en texto que se puede buscar y conserva el PDF publicado como versión autorizada.
Evaluación de documentos
Compara PDF representativos antes de automatizar una colección, incluidos escaneos, columnas y una tabla difícil.
API
PDF a Markdown API
Usa POST /v1/convert/pdf con una cabecera x-api-key y un archivo de origen compatible. Una solicitud completada puede devolver los resultados en la propia respuesta; un HTTP 202 significa que la conversión sigue en curso. Lee la cabecera Location de la respuesta y haz sondeos sobre ella antes de acceder a los archivos de salida. Una solicitud multipart acepta como máximo 100 archivos; también se aplican los límites de suscripción y totales de solicitud. Guarda las claves de API en el entorno de tu servidor. El acceso a la API requiere una suscripción Lite, Pro o Max.
Leer la guía de la APIcurl -i "https://api.markitdown.ai/v1/convert/pdf" \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F "file=@source.pdf"# If HTTP 202, GET the Location URL with the same API key.Guía
Revisar el resultado
Comprueba el resultado de PDF a Markdown contra el PDF original antes de usarlo como evidencia. Empieza por una página con columnas, una nota al pie y una tabla en lugar de una portada sencilla. Lee la última frase de una columna y la primera de la siguiente: deberían formar la misma secuencia que sigue una persona en el PDF. Después compara un encabezado de tabla, un valor negativo y una unidad. Una vista previa de Markdown legible puede contener igualmente una sustitución del OCR o una celda mal colocada. Si el documento orienta una decisión financiera o técnica, conserva el PDF junto al Markdown y verifica el pasaje que piensas citar. La conversión facilita el trabajo con el texto; no certifica la fuente ni su transcripción.
Qué cambia
La conversión de PDF a Markdown sustituye la posición visual por una estructura de texto. Un título grande puede convertirse en un marcador de encabezado, los párrafos siguen siendo párrafos y una tabla compatible se transforma en filas separadas por barras. La geometría de la página, las líneas decorativas, las fuentes y el salto de línea original no forman parte del contrato de salida. Esto es útil cuando quieres editar un extracto o construir un índice de recuperación, pero no sirve cuando el objetivo es reproducir un folleto con exactitud. Conserva el PDF original por su maquetación autorizada. Cuando una maquetación no pueda representarse con una tabla de Markdown sencilla, comprueba si una breve explicación o una tabla revisada a mano es la representación posterior más clara.
Fuentes para RAG
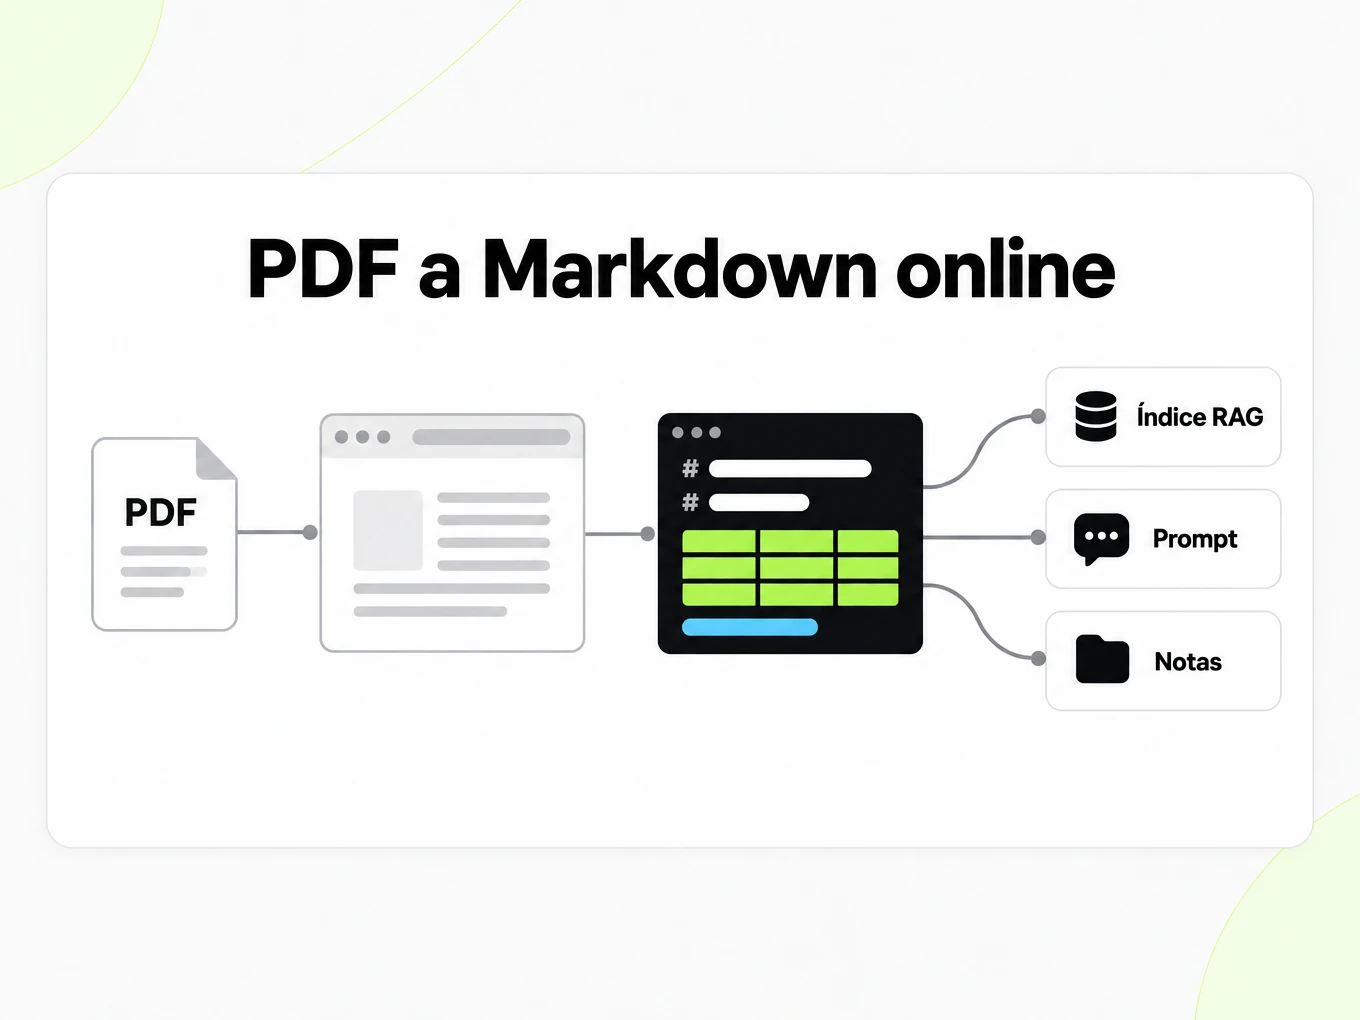
Usa el título del PDF y encabezados de sección significativos para conservar el contexto al dividir el Markdown en fragmentos. Un fragmento que solo lleva por encabezado Resultados puede resultar ambiguo cuando sale del documento; tu código de ingesta puede conservar el nombre del documento y el encabezado padre junto con ese fragmento. Mantén un encabezado de tabla junto con sus filas y evita cortar una lista a mitad de una condición. Guarda la referencia del PDF original por separado para que una respuesta recuperada pueda llevar al lector de vuelta a la fuente. LangChain y LlamaIndex pueden consumir texto de tu propio proceso de ingesta, pero elegir el divisor, el modelo de embeddings y la política de recuperación sigue siendo tarea de tu aplicación. Prueba la recuperación con preguntas cuya respuesta hayas verificado en el PDF.
Elegir el PDF
Dale preferencia al PDF exportado original cuando contenga texto legible. Una captura de pantalla de ese PDF añade otro paso de reconocimiento de imagen y puede perder caracteres pequeños antes de que empiece la conversión. En el caso de PDF escaneados, endereza las páginas giradas y usa una versión en la que la puntuación y los bordes de las tablas sigan siendo legibles con el zoom normal. Elimina la contraseña antes de subir un PDF cifrado. Si solo es relevante una parte de un informe largo, prepara las páginas de origen pertinentes y conserva su referencia original en tus notas. Repetir el mismo escaneo dañado difícilmente va a corregir el detalle que falta; mejora primero la fuente y luego compara el nuevo resultado de PDF a Markdown con el anterior.
Límites de los fragmentos
La calidad de la recuperación depende de que los límites de los fragmentos coincidan con el documento que leería una persona. Este conversor reordena las columnas y conserva los niveles de encabezado para que un divisor pueda emitir pasajes en lugar de fragmentos entrelazados de un artículo a dos columnas.
- Usa el Markdown como el artefacto que fragmentas e incrustas, no un volcado de texto aplanado.
- Las páginas estándar y las páginas con OCR se facturan a 1 crédito por página en los planes con sesión iniciada.
- Los archivos protegidos con contraseña deben desbloquearse antes de subirlos; los PDF cifrados se rechazan.
Más convertidores de Markdown
- Word → MarkdownDOCX con títulos y listas
- PPT → MarkdownTexto, notas y tablas de diapositivas
- Excel → MarkdownCada hoja como tabla
- Image → MarkdownOCR para escaneos y capturas
- HTML → MarkdownPega o sube HTML
- URL → MarkdownCualquier página web pública, limpia
- Markdown → HTMLHTML limpio y semántico
- Markdown → TextTexto plano sin marcado
- Markdown → PDFImprime a PDF en local
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
Preguntas sobre PDF a Markdown
¿Cómo funciona PDF a Markdown?
PDF a Markdown convierte la fuente compatible en Markdown legible para revisarlo y reutilizarlo. La prueba anónima acepta hasta 10 MB y 25 páginas por archivo, con 3 conversiones por IP y hora y 10 al día. Compara el resultado con la fuente antes de usarlo.
¿Cuál es el tamaño máximo de un PDF?
El conversor público acepta archivos PDF de hasta 10 MB. Lite admite archivos de hasta 100 MB; Pro y Max tienen límites más altos.
¿Admite PDF escaneados?
Sí. Los PDF basados en imagen se procesan hoy con OCR; los escaneos nítidos y de alta resolución dan los mejores resultados.
¿Se manejan los artículos de investigación con varias columnas?
Sí. PDF a Markdown intenta reconstruir el orden de lectura. Compara las transiciones entre columnas con la fuente, porque las maquetaciones complejas todavía pueden necesitar corrección.
¿Sobrevivirán las tablas financieras?
Las tablas de los PDF que llevan metadatos estructurales se convierten en tablas de Markdown. Las tablas de imagen aplanada necesitan OCR para recuperarse.
¿Puedo convertir PDF protegidos con contraseña?
No. Los PDF cifrados no se pueden analizar. Elimina la contraseña antes de subirlos.
¿El resultado sirve para fragmentarlo para RAG?
El Markdown conserva encabezados, listas y tablas cuando es posible, de modo que la fragmentación y la inserción de embeddings siguen siendo predecibles en comparación con copiar y pegar.
¿Puedo convertir PDF desde código?
Sí. Usa una clave de API para enviar el archivo directamente a /v1/convert/pdf y leer el Markdown en la respuesta. Consulta /developers.
Convierte PDF a Markdown a escala.
Pruébalo gratis: no hace falta registrarse.