
Convertidor
Convertidor de URL a Markdown
URL a Markdown es un conversor gratuito que convierte una página web de acceso público en Markdown limpio de su contenido principal —el artículo, la página de documentación o el hilo, sin la navegación del sitio—, listo para LLM, procesos de RAG y apuntes. No hace falta registrarse para probarlo; la prueba permite 3 conversiones por IP y hora y 10 al día.
Cómo se hace
Cómo convertir una página web a Markdown
Qué puedes pegar
- Cualquier página pública http(s): artículos, documentos, entradas de blog
- Las páginas tras un inicio de sesión o un muro de pago no se pueden obtener
- La página se descarga en nuestro servidor, sin ejecutar su JavaScript
- Pruébalo sin cuenta: hasta 10 MB y 25 páginas por archivo, 3 conversiones por hora y 10 al día
Qué revisar
- Descarga en el servidor — La página se descarga en el servidor, pidiendo primero Markdown y después HTML; el Markdown propio de un sitio solo se usa si pasa un control de calidad.
- Extracción del contenido principal — Varios extractores compiten entre sí —puntuación de legibilidad, detección de plantilla repetida, análisis de densidad de texto y el propio elemento main o article de la página— y gana el que conserva más estructura y prosa.
- Páginas renderizadas con JavaScript — Un shell de aplicación vacío se renderiza en un navegador headless, que espera a que la página se estabilice y luego entrega el DOM renderizado a la misma extracción.
- Páginas públicas, tamaño e identidad — Solo se admiten URL de acceso público: las páginas detrás de autenticación, muros de pago o pantallas de inicio de sesión no se pueden descargar.
A dónde va el Markdown
- Copia el Markdown directamente desde la vista previa
- Descarga el archivo .md y guárdalo en tu biblioteca al iniciar sesión
- Convierte muchas páginas a la vez con un array urls en POST /v1/convert/url
- Automatízalo con POST /v1/convert/url y tu clave de API
Por qué usarlo
Por qué usar este conversor de URL a Markdown
Una página web está escrita para un navegador. Markdown está escrito para personas y modelos. Este conversor encuentra la parte de la página que aporta el significado, conserva su estructura y deja atrás los elementos decorativos del sitio.
Contenido principal, no toda la página
Varios extractores leen la página y gana el resultado que conserva más del artículo, así que los menús, los avisos de cookies, los pies de página y los carruseles de artículos relacionados quedan fuera del Markdown.
Estructura que perdura
Los encabezados, las listas, las tablas y los bloques de código llegan como Markdown, y cada enlace o ruta de imagen relativa se reescribe como una URL completa que sigue funcionando fuera de la página.
Las páginas con JavaScript también se renderizan
Cuando el HTML inicial es un shell de aplicación vacío, la página se renderiza en un navegador headless y se convierte ese contenido renderizado.
Gratis para probar, sin iniciar sesión
Previsualiza y copia el Markdown sin cuenta, hasta 3 conversiones por hora y 10 al día. Inicia sesión para descargar el archivo .md.
Un descargador educado e identificado
Cada solicitud se identifica con un user agent documentado, y los propietarios de los sitios pueden bloquearlo: consulta la página del descargador en la documentación.
El mismo motor que la API
El conversor de esta página y POST /v1/convert/url ejecutan el mismo código, así que un script puede convertir hasta 20 URL por llamada.
El problema
Por qué una página activa es ruidosa para los modelos
Las páginas son ruidosas
Las páginas web activas entierran el contenido bajo navegación, anuncios, banners y scripts, a menudo con varias veces más texto que el propio artículo.
El marcado es desordenado
El HTML escrito a mano y el generado rara vez se corresponden limpiamente con una estructura legible.
La IA necesita el artículo
RAG y los agentes quieren el artículo, no los elementos de interfaz que lo rodean, y algunas páginas solo muestran el artículo después de que se ejecute JavaScript.
Qué se conserva
Qué descarga este conversor de URL
- Descarga en el servidor
- La página se descarga en el servidor, pidiendo primero Markdown y después HTML; el Markdown propio de un sitio solo se usa si pasa un control de calidad. No hace falta ningún plugin del navegador ni herramienta local.Source: RFC 9110: HTTP Semantics
- Extracción del contenido principal
- Varios extractores compiten entre sí —puntuación de legibilidad, detección de plantilla repetida, análisis de densidad de texto y el propio elemento main o article de la página— y gana el que conserva más estructura y prosa. Sitios conocidos, como generadores de documentación, GitHub y Wikipedia, usan reglas específicas del sitio.Source: HTML Living Standard: the main element
- Páginas renderizadas con JavaScript
- Un shell de aplicación vacío se renderiza en un navegador headless, que espera a que la página se estabilice y luego entrega el DOM renderizado a la misma extracción. El contenido que solo aparece tras un clic o un desplazamiento no se captura.Source: HTML Living Standard
- Páginas públicas, tamaño e identidad
- Solo se admiten URL de acceso público: las páginas detrás de autenticación, muros de pago o pantallas de inicio de sesión no se pueden descargar. Las páginas descargadas están sujetas a límites de tamaño de respuesta, y el user agent del descargador está documentado en /docs/fetcher.Source: product pipeline
Ejemplo: entrada del blog de markitdown.ai mediante descarga por URL· https://markitdown.ai/blog/why-pdfs-break-llms
# Why PDFs break LLMs — and what clean Markdown fixes _Published 2026-06-12 · The markitdown.ai team_ > A PDF that looks perfect to a human often falls apart the moment a model reads it. Here's what goes wrong, and why converting to clean Markdown first makes downstream AI far more reliable. A PDF renders perfectly for a human and falls apart the moment a model reads it. The page you see — columns, tables, headers, footnotes — is a *visual* arrangement, not a logical one. When you pull raw text out of it, that visual order rarely survives, and whatever you feed a language model is only as good as the text it actually receives. ## What actually goes wrong When teams pipe documents straight into an LLM or a retrieval index, a few failure modes show up again and again: - **Reading order breaks.** Multi-column layouts interleave. A two-column page becomes "line 1 left, line 1 right, line 2 left, line 2 right…", so a sentence a human reads top-to-bottom arrives at the model scrambled.- **Tables collapse.** Copy-paste turns a table into a loose run of numbers. The relationship between a header and its cell — the entire point of a table — is gone.- **Headings disappear.** The visual hierarchy (this is a section, this is a subsection) is encoded as font size and weight, not structure. Strip the styling and you get one undifferentiated wall of text. Casos de uso
Casos de uso de la conversión de sitios web a Markdown
Desde agentes de IA hasta migraciones de contenido, convertir una página web en Markdown es un paso pequeño del que dependen muchos flujos de trabajo.
Procesos de IA y LLM
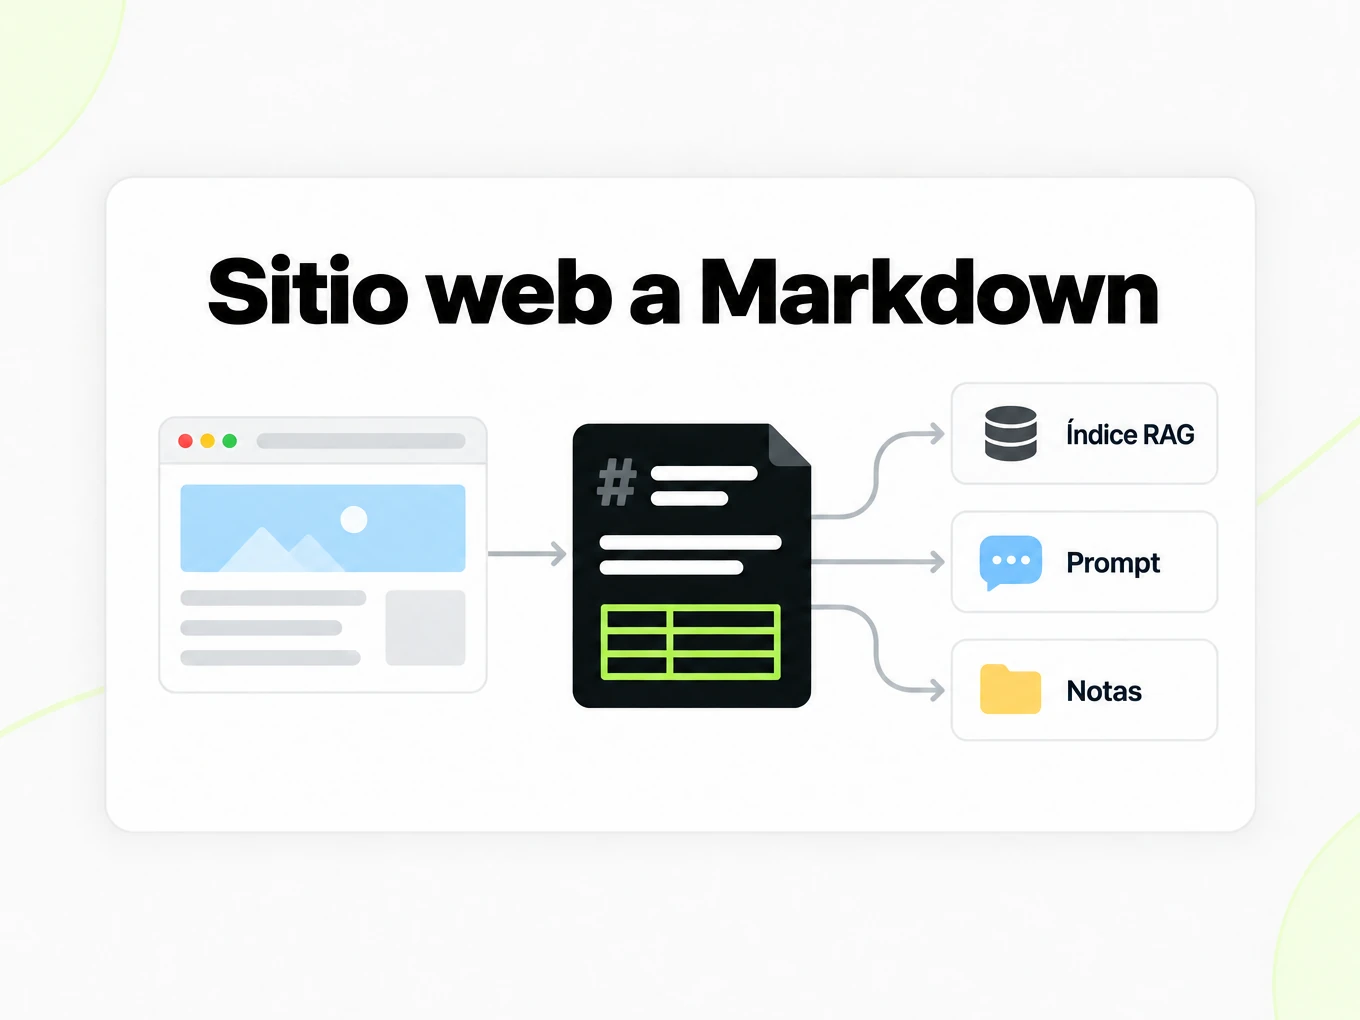
Alimenta índices de RAG, herramientas de agentes y prompts con artículos y documentación como texto limpio y con sus encabezados intactos, en lugar de HTML sin procesar.
Investigación y apuntes
Guarda una fuente como Markdown para citarla, anotarla o conservarla en Obsidian o un repositorio de notas, con los enlaces originales aún en su sitio.
Equipos de contenido
Traslada entradas y páginas de ayuda de un CMS a otro, o lleva material de referencia a un sitio de documentación basado en Markdown.
Desarrolladores
Llama a la API desde trabajos de ingesta y rastreadores que ya ejecutes y obtén el mismo Markdown que muestra el conversor del navegador.
API
API de URL a Markdown para desarrolladores
¿Conviertes páginas desde código? Envía una URL —o hasta 20 en un array urls— a POST /v1/convert/url con tu clave de API. Usa render con auto, force o skip para controlar el renderizado de JavaScript, y frontmatter en true para poner el título, el autor y la fecha de publicación de la página en el front matter YAML. El Markdown vuelve en la misma respuesta cuando la página termina dentro de la ventana de espera; si no, obtienes una conversión que sondear o un webhook cuando se resuelva. El acceso a la API está en los planes de pago.
Leer la guía de la APIcurl -X POST https://api.markitdown.ai/v1/convert/url \ -H "x-api-key: mdai_…" \ -H "content-type: application/json" \ -d '{"url":"https://markitdown.ai/blog/why-pdfs-break-llms","frontmatter":true}'Guía
Revisar el resultado
Revisa el resultado de URL a Markdown junto a la página pública que enviaste. El conversor conserva el contenido principal y deja fuera la navegación, los avisos de cookies y los enlaces de pie de página, pero una página sin un artículo claro —una página de producto, una landing page, una página de inicio con muchos adelantos— puede seguir perdiendo un panel lateral o conservar un bloque que no querrías citar. Comprueba los primeros y los últimos párrafos frente a la página antes de indexar el resultado. Las páginas que construyen su contenido con JavaScript se renderizan primero en un navegador; una página que carga su texto solo después de un clic, un desplazamiento o un inicio de sesión sigue sin poder capturarse. Cuando un sitio ya ofrece su propio Markdown a los clientes que lo piden, el conversor usa esa versión si pasa un control de calidad, y recurre a la página HTML cuando parece un menú de todo el sitio o un volcado de archivo. Conserva la URL de origen junto al Markdown para que un lector pueda volver a la página original.
Conservar el contexto de origen
Conserva la URL enviada y tu fecha de recuperación junto a un resultado de URL a Markdown en tu propio flujo de trabajo. Una página pública puede cambiar después de que la conviertas, así que un visitante posterior puede ver un pasaje revisado. Con el front matter activado, el resultado empieza con la URL de origen, la URL canónica, el título y, cuando la página los declara, el autor, la fecha de publicación, la descripción, el nombre del sitio, el idioma y la imagen principal, leídos de las etiquetas meta, los datos estructurados y la firma de la página. Esos campos repiten lo que la página dice de sí misma; compruébalos en la fuente si tu investigación depende de ellos. El campo de metadatos de la API es distinto: solo lleva el contexto que tú aportes. Antes de citar una tabla o un párrafo, compáralo con la página y conserva suficiente contexto alrededor para no cambiar su significado. Markdown hace que el contenido web sea más fácil de reutilizar; no determina si la página es exacta ni si tienes permiso para republicarla.
HTML guardado frente a URL
Elige el conversor de HTML cuando ya tengas la instantánea exacta de la página que necesitas procesar. Elige URL a Markdown cuando una dirección de acceso público sea la entrada de la conversión actual. Son flujos de trabajo relacionados con controles de origen distintos: un archivo guardado fija la entrada que envías y se convierte por completo, mientras que una URL depende de lo que el sitio web devuelva en el momento de la solicitud y se reduce a su contenido principal. Ninguna de las dos rutas elude las restricciones de acceso. Si un sitio deniega el descargador o exige iniciar sesión, usa material que estés autorizado a obtener mediante un flujo de trabajo adecuado. No reintentes repetidamente una URL inaccesible como si otro intento de conversión concediera acceso.
Investigación con LLM
Los investigadores pegan una fuente, no un archivo. Este conversor descarga la URL que envías, conserva el cuerpo del artículo o de la documentación y devuelve Markdown que puedes citar, fragmentar o dejar caer en un gestor de notas, con enlaces que siguen funcionando. Renderiza páginas con JavaScript cuando el servidor envía un shell vacío, y no inicia sesión tras muros de pago.
- Solo se admiten URL de acceso público.
- El descargador se identifica; los operadores pueden denegar el user agent: consulta /docs/fetcher.
- Los archivos HTML guardados van en /html-to-markdown, no aquí.
Más convertidores de Markdown
- PDF → MarkdownTexto, tablas y escaneos
- Word → MarkdownDOCX con títulos y listas
- PPT → MarkdownTexto, notas y tablas de diapositivas
- Excel → MarkdownCada hoja como tabla
- EPUB → MarkdownCapítulos de ebooks como encabezados
- Image → MarkdownOCR para escaneos y capturas
- HTML → MarkdownPega o sube HTML
- Markdown → HTMLHTML limpio y semántico
- Markdown → TextTexto plano sin marcado
- Markdown → PDFImprime a PDF en local
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
Preguntas sobre URL a Markdown
¿Cómo funciona URL a Markdown?
URL a Markdown descarga la página pública que pegas, conserva su contenido principal y lo convierte en Markdown con enlaces de URL completa: no hay archivo que subir. Las páginas que necesitan JavaScript se renderizan primero en un navegador.
¿Elimina los anuncios y la navegación de una página activa?
Sí, en páginas con un área de contenido principal clara. URL a Markdown conserva el artículo, el cuerpo de la documentación o el hilo, y descarta menús, avisos de cookies y pies de página; una landing page o una página de producto sin un bloque principal claro puede seguir conservando o perdiendo un panel lateral, así que revisa el resultado.
¿Hay límites de tamaño para una página descargada?
El conversor público funciona con páginas web públicas. Las páginas descargadas están sujetas a límites de tamaño de respuesta y pueden rechazarse si son demasiado grandes.
¿Funciona en páginas detrás de un inicio de sesión?
No. Solo se admiten URL de acceso público. Las páginas detrás de autenticación, muros de pago o pantallas de inicio de sesión no se pueden descargar.
¿Y las páginas renderizadas con JavaScript?
Las páginas renderizadas con JavaScript se renderizan en un navegador headless cuando el HTML inicial es un shell vacío, y después se convierten como cualquier otra página. En la API, render con force siempre renderiza y skip nunca lo hace. El texto que solo aparece tras un clic, un desplazamiento o un inicio de sesión no se captura.
¿Puedo convertir varias URL a la vez?
Envía un array urls con hasta 20 URL públicas a POST /v1/convert/url. Sigue el resultado de cada archivo y gestiona las respuestas asíncronas. Consulta /developers.
¿URL a Markdown es gratis?
Sí. Previsualizar y copiar el Markdown es gratis sin cuenta, hasta 3 conversiones por hora y 10 al día; descargar el archivo .md requiere iniciar sesión. Solo páginas web públicas (sin URL internas ni privadas).
¿Qué contenido conserva el conversor?
El conversor conserva los encabezados, párrafos, listas, enlaces, imágenes, tablas y bloques de código del contenido principal, con los enlaces relativos reescritos como URL completas. Los scripts, estilos, la navegación y los pies de página se descartan; con el front matter activado, el título, el autor y la fecha de publicación de la página van al principio.
¿Hay una API de conversión por URL?
Sí. Convierte páginas web por URL mediante programación a través de la API REST. Consulta /developers. Los archivos HTML guardados usan /html-to-markdown.
Convierte URL a Markdown a escala.
Pruébalo gratis: no hace falta registrarse.