
문서와 웹 페이지를 위한 마크다운 변환.
문서와 공개 웹 페이지를 위한 마크다운 변환 도구입니다. PDF, Word, PowerPoint, Excel, 이미지, HTML이 검토하고 재사용하고 AI 워크플로에 바로 넣을 수 있는 텍스트로 변환됩니다.
익명 체험 · 10MB · 시간당 3회 변환 · 하루 10회
다음에서 Markdown으로 변환
- DOCX
- PPTX
- XLSX
- PNG / JPG
- HTML
- URL
작동 방식
마크다운 변환: 작동 방식
markitdown.ai는 PDF, Office 파일, 이미지, 웹 페이지를 ChatGPT, Claude, RAG 파이프라인, 에이전트에 바로 쓸 수 있는 깔끔한 Markdown으로 바꿔 주는 마크다운 변환 도구입니다. 익명 체험으로 시작하거나, 개발자용 API 액세스가 포함된 유료 계정을 사용할 수 있습니다.
What happens
파일을 업로드하거나 URL을 붙여 넣으세요. 변환은 브라우저에서 복사해 붙여 넣는 방식이 아니라 우리 서버에서 실행되므로, 같은 파일은 어디서 올리든 같은 Markdown을 만듭니다. 각 페이지는 담긴 내용에 따라 처리되고, 제목, 목록, 표는 실제 Markdown 구조로 나옵니다.
What you get
- 텍스트 레이어가 있는 페이지는 그대로 읽고, 스캔본과 이미지는 자동으로 OCR을 거칩니다
- URL 다운로드는 우리 서버에서 실행되며 사설·내부 주소는 차단됩니다
- 공개 변환기: 로그인 없이 최대 10MB, 25페이지
- 로그인 요금제는 두 한도를 모두 높여 Pro에서 최대 200MB, 200페이지까지 올라갑니다
What happens
뷰어는 원본 문서와 생성된 Markdown을 나란히 배치하므로, 결과를 쓰기 전에 제목, 표, 읽기 순서를 확인할 수 있습니다. 렌더링된 미리보기와 가공되지 않은 Markdown 사이를 전환하며 모델이나 파이프라인이 정확히 무엇을 받게 되는지 볼 수 있습니다.
What you get
- 원본과 Markdown은 뷰어에서 나란히 표시됩니다
- Markdown 패널을 렌더링된 미리보기와 원본 코드 사이에서 전환할 수 있습니다
- 계정 없이 결과를 무료로 복사할 수 있습니다
- 로그인하면 .md 파일로 내려받을 수 있습니다
What happens
한 파일에 통했던 설정이 파일 묶음이나 파이프라인 호출에도 그대로 적용되고, 모든 결과는 라이브러리에 남습니다. Batch는 파일마다 상태와 재시도를 따로 추적하고, API는 같은 Markdown을 곧바로 코드로 전달합니다.
What you get
- 웹 앱, Batch(ZIP 또는 URL 목록), API가 같은 파싱 엔진을 씁니다
- POST /v1/convert/{name}는 60초 안에 한 번의 호출로 Markdown을 반환하거나, 폴링하거나 웹훅으로 받을 변환 작업을 반환합니다
- 라이브러리는 요금제의 기록 보관 기간 동안 모든 실행을 보관합니다: Lite 30일, Pro 60일, Max 90일
크레딧
Markdown 정확도, 페이지당 가격.
텍스트 레이어가 있는 청구서와 스캔한 잔액은 페이지당 비용이 같습니다. 직접 추출과 OCR 중 무엇을 쓸지는 파이프라인이 알아서 고릅니다. 그림과 이미지를 위한 AI 부가 기능은 선택 사항이며 별도로 과금됩니다.
- 페이지당, 텍스트든 스캔이든
- 1 크레딧
- 페이지당, 텍스트든 스캔이든
텍스트 레이어가 있는 PDF, Office 파일, HTML
스캔한 페이지, 사진, 스크린샷을 위한 OCR
PDF의 차트와 그림을 설명으로 변환 · 유료 요금제
OCR을 넘어 이미지 내용까지 설명 · 유료 요금제
Markdown API
RAG 파이프라인을 위한 Markdown API.
- 웹 앱과 동일한 파싱 파이프라인
- 완료 시 웹훅으로 수천 개 파일을 일괄 처리
- 범위가 지정된 API 키와 전체 활동 로그
- 한 번의 호출로 Markdown을 받거나, 파일이 60초를 넘길 때 폴링할 변환 작업을 받습니다
curl -X POST https://api.markitdown.ai/v1/convert/word \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F file=@vendor-security-review-q3-2026.docx # If HTTP 202, GET the Location URL with the same API key.# Verified local parser output for vendor-security-review-q3-2026.docx:# ## Review Findings# # Risk ratings follow the standard High / Medium / Low scale defined in the vendor risk management policy.# # | Vendor | Risk Rating | Finding | Owner |# | --- | --- | --- | --- |# | CloudScan OCR | Medium | No documented data retention limit on uploaded scans | Security |# | PayBridge | Low | SOC 2 Type II renewed; no open items | Finance |# | LingoTrans API | High | Sub-processor list not disclosed on request | Legal |# | ArchiveNow Storage | Medium | Encryption at rest confirmed; key rotation overdue | Security |문제
문서는 AI에 바로 쓸 수 없습니다
대부분의 문서는 사람과 프린터를 위해 만들어졌지 언어 모델을 위해 만들어지지 않았습니다. 파일을 임베딩하거나 검색하거나 추론하기 전에 예측 가능한 텍스트로 바꿔야 합니다. 이는 생각보다 어렵고, 바로 여기서 순진한 추출이 무너집니다. 문서를 마크다운으로 변환하는 일이 까다로운 이유도 여기 있습니다.
읽기 순서가 깨집니다
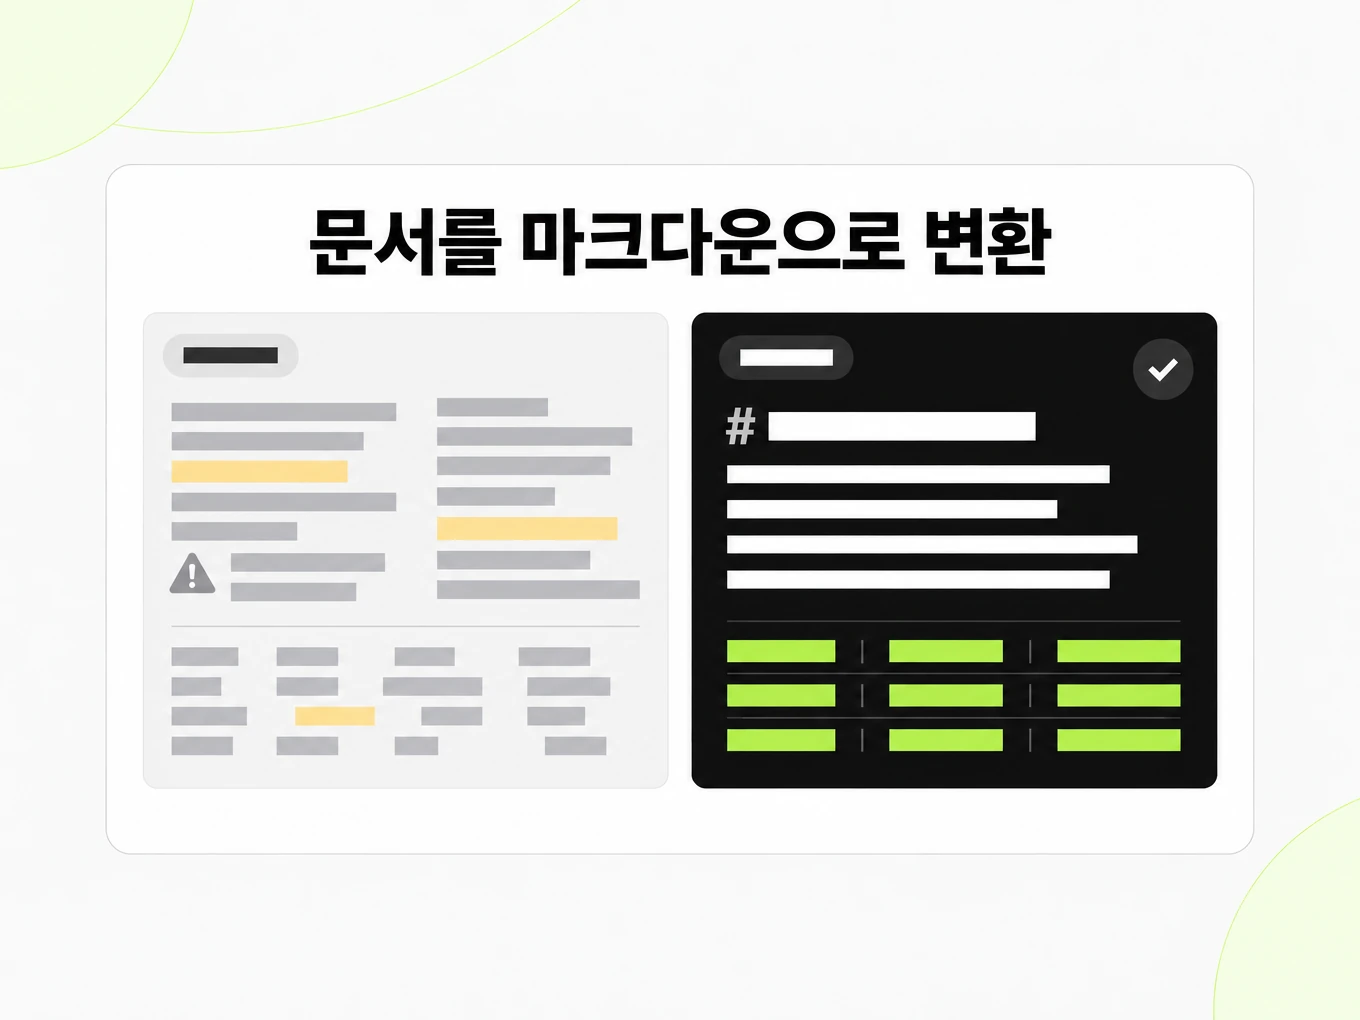
여러 단으로 된 PDF, 제목, 각주가 뒤엉켜서 LLM이 읽는 텍스트가 사람이 보는 문서와 더 이상 일치하지 않습니다.
표와 제목이 납작해집니다
복사해 붙여 넣으면 표가 숫자 나열로 뭉개지고 문서에 구조를 주는 제목 위계가 사라집니다.
스캔본에는 OCR이 필요합니다
이미지 기반 페이지와 스캔한 계약서는 광학 문자 인식을 거치기 전까지 텍스트 레이어가 전혀 없습니다.
가공되지 않은 텍스트에는 노이즈가 있습니다
임기응변식 추출은 페이지 번호, 잘린 하이픈, 흩어진 문자를 남겨 프롬프트와 검색 결과를 오염시킵니다.
RAG 파이프라인과 에이전트는 추출된 문자만이 아니라 일관된 구조를 필요로 합니다. 예측 가능한 Markdown이라야 청킹, 임베딩, 검색이 수천 개 문서에서 똑같이 동작하고, 가장 지저분한 문서에서 조용히 실패하지 않습니다. 까다로운 파일을 처리하는 파서가 깔끔한 파일의 신뢰성을 지켜 줍니다.
입력 형식
모든 문서를 Markdown으로 변환
각 입력 형식에는 한도, 형식 관련 주의 사항, 출력 샘플이 담긴 자체 변환 페이지가 있습니다. 모두 같은 파싱 엔진을 공유하니, 파일에 맞는 페이지를 고르세요:
- PDF를 Markdown으로 — 보고서, 논문, 매뉴얼, 계약서. 텍스트가 있는 PDF는 바로 파싱하고 여러 단 읽기 순서를 재구성하며, 스캔한 PDF는 페이지마다 OCR을 거칩니다.
- Word를 Markdown으로 — 제목, 목록, 표, 댓글이 보존된 .docx 및 레거시 .doc 파일. 정책 문서나 사양서가 한 덩어리 텍스트가 아니라 개요처럼 읽힙니다.
- PPT를 Markdown으로 — .pptx와 .ppt 프레젠테이션을 슬라이드 단위로 변환하고, 슬라이드 제목을 제목으로, 글머리 기호와 표를 그대로 살려 40장짜리 발표 자료도 검색할 수 있게 합니다.
- Excel을 Markdown으로 — .xlsx와 .xls 통합 문서. 각 시트가 시트 이름 아래의 Markdown 표로 변환됩니다.
- 이미지를 Markdown으로 — OCR을 통한 PNG, JPG 스크린샷과 스캔본. AI 이미지 이해는 로그인 후 선택할 수 있는 별도 옵션입니다.
- HTML을 Markdown으로 — 저장한 페이지, 내보낸 파일, 조각. 스크립트와 스타일은 제거하고 본문 구조, 링크, 표는 보존합니다.
- URL을 Markdown으로 — 공개 웹 주소를 붙여 넣으면 페이지를 Markdown으로 받습니다. 서버에서 크기 한도와 타임아웃을 두고 내려받으므로 느린 사이트가 요청을 막지 않습니다.
출력 형식
Markdown에서 모든 형식으로
Markdown은 교환 형식이라 변환은 반대 방향으로도 됩니다. 아래 Markdown 편집기는 브라우저에서 입력하는 동안 실시간으로 렌더링되며 텍스트를 절대 업로드하지 않습니다:
- Markdown을 HTML로 — GitHub 스타일 표, 할 일 목록, 코드 강조를 갖춘 깔끔한 시맨틱 HTML. CMS나 이메일에 바로 붙여 넣을 수 있습니다.
- Markdown을 텍스트로 — 제목, 목록, 표를 읽기 좋게 평탄화한 일반 텍스트. 채팅 창, 티켓, 입력 폼에 알맞습니다.
- Markdown을 PDF로 — 로컬 인쇄 미리보기. 브라우저의 인쇄 / PDF로 저장을 사용하고 저장된 페이지를 확인하세요.
구조화된 JSON 추출과 오디오·비디오 전사는 Markdown 위에 계획된 계층입니다. 이미 제공되는 기능이 아니라 로드맵으로 표시합니다.
사용 사례
모든 팀을 위해 만들었습니다
마크다운 변환 도구는 첫 결과를 확인할 수 있는 익명 체험을 제공합니다. 팀이 계속 쓰는 이유는 첫 파일 이후에 필요한 모든 것, 곧 기록, 배치, 더 큰 문서, 그리고 변환을 이미 쓰는 시스템에 통합하는 API 때문입니다. 같은 Markdown이 사람이 읽든 검색 색인이 읽든 모델이 읽든 똑같이 동작합니다.
RAG와 AI 파이프라인
청킹, 임베딩, 에이전트 처리를 하기 전에 원본 문서를 깔끔한 Markdown으로 바꾸세요. 예측 가능한 구조라야 분할기가 텍스트 벽이 아니라 실제 제목과 표를 보고, 검색이 관련성을 유지하며 프롬프트에 레이아웃 노이즈가 섞이지 않습니다.
연구와 보고서
논문, 백서, 프레젠테이션을 편집하고 검색할 수 있는 Markdown으로 변환하세요. 연구자와 분석가는 표를 다시 입력하거나 빽빽한 PDF의 읽기 순서를 잃지 않고 인용하고, 주석을 달고, 요약하고, 결과를 재사용할 수 있습니다.
운영 문서
정책, 계약서, 청구서, 사내 문서를 손으로 복사해 붙여 넣지 않고 처리하세요. 저장된 Markdown 기록이 있으면 반복되는 문서 작업을 팀의 일상에서 더 쉽게 검토하고 비교하고 재사용할 수 있습니다.
개발자 자동화
API로 수집 작업, 사내 도구, 문서 흐름 안에서 파일을 변환하세요. 요청을 보내고 Markdown을 받아 신뢰할 수 있는 출력으로 CMS, 지식 베이스, 지원 봇, 에이전트 파이프라인에 넘기면 됩니다.
지식 베이스와 지원
제품 매뉴얼, 릴리스 노트, 사내 위키를 지원 봇이나 사내 어시스턴트가 검색할 수 있는 하나의 Markdown 코퍼스로 모으세요. 제목과 표가 살아남으므로 답변이 페이지 크기의 덩어리가 아니라 올바른 섹션을 가리킵니다.
에이전트와 도구
에이전트에게 지원 형식과 공개 URL을 다루는 마크다운 변환 도구를 쥐여 주고, 결과를 소비하기 전에 완료 여부를 확인하세요. 이 사이트도 같은 방식으로 읽힙니다. 모든 공개 페이지는 Accept: text/markdown에 Markdown 쌍둥이로 응답하고 llms.txt가 이를 모두 나열합니다.
출력 품질
텍스트가 아니라 구조
유용한 Markdown 변환 사이트는 PDF의 낱개 문자 이상을 보존합니다. 여기서 목표로 하는 것은 뒤에 오는 도구가 의존하는 구조를 지키는 Markdown이며, 브라우저의 불안정한 복사·붙여 넣기가 아니라 서버의 파싱 파이프라인이 만들어 냅니다.
- 원본에 있는 제목, 목록, 표, 링크, 읽기 순서를 보존합니다.
- PDF, Word, PowerPoint, Excel, 이미지, HTML, URL을 하나의 파이프라인으로 처리합니다.
- 스캔한 PDF와 이미지는 지금도 OCR로 처리하며, 인식 품질은 원본 이미지에 달려 있습니다.
- 긴 문서를 비동기로 실행하므로 큰 보고서와 발표 자료가 시간 초과 없이 끝납니다.
일반 페이지와 OCR 페이지는 모두 페이지당 1크레딧입니다. 유료 요금제 계정은 이미지 AI 이해를 이미지당 5크레딧에 사용할 수 있습니다. 출력은 GitHub 스타일 표를 포함한 CommonMark를 따르므로 어떤 Markdown 뷰어에서도 렌더링되고 어떤 Markdown 라이브러리로도 파싱됩니다. 모든 변환은 검토하고 저장하고 재사용할 수 있는 결과물을 만들어야 합니다. 그게 기준입니다.
세 가지 시작점
브라우저, API, 또는 에이전트
웹 앱의 마크다운 변환 도구는 한 번짜리 수동 변환과 반복 변환을 모두 담당합니다. Batch는 파일 묶음을 담당합니다. API는 에이전트가 도구로 호출하는 경우를 포함해 자동으로 일어나야 하는 모든 것을 담당합니다. 셋은 하나의 계정, 하나의 크레딧 잔액, 하나의 파싱 엔진을 공유합니다. 대부분의 팀은 브라우저에서 시작해 변환이 제품이나 사내 워크플로의 일부가 되면 API로 옮겨 갑니다.
| Aspect | 브라우저 | Batch | API |
|---|---|---|---|
| 적합한 용도 | 한 번에 파일 하나 | 한 번의 실행으로 여러 파일 | 파이프라인, 도구, 에이전트 |
| 로그인 | 첫 파일에는 필요 없음 | 유료 요금제 | 유료 요금제, API 키 |
| 입력 | 업로드 또는 URL | 업로드 목록 또는 파일 ID | 업로드, URL, 인라인 텍스트 또는 파일 ID |
| 출력 | 미리보기, 복사, .md 다운로드 | 파일별 상태가 있는 라이브러리 | Markdown이 담긴 JSON, 페이지별 출력, 웹훅 |
| 한도 | 로그인 없이 10MB, 25페이지 | 요금제의 동시 실행 수 | 요금제에 따라 분당 20~60회 요청 |
| 대기 | 페이지에서 몇 초 | 백그라운드 | 동기 대기 최대 60초, 이후 폴링할 변환 작업 |
웹 앱
- 파일을 업로드하거나 URL을 붙여 넣고 렌더링된 Markdown을 미리 봅니다
- 변환 기록을 저장하고 .md 결과를 내려받습니다
- 파일별 상태와 함께 반복 작업을 일괄 변환합니다
- 요금제별 크레딧과 사용량을 관리합니다
개발자 API
- POST /v1/convert/{name}는 한 번의 호출로 Markdown을, 또는 파일이 60초를 넘길 때 변환 작업을 반환합니다
- 변환을 폴링하거나 완료 시 웹훅을 받습니다
- Accept: text/markdown을 보내면 모든 공개 페이지를 Markdown으로 읽습니다
- 기계가 읽을 수 있는 명세는 /v1/openapi.json에 있습니다
FAQ
팀들이 자주 묻는 질문
마크다운 변환: 무엇을 하나요?
문서를 Markdown으로 바꾸는 도구는 PDF, Word, PowerPoint, Excel, 이미지 또는 웹 페이지를 읽고 그 내용을 Markdown으로 다시 쓰는 도구입니다. 제목은 # 줄이 되고, 표는 파이프 표가 되고, 목록은 목록으로 남습니다. 핵심은 언어 모델, RAG 파이프라인, 에이전트가 레이아웃 노이즈 없이 청킹하고 임베딩하고 인용할 수 있는 예측 가능한 일반 텍스트를 얻는 것입니다.
무료 변환기는 정말 무료인가요?
네. 공개 변환기 페이지는 계정도 카드도 필요하지 않습니다. 최대 10MB, 25페이지까지의 파일이 브라우저에서 변환되고 Markdown을 미리 보고 복사할 수 있습니다. Lite, Pro, Max 구독은 월 $20부터 시작하며 저장 라이브러리, 배치, API를 더해 줍니다.
스캔한 PDF와 이미지는 어떻게 처리하나요?
이미지만 있는 페이지는 텍스트 레이어가 없으므로 파이프라인이 자동으로 OCR을 실행해 디지털 텍스트와 똑같이 Markdown을 반환합니다. 일반 페이지와 OCR 페이지는 모두 페이지당 1크레딧입니다. 인식 품질은 원본 이미지에 달려 있습니다. 300dpi 스캔본이 휴대폰으로 찍은 페이지 사진보다 훨씬 잘 읽힙니다.
코드나 에이전트에서 실행할 수 있나요?
네. POST /v1/convert/{name}는 API 키와 함께 업로드, URL 또는 인라인 텍스트를 받아 파일이 60초 안에 끝나면 한 번의 호출로 Markdown을 반환하고, 그렇지 않으면 폴링하거나 웹훅으로 받을 변환 작업을 반환합니다. 에이전트는 모든 공개 페이지에 Accept: text/markdown을 요청할 수 있고, 기계가 읽을 수 있는 명세는 /v1/openapi.json에 있습니다.
변환 후 내 파일은 어떻게 되나요?
변환을 삭제하면 라이브러리에서 즉시 사라지고 저장된 파일은 한 시간 안에 삭제됩니다. 다른 변환과 공유되는 원본 파일은 그 변환도 삭제될 때까지 보존됩니다. 계정을 삭제하면 저장된 모든 원본과 결과 파일이 삭제됩니다. 유료 요금제는 요금제에 따라 30일, 60일, 90일 동안 기록을 보관합니다.