
변환기
PDF 마크다운 변환
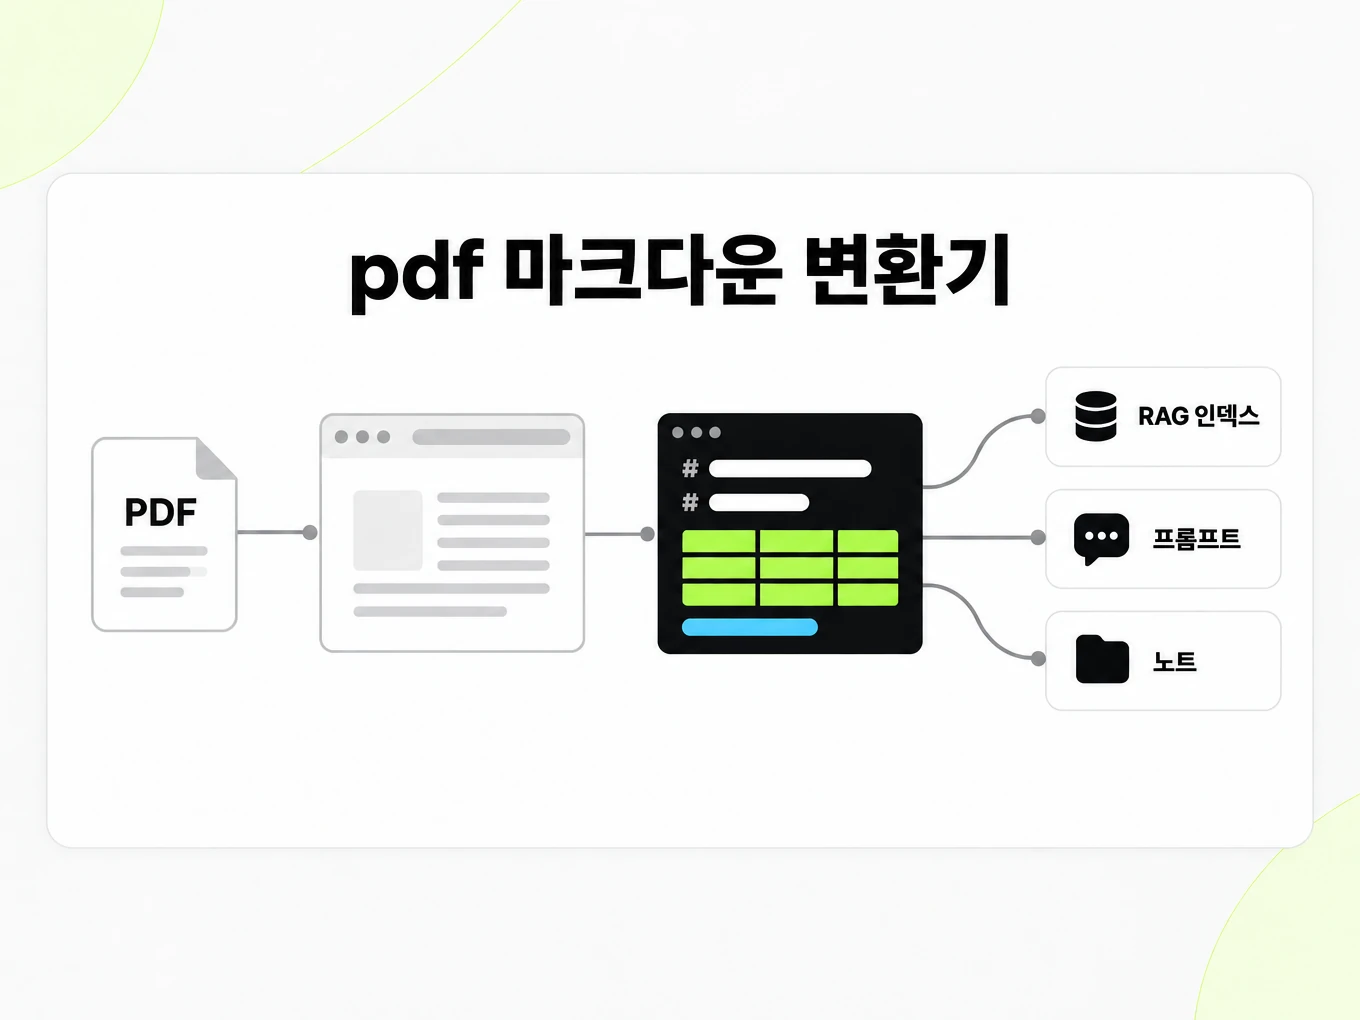
PDF 마크다운 변환은 여러 단의 읽기 순서를 재구성해 RAG를 위한 구조화된 Markdown으로 바꾸는 변환기입니다. 공개 체험은 최대 10MB 파일을 허용합니다.
사용 방법
PDF를 Markdown으로 변환하는 방법
업로드할 수 있는 것
- 파일 형식: .pdf
- 계정 없이 체험하세요: 파일당 최대 10MB, 25페이지, 시간당 3회, 하루 10회
- Lite는 최대 100MB, Pro는 최대 200MB 파일을 지원합니다
- Max는 파일 크기 한도가 없습니다. 변환은 크레딧으로 제한됩니다
확인할 것
- 읽기 순서 재구성 — PDF 변환은 논리적인 읽기 순서를 재구성하려 시도합니다.
- 표와 제목 — PDF가 구조 메타데이터를 제공하면 제목 수준과 표 데이터가 보존되며, 일반 텍스트 PDF는 일반 텍스트 출력을 만듭니다.
- 스캔 및 이미지 전용 PDF — 텍스트 레이어가 없는 PDF(스캔 페이지, 삽입된 이미지)는 지금도 OCR로 처리하며 정확도는 스캔 품질에 달려 있습니다.
- 암호로 보호된 파일 — 암호화된 PDF는 파싱할 수 없으므로 업로드 전에 비밀번호를 제거하세요.
Markdown이 가는 곳
- 미리보기에서 Markdown을 바로 복사하세요
- .md 파일을 내려받고 로그인 시 라이브러리에 저장하세요
- 일괄 변환으로 폴더 전체나 ZIP 파일을 변환하세요
- POST /v1/convert/pdf와 API 키로 자동화하세요
사용하는 이유
PDF 마크다운 변환을(를) 쓰는 이유
보고서를 읽을 수 있는 텍스트로
보고서의 문단과 지원되는 구조를 검토하고 편집하고 원본 PDF 옆에 보관할 수 있는 Markdown으로 변환하세요.
스캔 페이지를 위한 OCR
이미지만 있는 페이지는 OCR로 인식할 수 있습니다. 작은 텍스트, 문장 부호, 숫자 표를 원본 스캔과 비교하세요.
제목 맥락
노트와 검색 흐름을 위해 알아볼 수 있는 섹션을 보존하고, 시각적 스타일의 제목이 올바르게 해석됐는지 함께 확인하세요.
검토할 표
지원되는 표는 텍스트 표로 변환됩니다. 내보낸 값을 근거로 다루기 전에 복잡하거나 병합된 셀을 검토하세요.
재사용 전 미리보기
ChatGPT, Claude, 문서 저장소에 구절을 복사하기 전에 Markdown 코드를 렌더링된 보기와 비교하세요.
반복 가능한 API 경로
브라우저에서 대표 결과를 검토한 뒤 수집 스크립트에서 PDF 변환 경로를 사용하세요.
문제
PDF의 여러 단이 언어 모델을 깨뜨리는 이유
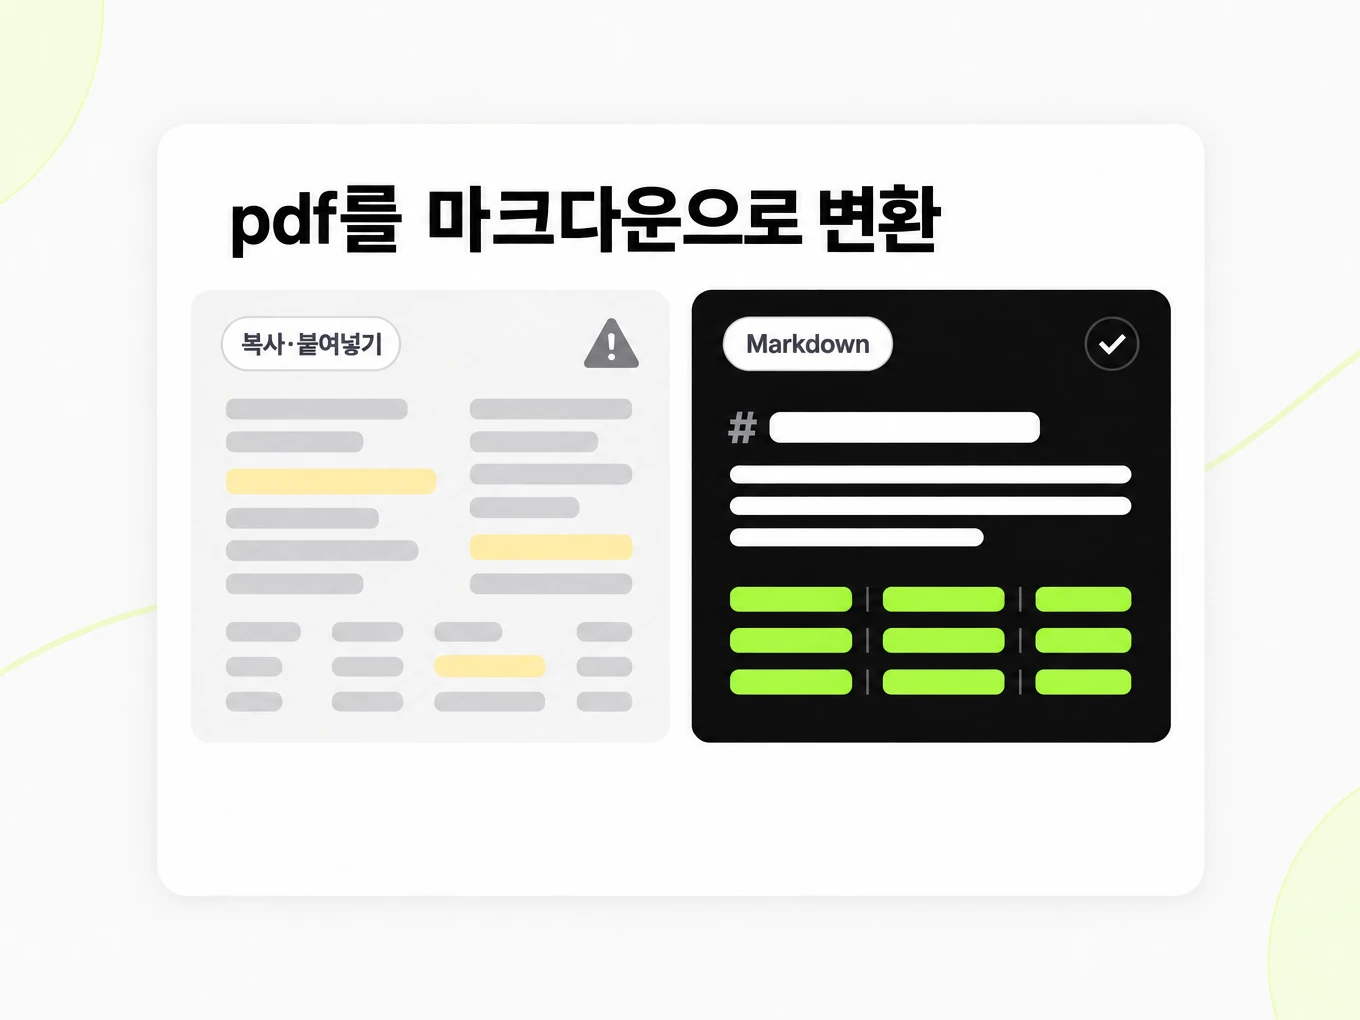
단이 뒤섞입니다
2단 보고서를 위에서 아래로 읽으면 왼쪽 흐름과 오른쪽 흐름이 섞여, 모델이 페이지에 존재한 적 없는 문장을 보게 됩니다.
표가 격자를 잃습니다
PDF에서 복사해 붙여 넣으면 결과 표가 머리글 행 없는 숫자 나열이 되어 이후 파서에 쓸모없어집니다.
스캔본에는 텍스트 레이어가 없습니다
이미지만 있는 페이지에는 글리프가 아니라 픽셀만 있으므로 스캔한 PDF는 지금도 OCR로 처리됩니다.
보존되는 것
이 PDF 변환기가 보존하는 것
- 읽기 순서 재구성
- PDF 변환은 논리적인 읽기 순서를 재구성하려 시도합니다. 특히 복잡한 보고서와 기사에서 단 사이 전환을 원본과 비교하세요.Source: ISO 32000-2 (PDF 2.0)
- 표와 제목
- PDF가 구조 메타데이터를 제공하면 제목 수준과 표 데이터가 보존되며, 일반 텍스트 PDF는 일반 텍스트 출력을 만듭니다.Source: CommonMark Spec
- 스캔 및 이미지 전용 PDF
- 텍스트 레이어가 없는 PDF(스캔 페이지, 삽입된 이미지)는 지금도 OCR로 처리하며 정확도는 스캔 품질에 달려 있습니다.Source: product pipeline
- 암호로 보호된 파일
- 암호화된 PDF는 파싱할 수 없으므로 업로드 전에 비밀번호를 제거하세요.Source: ISO 32000-2 (PDF 2.0)
예시: NIST Cybersecurity Framework 2.0, 15페이지· https://nvlpubs.nist.gov/nistpubs/CSWP/NIST.CSWP.29.pdf
## Appendix A. CSF Core This appendix describes the Functions, Categories, and Subcategories of the CSF Core. Table 1 lists the CSF 2.0 Core Function and Category names and unique alphabetic identifiers. Each Function name in the table is linked to its portion of the appendix. The order of Functions, Categories, and Subcategories of the Core is not alphabetical; it is intended to resonate most with those charged with operationalizing risk management within an organization. The numbering of the Subcategories is intentionally not sequential; gaps in numbering indicate CSF 1.1 Subcategories that were relocated in CSF 2.0. **Table 1. CSF 2.0 Core Function and Category names and identifiers** | Function | Category | Category Identifier || --- | --- | --- || **Govern (GV)** | Organizational Context | GV.OC || | Risk Management Strategy | GV.RM || | Roles, Responsibilities, and Authorities | GV.RR || | Policy | GV.PO || | Oversight | GV.OV || | Cybersecurity Supply Chain Risk Management | GV.SC || **Identify (ID)** | Asset Management | ID.AM || | Risk Assessment | ID.RA || | Improvement | ID.IM || **Protect (PR)** | Identity Management, Authentication, and Access Control | PR.AA || | Awareness and Training | PR.AT || | Data Security | PR.DS || | Platform Security | PR.PS || | Technology Infrastructure Resilience | PR.IR || **Detect (DE)** | Continuous Monitoring | DE.CM || | Adverse Event Analysis | DE.AE | 사용 사례
실제 워크플로에서의 PDF 마크다운 변환
연구 노트
논문을 편집 가능한 노트로 추출하고 인용 구절을 검증하며 나중에 다시 보도록 PDF 참조를 보관하세요.
보고서 수집
표 머리글, 섹션 맥락, 원본 문서 링크를 보존하며 보고서를 청킹할 수 있게 준비하세요.
규정 라이브러리
검토한 규정을 검색 가능한 텍스트로 변환하고 게시된 PDF를 승인 버전으로 보관하세요.
문서 평가
스캔본, 단, 까다로운 표를 포함한 대표 PDF를 비교한 뒤 모음을 자동화하세요.
API
PDF 마크다운 변환 API
x-api-key 헤더와 지원되는 원본 파일로 POST /v1/convert/pdf을 호출하세요. 완료된 요청은 응답 자체에서 결과를 반환할 수 있고, HTTP 202는 변환이 아직 진행 중임을 뜻합니다. 응답의 Location 헤더를 읽고 출력 파일에 접근하기 전에 그 주소를 폴링하세요. 멀티파트 요청은 최대 100개 파일을 받으며, 구독 한도와 요청 전체 한도도 적용됩니다. API 키는 서버 환경에 저장하세요. API 액세스에는 Lite, Pro 또는 Max 구독이 필요합니다.
API 가이드 읽기curl -i "https://api.markitdown.ai/v1/convert/pdf" \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F "file=@source.pdf"# If HTTP 202, GET the Location URL with the same API key.가이드
결과 검토
PDF를 Markdown으로 변환한 결과를 근거로 쓰기 전에 원본 PDF와 대조하세요. 단순한 표지가 아니라 단이 있는 페이지, 각주, 표가 있는 페이지부터 시작하세요. 한 단의 마지막 문장과 다음 단의 첫 문장을 읽어 보세요. 사람이 PDF에서 따라가는 것과 같은 순서를 이뤄야 합니다. 그다음 표 머리글, 음수 값, 단위를 비교하세요. 읽기 좋은 Markdown 미리보기도 여전히 OCR 오인식이나 잘못 놓인 셀을 담고 있을 수 있습니다. 문서가 재무나 기술적 결정을 이끈다면 Markdown 옆에 PDF를 보관하고 인용하려는 구절을 검증하세요. 변환은 텍스트 작업을 쉽게 만들 뿐, 출처나 전사를 보증하지 않습니다.
달라지는 것
PDF에서 Markdown으로의 변환은 시각적 위치를 텍스트 구조로 바꿉니다. 큰 제목은 제목 표시가 되고, 문단은 문단으로 남으며, 지원되는 표는 파이프로 구분된 행이 됩니다. 페이지 기하 구조, 장식 선, 글꼴, 원래 줄바꿈은 출력 계약에 포함되지 않습니다. 발췌를 편집하거나 검색 색인을 만들 때 유용하지만, 소책자를 정확히 재현하는 것이 목표일 때는 맞지 않습니다. 승인된 레이아웃을 위해 원본 PDF를 보관하세요. 단순한 Markdown 표로 표현할 수 없는 레이아웃은 짧은 설명이나 손으로 다듬은 표가 더 명확한 후속 표현인지 확인하세요.
RAG용 출처
Markdown을 조각으로 나눌 때 맥락을 유지하려면 PDF 제목과 의미 있는 섹션 제목을 사용하세요. 제목이 '결과'뿐인 조각은 문서 밖으로 나가면 모호할 수 있습니다. 수집 코드에서 문서 이름과 상위 제목을 그 조각과 함께 보관할 수 있습니다. 표 머리글은 해당 행과 함께 두고, 조건 중간에서 목록을 자르지 마세요. 검색된 답변이 읽는 이를 출처로 돌려보낼 수 있도록 원본 PDF 참조를 따로 저장하세요. LangChain과 LlamaIndex는 자체 수집 프로세스의 텍스트를 소비할 수 있지만, 분할기, 임베딩 모델, 검색 정책 선택은 여전히 애플리케이션의 몫입니다. PDF에서 답을 검증한 질문으로 검색을 시험하세요.
PDF 선택
읽을 수 있는 텍스트가 들어 있다면 원래 내보낸 PDF를 우선하세요. 그 PDF의 스크린샷은 이미지 인식 단계를 하나 더하고 변환이 시작되기 전에 작은 문자를 잃을 수 있습니다. 스캔한 PDF라면 기울어진 페이지를 반듯하게 하고, 보통 배율에서 문장 부호와 표 테두리가 읽히는 버전을 사용하세요. 암호화된 PDF는 업로드 전에 비밀번호를 제거하세요. 긴 보고서의 일부만 관련 있다면 해당 원본 페이지를 준비하고 노트에 원래 참조를 남기세요. 같은 손상된 스캔을 반복해도 빠진 세부가 고쳐지기 어려우니, 먼저 원본을 개선한 뒤 새 PDF→Markdown 결과를 이전 것과 비교하세요.
청크 경계
검색 품질은 청크 경계가 사람이 읽을 문서와 맞아떨어지는지에 달려 있습니다. 이 변환기는 단을 재배열하고 제목 수준을 보존해, 분할기가 2단 기사의 뒤섞인 조각 대신 구절을 내보낼 수 있게 합니다.
- 평탄화한 텍스트 덤프가 아니라 Markdown을 청킹하고 임베딩할 결과물로 사용하세요.
- 일반 페이지와 OCR 페이지는 로그인 요금제에서 페이지당 1크레딧으로 과금됩니다.
- 암호로 보호된 파일은 업로드 전에 잠금을 해제해야 하며, 암호화된 PDF는 거부됩니다.
더 많은 Markdown 변환기
- Word → Markdown제목과 목록이 있는 DOCX
- PPT → Markdown슬라이드 텍스트, 노트, 표
- Excel → Markdown각 시트를 표로
- Image → Markdown스캔본과 스크린샷을 위한 OCR
- HTML → MarkdownHTML 붙여 넣기 또는 업로드
- URL → Markdown모든 공개 웹 페이지를 깔끔하게
- Markdown → HTML깔끔한 시맨틱 HTML
- Markdown → Text마크업 없는 일반 텍스트
- Markdown → PDF로컬에서 PDF로 인쇄
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
PDF 마크다운 변환 FAQ
PDF 마크다운 변환은 어떻게 동작하나요?
PDF 마크다운 변환은 지원되는 원본을 읽고 재사용할 수 있는 Markdown으로 바꿉니다. 익명 체험은 파일당 최대 10MB, 25페이지를 허용하며, IP당 시간당 3회, 하루 10회 변환할 수 있습니다. 사용 전에 결과를 원본과 비교하세요.
PDF의 최대 크기는 얼마인가요?
공개 변환기는 최대 10MB PDF 파일을 허용합니다. Lite는 최대 100MB, Pro와 Max는 더 높은 한도를 지원합니다.
스캔한 PDF도 지원하나요?
네. 이미지 기반 PDF는 지금도 OCR로 처리하며, 선명한 고해상도 스캔이 가장 좋은 결과를 냅니다.
여러 단으로 된 연구 논문도 처리하나요?
네. PDF 마크다운 변환은 읽기 순서를 재구성하려 시도합니다. 복잡한 레이아웃은 여전히 교정이 필요할 수 있으니 단 사이 전환을 원본과 비교하세요.
재무 표도 살아남나요?
구조 메타데이터가 있는 PDF의 표는 Markdown 표로 변환됩니다. 평탄화된 이미지 표는 복구하려면 OCR이 필요합니다.
암호로 보호된 PDF를 변환할 수 있나요?
아니요. 암호화된 PDF는 파싱할 수 없습니다. 업로드 전에 비밀번호를 제거하세요.
결과를 RAG용으로 청킹해도 되나요?
Markdown은 가능한 곳에서 제목, 목록, 표를 보존하므로 복사·붙여 넣기에 비해 청킹과 임베딩이 예측 가능하게 유지됩니다.
코드에서 PDF를 변환할 수 있나요?
네. API 키로 파일을 /v1/convert/pdf에 직접 보내고 응답에서 Markdown을 읽으세요. /developers를 확인하세요.