
변환기
URL 마크다운 변환
URL 마크다운 변환은 공개 접근 가능한 웹 페이지를 사이트 내비게이션 없이 본문—기사, 문서 페이지, 스레드—만 담은 깔끔한 Markdown으로 바꾸는 무료 변환기로, LLM, RAG 프로세스, 노트에 바로 쓸 수 있습니다. 체험에 가입이 필요 없으며, IP당 시간당 3회, 하루 10회 변환할 수 있습니다.
사용 방법
웹 페이지를 Markdown으로 변환하는 방법
붙여 넣을 수 있는 것
- 공개 http(s) 페이지라면 무엇이든: 기사, 문서, 블로그 글
- 로그인 뒤나 유료 장벽 뒤의 페이지는 가져올 수 없습니다
- 페이지는 우리 서버에서 내려받으며 JavaScript를 실행하지 않습니다
- 계정 없이 체험하세요: 파일당 최대 10MB, 25페이지, 시간당 3회, 하루 10회
확인할 것
- 서버에서 다운로드 — 페이지는 서버에서 내려받으며, 먼저 Markdown을 요청하고 그다음 HTML을 요청합니다.
- 본문 추출 — 가독성 점수, 상용구 탐지, 텍스트 밀도 분석, 페이지 자체의 main이나 article 요소 등 여러 추출기가 경쟁하며, 구조와 본문을 가장 많이 보존한 결과가 채택됩니다.
- JavaScript로 렌더링되는 페이지 — 빈 애플리케이션 셸은 헤드리스 브라우저에서 렌더링되며, 페이지가 안정될 때까지 기다린 뒤 렌더링된 DOM을 같은 추출 과정에 넘깁니다.
- 공개 페이지, 크기와 신원 — 공개 접근 가능한 URL만 지원됩니다.
Markdown이 가는 곳
- 미리보기에서 Markdown을 바로 복사하세요
- .md 파일을 내려받고 로그인 시 라이브러리에 저장하세요
- POST /v1/convert/url의 urls 배열로 여러 페이지를 한 번에 변환하세요
- POST /v1/convert/url와 API 키로 자동화하세요
사용하는 이유
이 URL 마크다운 변환을 쓰는 이유
웹 페이지는 브라우저를 위해 쓰였습니다. Markdown은 사람과 모델을 위해 쓰였습니다. 이 변환기는 페이지에서 의미를 담은 부분을 찾아 구조는 보존하고 사이트의 나머지 장식은 남겨 둡니다.
전체 페이지가 아니라 본문만
여러 추출기가 페이지를 읽고 기사를 가장 많이 보존한 결과가 채택되므로, 메뉴·쿠키 배너·바닥글·관련 게시물 목록은 Markdown에서 빠집니다.
지속되는 구조
제목, 목록, 표, 코드 블록이 Markdown으로 도착하며, 상대 링크와 이미지 경로는 모두 페이지 밖에서도 동작하는 전체 URL로 다시 작성됩니다.
JavaScript 페이지도 렌더링합니다
첫 HTML이 빈 애플리케이션 셸이면 페이지를 헤드리스 브라우저에서 렌더링한 뒤, 렌더링된 콘텐츠를 대신 변환합니다.
무료 체험, 로그인 불필요
계정 없이 Markdown을 미리 보고 복사할 수 있으며 시간당 3회, 하루 10회까지 가능합니다. .md 파일을 내려받으려면 로그인하세요.
예의 바르고 식별되는 다운로더
모든 요청이 문서화된 user agent로 자신을 밝히며 사이트 소유자가 차단할 수 있습니다. 문서의 다운로더 페이지를 확인하세요.
API와 같은 엔진
이 페이지의 변환기와 POST /v1/convert/url는 같은 코드를 실행하므로 스크립트가 호출당 최대 20개 URL을 변환할 수 있습니다.
문제
활성 페이지가 모델에 노이즈가 되는 이유
페이지가 시끄럽습니다
활성 웹 페이지는 내비게이션, 광고, 배너, 스크립트 아래에 내용을 파묻으며, 그 양이 기사 자체보다 몇 배 많은 경우도 흔합니다.
마크업이 지저분합니다
손으로 쓴 HTML과 생성된 HTML은 읽기 좋은 구조와 깔끔하게 대응하는 경우가 드뭅니다.
AI에는 기사가 필요합니다
RAG와 에이전트는 주위 인터페이스 요소가 아니라 기사를 원하며, 일부 페이지는 JavaScript가 실행된 뒤에야 기사를 보여 줍니다.
보존되는 것
이 URL 변환기가 내려받는 것
- 서버에서 다운로드
- 페이지는 서버에서 내려받으며, 먼저 Markdown을 요청하고 그다음 HTML을 요청합니다. 사이트 자체 Markdown은 품질 검사를 통과할 때만 사용됩니다. 브라우저 플러그인이나 로컬 도구가 필요하지 않습니다.Source: RFC 9110: HTTP Semantics
- 본문 추출
- 가독성 점수, 상용구 탐지, 텍스트 밀도 분석, 페이지 자체의 main이나 article 요소 등 여러 추출기가 경쟁하며, 구조와 본문을 가장 많이 보존한 결과가 채택됩니다. 문서 생성기, GitHub, Wikipedia 같은 잘 알려진 사이트는 사이트별 규칙을 씁니다.Source: HTML Living Standard: the main element
- JavaScript로 렌더링되는 페이지
- 빈 애플리케이션 셸은 헤드리스 브라우저에서 렌더링되며, 페이지가 안정될 때까지 기다린 뒤 렌더링된 DOM을 같은 추출 과정에 넘깁니다. 클릭이나 스크롤 후에만 나타나는 콘텐츠는 담아내지 못합니다.Source: HTML Living Standard
- 공개 페이지, 크기와 신원
- 공개 접근 가능한 URL만 지원됩니다. 인증, 유료 장벽, 로그인 화면 뒤의 페이지는 내려받을 수 없습니다. 내려받은 페이지는 응답 크기 한도의 적용을 받으며, 다운로더의 user agent는 /docs/fetcher에 문서화되어 있습니다.Source: product pipeline
예시: URL 다운로드로 가져온 markitdown.ai 블로그 글· https://markitdown.ai/blog/why-pdfs-break-llms
# Why PDFs break LLMs — and what clean Markdown fixes _Published 2026-06-12 · The markitdown.ai team_ > A PDF that looks perfect to a human often falls apart the moment a model reads it. Here's what goes wrong, and why converting to clean Markdown first makes downstream AI far more reliable. A PDF renders perfectly for a human and falls apart the moment a model reads it. The page you see — columns, tables, headers, footnotes — is a *visual* arrangement, not a logical one. When you pull raw text out of it, that visual order rarely survives, and whatever you feed a language model is only as good as the text it actually receives. ## What actually goes wrong When teams pipe documents straight into an LLM or a retrieval index, a few failure modes show up again and again: - **Reading order breaks.** Multi-column layouts interleave. A two-column page becomes "line 1 left, line 1 right, line 2 left, line 2 right…", so a sentence a human reads top-to-bottom arrives at the model scrambled.- **Tables collapse.** Copy-paste turns a table into a loose run of numbers. The relationship between a header and its cell — the entire point of a table — is gone.- **Headings disappear.** The visual hierarchy (this is a section, this is a subsection) is encoded as font size and weight, not structure. Strip the styling and you get one undifferentiated wall of text. 사용 사례
웹사이트→Markdown 변환 사용 사례
AI 에이전트부터 콘텐츠 마이그레이션까지, 웹 페이지를 Markdown으로 변환하는 일은 많은 워크플로가 의존하는 작은 단계입니다.
AI와 LLM 파이프라인
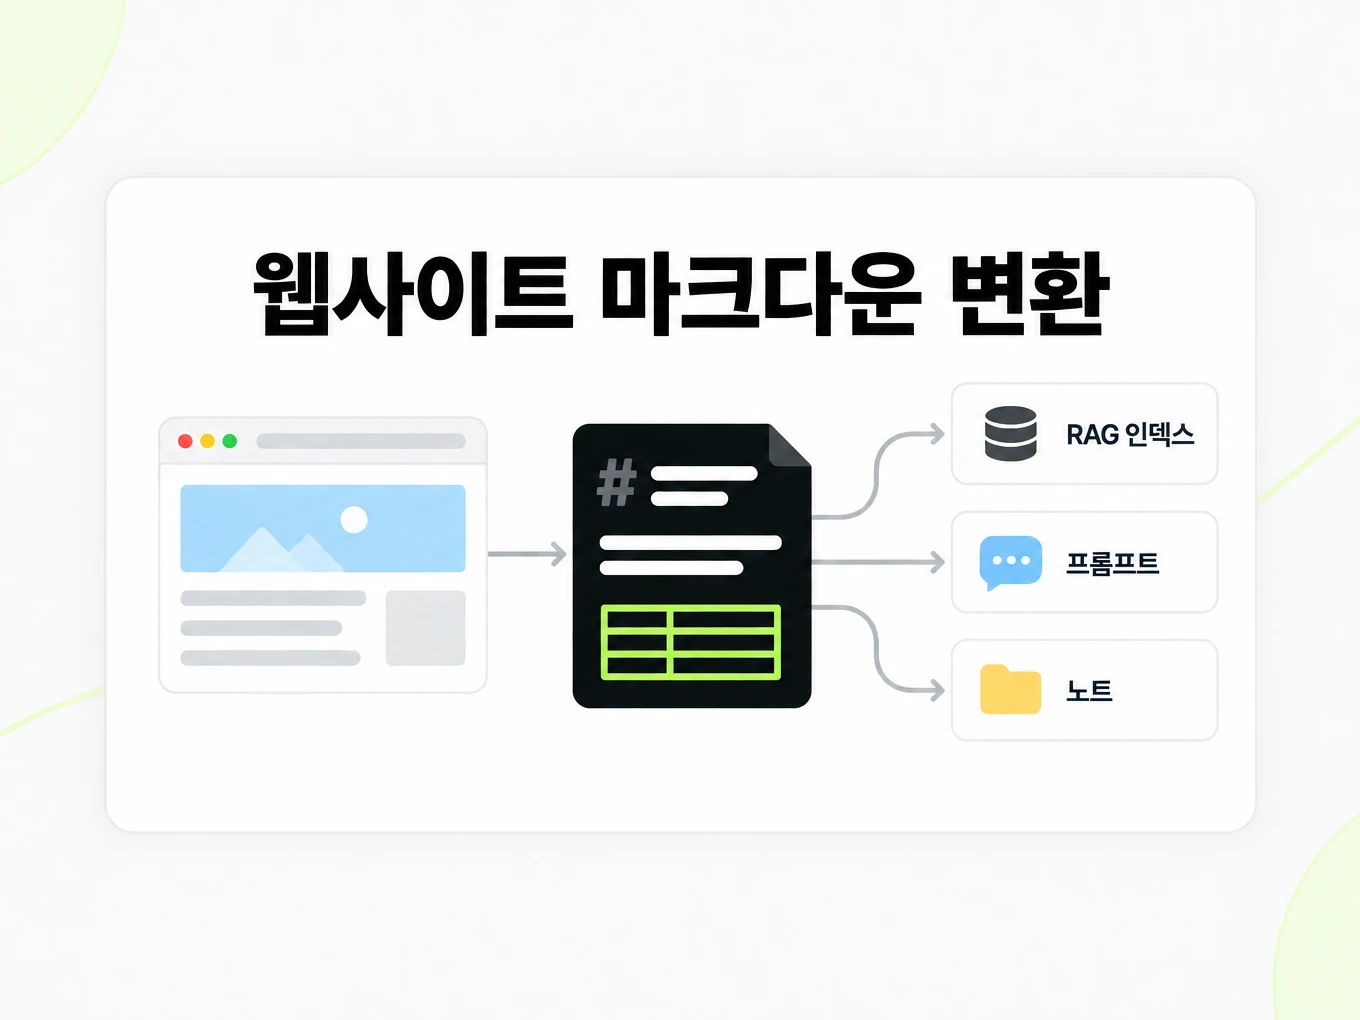
가공되지 않은 HTML 대신 제목이 그대로 남은 깔끔한 텍스트로 기사와 문서를 RAG 색인, 에이전트 도구, 프롬프트에 공급하세요.
연구와 노트
출처를 Markdown으로 저장해 인용, 주석, Obsidian이나 노트 저장소 보관을 하세요. 원본 링크는 제자리에 남습니다.
콘텐츠 팀
글과 도움말 페이지를 한 CMS에서 다른 CMS로 옮기거나, Markdown 기반 문서 사이트로 참조 자료를 가져가세요.
개발자
이미 실행하는 수집 작업과 크롤러에서 API를 호출해 브라우저 변환기가 보여 주는 것과 같은 Markdown을 받으세요.
API
개발자를 위한 URL 마크다운 변환 API
코드에서 페이지를 변환하나요? URL 하나—또는 urls 배열로 최대 20개—를 API 키와 함께 POST /v1/convert/url로 보내세요. render를 auto, force, skip 중 하나로 설정해 JavaScript 렌더링을 제어하고, frontmatter를 true로 설정하면 페이지 제목·작성자·게시일이 YAML 프런트매터에 담겨 옵니다. 페이지가 대기 창 안에 끝나면 같은 응답으로 Markdown이 돌아오고, 그렇지 않으면 폴링하거나 완료 시 웹훅을 받을 변환 작업을 얻습니다. API 액세스는 유료 요금제에 있습니다.
API 가이드 읽기curl -X POST https://api.markitdown.ai/v1/convert/url \ -H "x-api-key: mdai_…" \ -H "content-type: application/json" \ -d '{"url":"https://markitdown.ai/blog/why-pdfs-break-llms","frontmatter":true}'가이드
결과 검토
URL→Markdown 결과를 보낸 공개 페이지와 나란히 검토하세요. 변환기는 본문을 유지하고 내비게이션, 쿠키 안내, 바닥글 링크는 제외하지만, 뚜렷한 기사가 없는 페이지—제품 페이지, 랜딩 페이지, 티저가 많은 홈페이지—는 사이드 패널을 놓치거나 인용하고 싶지 않은 블록을 남길 수 있습니다. 결과를 색인하기 전에 처음과 끝 문단을 페이지와 대조하세요. JavaScript로 콘텐츠를 구성하는 페이지는 먼저 브라우저에서 렌더링되지만, 클릭·스크롤·로그인 후에만 텍스트가 로드되는 페이지는 여전히 담아낼 수 없습니다. 사이트가 이미 자체 Markdown을 요청하는 클라이언트에 제공하는 경우, 변환기는 그 버전이 품질 검사를 통과하면 그대로 쓰고, 사이트 전체 메뉴나 아카이브 덤프처럼 보이면 HTML 페이지로 되돌아갑니다. 독자가 원래 페이지로 돌아갈 수 있도록 Markdown 옆에 원본 URL을 보관하세요.
출처 맥락 보존
자체 워크플로에서 URL→Markdown 결과 옆에 보낸 URL과 가져온 날짜를 보관하세요. 공개 페이지는 변환 후 바뀔 수 있으므로 나중에 방문하는 사람은 수정된 구절을 볼 수 있습니다. 프런트매터를 켜면 결과는 원본 URL, canonical URL, 제목으로 시작하고—페이지가 밝히는 경우—작성자, 게시일, 설명, 사이트 이름, 언어, 대표 이미지가 페이지의 메타 태그·구조화 데이터·바이라인에서 읽혀 뒤따릅니다. 이 필드들은 페이지가 스스로 밝히는 내용을 그대로 옮긴 것이므로, 조사에 필요하다면 출처에서 확인하세요. API의 metadata 필드는 다릅니다: 이것은 오직 직접 제공한 맥락만 담습니다. 표나 문단을 인용하기 전에 페이지와 비교하고 의미가 바뀌지 않을 만큼 충분한 주변 맥락을 보관하세요. Markdown은 웹 콘텐츠를 더 쉽게 재사용하게 할 뿐, 페이지의 정확성이나 재게시 권한을 판단하지 않습니다.
저장된 HTML과 URL
처리해야 할 페이지의 정확한 스냅샷이 이미 있을 때는 HTML 변환기를 고르세요. 현재 변환의 입력이 공개 접근 주소일 때는 URL 마크다운 변환을 고르세요. 출처 제어가 다른 관련 워크플로입니다. 저장된 파일은 보내는 입력을 고정해 전체가 변환되고, URL은 요청 시점에 웹사이트가 반환하는 것에 의존하며 본문만 남도록 축소됩니다. 어느 경로도 접근 제한을 우회하지 않습니다. 사이트가 다운로더를 거부하거나 로그인을 요구하면 적절한 워크플로로 가져올 권한이 있는 자료를 사용하세요. 다른 변환 시도가 접근을 허가하듯 접근 불가 URL을 반복 재시도하지 마세요.
LLM을 활용한 연구
연구자는 파일이 아니라 출처를 붙여 넣습니다. 이 변환기는 보낸 URL을 내려받아 기사나 문서 본문을 보존하고, 인용·청킹·노트 앱 저장에 쓸 수 있는 Markdown을 링크가 여전히 유효한 채로 돌려줍니다. 서버가 빈 셸을 보내면 JavaScript 페이지를 렌더링하며, 유료 장벽에는 로그인하지 않습니다.
- 공개 접근 URL만 지원됩니다.
- 다운로더는 자신을 밝히며 운영자는 user agent를 거부할 수 있습니다. /docs/fetcher를 확인하세요.
- 저장된 HTML 파일은 여기가 아니라 /html-to-markdown으로 갑니다.
더 많은 Markdown 변환기
- PDF → Markdown텍스트, 표, 스캔본
- Word → Markdown제목과 목록이 있는 DOCX
- PPT → Markdown슬라이드 텍스트, 노트, 표
- Excel → Markdown각 시트를 표로
- EPUB → Markdown전자책 장을 제목으로
- Image → Markdown스캔본과 스크린샷을 위한 OCR
- HTML → MarkdownHTML 붙여 넣기 또는 업로드
- Markdown → HTML깔끔한 시맨틱 HTML
- Markdown → Text마크업 없는 일반 텍스트
- Markdown → PDF로컬에서 PDF로 인쇄
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
URL 마크다운 변환 FAQ
URL 마크다운 변환은 어떻게 동작하나요?
URL 마크다운 변환은 붙여 넣은 공개 페이지를 내려받아 본문을 보존하고, 전체 URL 링크와 함께 Markdown으로 변환합니다—업로드할 파일이 없습니다. JavaScript가 필요한 페이지는 먼저 브라우저에서 렌더링됩니다.
활성 페이지의 광고와 내비게이션이 제거되나요?
본문 영역이 뚜렷한 페이지라면 그렇습니다. URL 마크다운 변환은 기사, 문서 본문, 스레드는 유지하고 메뉴, 쿠키 배너, 바닥글은 제거합니다. 하나의 본문 블록이 없는 랜딩 페이지나 제품 페이지는 사이드 패널이 남거나 빠질 수 있으니 결과를 확인하세요.
다운로드한 페이지에 크기 제한이 있나요?
공개 변환기는 공개 웹 페이지에서 동작합니다. 내려받은 페이지는 응답 크기 한도의 적용을 받으며 너무 크면 거부될 수 있습니다.
로그인 뒤 페이지에도 동작하나요?
아니요. 공개 접근 URL만 지원됩니다. 인증, 유료 장벽, 로그인 화면 뒤의 페이지는 내려받을 수 없습니다.
JavaScript로 렌더링되는 페이지는 어떻게 되나요?
JavaScript로 렌더링되는 페이지는 첫 HTML이 빈 셸일 때 헤드리스 브라우저에서 렌더링된 뒤, 다른 페이지와 마찬가지로 변환됩니다. API에서는 render를 force로 설정하면 항상 렌더링하고, skip으로 설정하면 절대 렌더링하지 않습니다. 클릭, 스크롤, 로그인 후에만 나타나는 텍스트는 담아내지 못합니다.
여러 URL을 한 번에 변환할 수 있나요?
최대 20개 공개 URL을 담은 urls 배열을 POST /v1/convert/url로 보내세요. 각 파일의 결과를 추적하고 비동기 응답을 처리하세요. /developers를 확인하세요.
URL 마크다운 변환은 무료인가요?
네. Markdown 미리보기와 복사는 계정 없이 무료이며, 시간당 3회, 하루 10회까지 가능합니다. .md 파일을 내려받으려면 로그인해야 합니다. 공개 웹 페이지만 지원됩니다(내부·사설 URL 불가).
변환기가 어떤 내용을 보존하나요?
변환기는 본문의 제목, 문단, 목록, 링크, 이미지, 표, 코드 블록을 보존하며, 상대 링크는 전체 URL로 다시 작성됩니다. 스크립트, 스타일, 내비게이션, 바닥글은 제거됩니다. 프런트매터를 켜면 페이지 제목, 작성자, 게시일이 맨 위에 붙습니다.
URL 변환 API가 있나요?
네. REST API를 통해 프로그래밍 방식으로 URL의 웹 페이지를 변환하세요. /developers를 확인하세요. 저장된 HTML 파일은 /html-to-markdown을 사용합니다.