
面向文档与网页的 Markdown 转换。
面向文档和公开网页的 Markdown 转换器:把 PDF、Word、PowerPoint、Excel、图片和 HTML 变成可检查、可复用、可交给 AI 工作流的文本。
匿名试用 · 10 MB · 每小时 3 次 · 每天 10 次
可从以下格式转换为 Markdown
- DOCX
- PPTX
- XLSX
- PNG / JPG
- HTML
- URL
工作原理
Markdown 转换器如何工作
markitdown.ai 是一款 Markdown 转换工具,通过匿名试用或带开发者 API 访问权限的付费账号,把 PDF、Office 文件、图片和网页变成干净、适合 AI 的 Markdown,供 ChatGPT、Claude、RAG 流水线和智能体使用。
What happens
上传文件或粘贴 URL。转换在我们服务器上运行,而不是浏览器里的复制粘贴小技巧,所以同一份文件无论从哪里进来,都会得到同样的 Markdown。每个页面按其中实际包含的内容来处理,标题、列表和表格都会输出为真正的 Markdown 结构。
What you get
- 文本层页面直接读取;扫描件和图片自动走 OCR
- URL 抓取从我们的服务器发起,并屏蔽私有和内部地址
- 公开转换器:最大 10 MB、25 页,无需登录
- 登录套餐会提高这两项上限,Pro 最大 200 MB、200 页
What happens
查看器把源文档和生成的 Markdown 并排放置,方便你在使用结果前核对标题、表格和阅读顺序。在渲染预览和原始 Markdown 之间切换,就能确切看到模型或流水线会收到什么。
What you get
- 查看器把源文件和 Markdown 并排渲染
- Markdown 面板可在渲染预览和原始源码之间切换
- 复制结果免费,无需账号
- 登录后可下载 .md 文件
What happens
对单个文件有效的设置,可以直接沿用到一批文件或一次流水线调用,每个结果都会落到你的库中。批量会为每个文件记录各自的状态并支持重试,API 则把同一份 Markdown 直接交给你的代码。
What you get
- 网页端、批量(ZIP 或 URL 列表)和 API 使用同一套解析引擎
- POST /v1/convert/{name} 在 60 秒内一次性返回 Markdown,否则返回一个可轮询或通过 webhook 接收的转换任务
- 库按套餐的历史窗口保留每次运行:30、60 或 90 天
credit
Markdown 精度,按页计费。
一份带文本层的发票和一份扫描版资产负债表,每页计费相同:流水线替你选择直接提取还是 OCR。针对图表和图片的 AI 附加项为可选项,单独计量。
- 每页,文本或扫描件
- 1 credit
- 每页,文本或扫描件
带文本层的 PDF、Office 文件和 HTML
对扫描页、照片和截图运行 OCR
为 PDF 中的图表和图示生成文字说明 · 付费套餐
描述图片内容,而不只是 OCR · 付费套餐
Markdown API
为你的 RAG 流水线打造的 Markdown API。
- 与网页端相同的解析流水线
- 用 webhook 在完成时批量处理成千上万个文件
- 限定范围的 API 密钥和完整活动日志
- 一次调用返回 Markdown,或在文件需要超过 60 秒时返回可轮询的转换任务
curl -X POST https://api.markitdown.ai/v1/convert/word \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F file=@vendor-security-review-q3-2026.docx # If HTTP 202, GET the Location URL with the same API key.# Verified local parser output for vendor-security-review-q3-2026.docx:# ## Review Findings# # Risk ratings follow the standard High / Medium / Low scale defined in the vendor risk management policy.# # | Vendor | Risk Rating | Finding | Owner |# | --- | --- | --- | --- |# | CloudScan OCR | Medium | No documented data retention limit on uploaded scans | Security |# | PayBridge | Low | SOC 2 Type II renewed; no open items | Finance |# | LingoTrans API | High | Sub-processor list not disclosed on request | Legal |# | ArchiveNow Storage | Medium | Encryption at rest confirmed; key rotation overdue | Security |问题所在
文档还没准备好给 AI
大多数文档是为人眼和打印机做的,而不是为语言模型做的。一份文件在被嵌入、检索或推理之前,必须先变成可预测的文本。这比看起来更难,而这正是粗暴提取会失灵的地方。
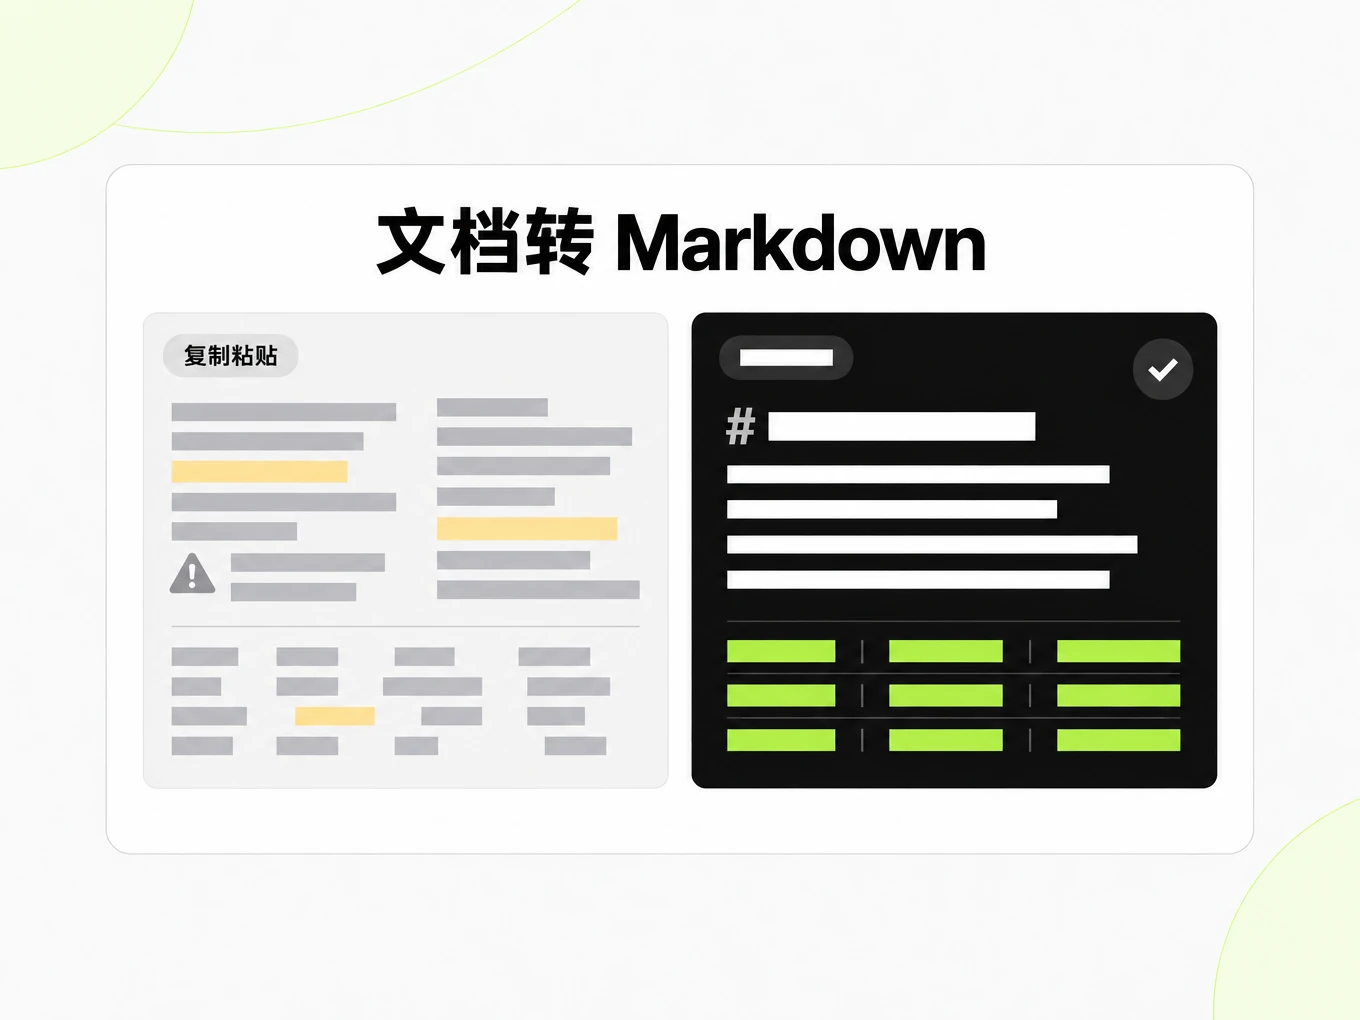
阅读顺序被打乱
多栏 PDF、页眉和脚注会交错在一起,于是 LLM 读到的文本不再对应人看到的文档。
表格和标题被压平
复制粘贴会把表格塌缩成一串数字,并丢掉赋予文档结构的标题层级。
扫描件需要 OCR
基于图片的页面和扫描合同在运行光学字符识别之前完全没有文本层。
原始文本充满噪声
临时凑合的提取会留下页码、错误的连字符和杂散字符,污染提示词和检索结果。
RAG 流水线和智能体需要一致的结构,而不只是提取出的字符。可预测的 Markdown 才能让分块、嵌入和检索在成千上万份文档上表现一致,而不是在那些杂乱的文档上悄悄失败。能处理好丑文件的解析器,才是让干净文件值得信赖的保障。
支持的输入格式
把任何文档转换为 Markdown
每种输入格式都有自己的转换器页面,包含限额、格式说明和示例输出。它们共用同一套解析引擎,所以请选与你文件匹配的页面:
- PDF 转 Markdown — 报告、论文、手册和合同。原生文本 PDF 直接解析并重建多栏阅读顺序;扫描版 PDF 逐页走 OCR。
- Word 转 Markdown — .docx 和旧版 .doc 文件,保留标题、列表、表格和批注,让一份政策或规范读起来像大纲,而不是一整块文字。
- PPT 转 Markdown — .pptx 和 .ppt 演示文稿逐张幻灯片转换,幻灯片标题作为标题,项目符号和表格保留,让一份 40 页的演示可被搜索。
- Excel 转 Markdown — .xlsx 和 .xls 工作簿,每个工作表在其表名下变成一个 Markdown 表格。
- 图片转 Markdown — PNG 和 JPG 截图与扫描件走 OCR。AI 图片理解是需要登录的独立选项。
- HTML 转 Markdown — 保存下来的页面、导出文件和片段,剥离脚本与样式,保留文章结构、链接和表格。
- URL 转 Markdown — 粘贴一个公开网址,就能得到该页面的 Markdown;抓取在服务器端进行,带有体积上限和超时,慢站点不会把请求挂住。
支持的输出格式
从 Markdown 转成任何格式
Markdown 是交换格式,所以转换也能反向进行。下面的 Markdown 编辑器在你输入时于浏览器中渲染,绝不上传你的文本:
- Markdown 转 HTML — 干净的语义化 HTML,支持 GitHub 风格的表格、任务列表和代码高亮,可直接粘贴进 CMS 或邮件。
- Markdown 转文本 — 把标题、列表和表格压平成易读的纯文本,适合聊天窗口、工单和表单。
- Markdown 转 PDF — 本地打印预览;用浏览器的打印 / 另存为 PDF,并检查保存下来的页面。
结构化 JSON 抽取以及音频和视频转录是规划中、叠在 Markdown 之上的能力。它们列为路线图,而不是已上线功能。
使用场景
为每个团队而生
Markdown 转换器提供匿名试用,供你先验证第一个结果。团队持续使用它的原因在第一个文件之后的一切:历史记录、批量、更大的文档,以及一个能把转换并入你现有系统的 API。无论使用者是人、搜索索引还是模型,同一份 Markdown 都适用。
RAG 与 AI 流水线
在分块、嵌入或交给智能体处理之前,先把源文档转换成干净的 Markdown。可预测的结构意味着你的切分器看到的是真正的标题和表格,而不是一整墙提取文本,从而让检索保持相关、提示词不带版式噪声。
研究与报告
把论文、白皮书和幻灯片变成可编辑、可搜索的 Markdown。研究人员和分析师可以引用、批注、总结和复用这些发现,而无需重新录入表格,也不会丢掉密集 PDF 的阅读顺序。
运营文档
处理政策、合同、发票和内部文件,无需手动复制粘贴清理。保存下来的 Markdown 历史让重复性的文档工作更容易复核、对比,并在团队的日常运营中复用。
开发者自动化
用 API 在数据摄取任务、内部工具和文档工作流中转换文件。提交一个请求,拿到 Markdown,再把它送入 CMS、知识库、客服机器人或智能体流水线,输出可以放心依赖。
知识库与客服
把产品手册、发布说明和内部 wiki 汇入一个统一的 Markdown 语料库,供客服机器人或内部助手检索。由于标题和表格得以保留,答案会指向正确的章节,而不是一整页大小的文本块。
智能体与工具
给你的智能体一个可处理受支持文件和公开 URL 的 Markdown 转换器,并在它使用结果前检查是否完成。也可以这样读取本站:每个公开页面都会以 Markdown 孪生页响应 Accept: text/markdown,llms.txt 列出了全部页面。
输出质量
保留结构,不只是文字
一个有用的 Markdown 转换器,保留的不只是从 PDF 里抽出的孤立字符。这里的目标是让 Markdown 保住下游工具所依赖的结构,并且由服务器端解析流水线产出,而不是脆弱的浏览器复制粘贴。
- 在源文件有相应结构的地方,保留标题、列表、表格、链接和阅读顺序。
- 通过一套流水线处理 PDF、Word、PowerPoint、Excel、图片、HTML 和 URL。
- 现已用 OCR 处理扫描版 PDF 和图片;识别质量取决于源图片。
- 长文档异步运行,让大型报告和演示能跑完而不是超时。
标准页和 OCR 页每页 1 credit;付费套餐账号可按每张图片 5 credit 使用 AI 图片理解。输出遵循 CommonMark 与 GitHub 风格表格,因此能在任何 Markdown 查看器中渲染,也能用任何 Markdown 库解析。每次转换都应产出一份可以检查、保存和复用的结果——这就是标准。
三种使用方式
浏览器、API 还是智能体
网页端里的 Markdown 转换器覆盖一次性与重复的手动转换。批量覆盖成堆的文件。API 覆盖一切应当自动发生的场景,包括把 API 当作工具的智能体。三者共用同一个账号、同一份 credit 余额和同一套解析引擎。大多数团队从浏览器开始,等转换成为产品或内部工作流的一部分后,再转向 API。
| Aspect | 浏览器 | 批量 | API |
|---|---|---|---|
| 最适合 | 一次一个文件 | 一次运行多个文件 | 流水线、工具和智能体 |
| 登录 | 第一个文件无需登录 | 付费套餐 | 付费套餐 + API 密钥 |
| 输入 | 上传或 URL | 一组上传文件或文件 ID | 上传、URL、内联文本或文件 ID |
| 输出 | 预览、复制、下载 .md | 带逐文件状态的库 | 带 Markdown 的 JSON、逐页输出、webhook |
| 限额 | 不登录 10 MB、25 页 | 套餐并发数 | 按套餐每分钟 20 到 60 次请求 |
| 等待 | 页面内数秒 | 后台运行 | 同步最长 60 秒,之后是可轮询的转换任务 |
网页端
- 上传文件或粘贴 URL,并预览渲染后的 Markdown
- 保存转换历史并下载 .md 结果
- 用带逐文件状态的批量转换完成重复工作
- 按套餐跟踪 credit 和用量
开发者 API
- POST /v1/convert/{name} 一次调用返回 Markdown,或在文件需要超过 60 秒时返回一个转换任务
- 轮询转换任务,或在它们完成时接收 webhook
- 发送 Accept: text/markdown 即可把任何公开页面当作 Markdown 读取
- 机器可读的规范位于 /v1/openapi.json
FAQ
关于 Markdown 转换的常见问题
Markdown 转换器是做什么的?
文档转 Markdown 转换器是一种工具,它读取 PDF、Word、PowerPoint、Excel、图片或网页,并把其中的内容重写成 Markdown:标题变成 # 行,表格变成竖线表格,列表仍是列表。它要的是可预测的纯文本,让语言模型、RAG 流水线和智能体能对它分块、嵌入和引用,而不受版式噪声干扰。
免费转换器真的免费吗?
是的。公开转换器页面无需账号、无需银行卡。最大 10 MB、25 页的文件可在浏览器里完成转换,并能预览和复制 Markdown。Lite、Pro 与 Max 订阅每月 $20 起,额外提供保存的库、批量和 API。
扫描版 PDF 和图片是怎么处理的?
纯图片页面没有文本层,所以流水线会自动运行 OCR,并像处理数字文本一样返回 Markdown。标准页和 OCR 页每页 1 credit。识别质量取决于源图片:300 dpi 的扫描件远比用手机拍摄的页面好读。
可以从代码或智能体里调用吗?
可以。POST /v1/convert/{name} 接受上传文件、URL 或内联文本,配合 API 密钥,在文件 60 秒内完成时一次性返回 Markdown,否则返回一个可轮询或通过 webhook 接收的转换任务。智能体可以在任何公开页面上请求 Accept: text/markdown,机器可读的规范位于 /v1/openapi.json。
转换后我的文件会怎样?
删除某次转换会立即将它从你的库中移除,并在一小时内清除其存储文件;若某份源文件还被另一次转换使用,则会保留到那次转换也被删除为止。删除账号会清除你所有已存储的源文件和结果文件。付费套餐按套餐保留历史 30、60 或 90 天。