
功能
Markdown 转换能力,端到端。
解析、检查、批量转换并导出 Markdown —— 在网页端和通过 API 都能完成。
功能页展示 markitdown.ai 如何把 PDF、Office 文件、图片和 HTML 转换成面向 RAG 和智能体的结构化 Markdown。 匿名试用接受最大 10 MB、25 页的文件,每个 IP 每小时 3 次、每天 10 次转换。Lite 每月 $20 起,单文件最大 100 MB。Pro 每月 $50,Max 每月 $100。
01 · 解析
每一页都能得到准确的 Markdown
每个文件按页面上实际包含的内容来路由:文本层直接读取,扫描页或图片走 OCR,两者都按每页 1 credit 计费。标题、列表、表格和阅读顺序都会输出为 Markdown。
- 扫描件、照片和截图的 OCR
- 付费套餐中针对图表和图示的 AI 图表增强(每个图表 3 credit)
- 缓存结果可选:关闭后文件会重新解析,而不复用缓存结果
02 · 查看器
并排预览 Markdown
在查看器中打开任意一次转换:一侧是源文档,另一侧是渲染后的 Markdown 或原始源码。让损坏的表格在进入你的流水线之前就被发现。
- 源文件与 Markdown 并排
- 渲染预览与原始 Markdown 源码,一键切换
- 复制,或下载 .md 文件
03 · 批量
批量把文件转换为 Markdown
把一批文件打包成 ZIP 或一个 URL 列表排队。跟踪每个文件,重试失败的那些,并保留每次运行的历史。
- 带逐文件状态的实时进度
- 重试失败文件而无需重跑其余文件
- 批量历史,含每个文件消耗的 credit
04 · 库与账号
你的 Markdown 库,全程有记录
每次转换都会按你套餐的历史窗口保存到库中——Lite 30 天、Pro 60 天、Max 90 天。用量、账单和 API 活动都在设置里。
- 源文件与其 Markdown 配对保存的库
- 按路由和日期统计的用量,外加账单
- 限定范围的 API 密钥、webhook 和活动日志
05 · 能力
Markdown 转换能力,细到每个细节
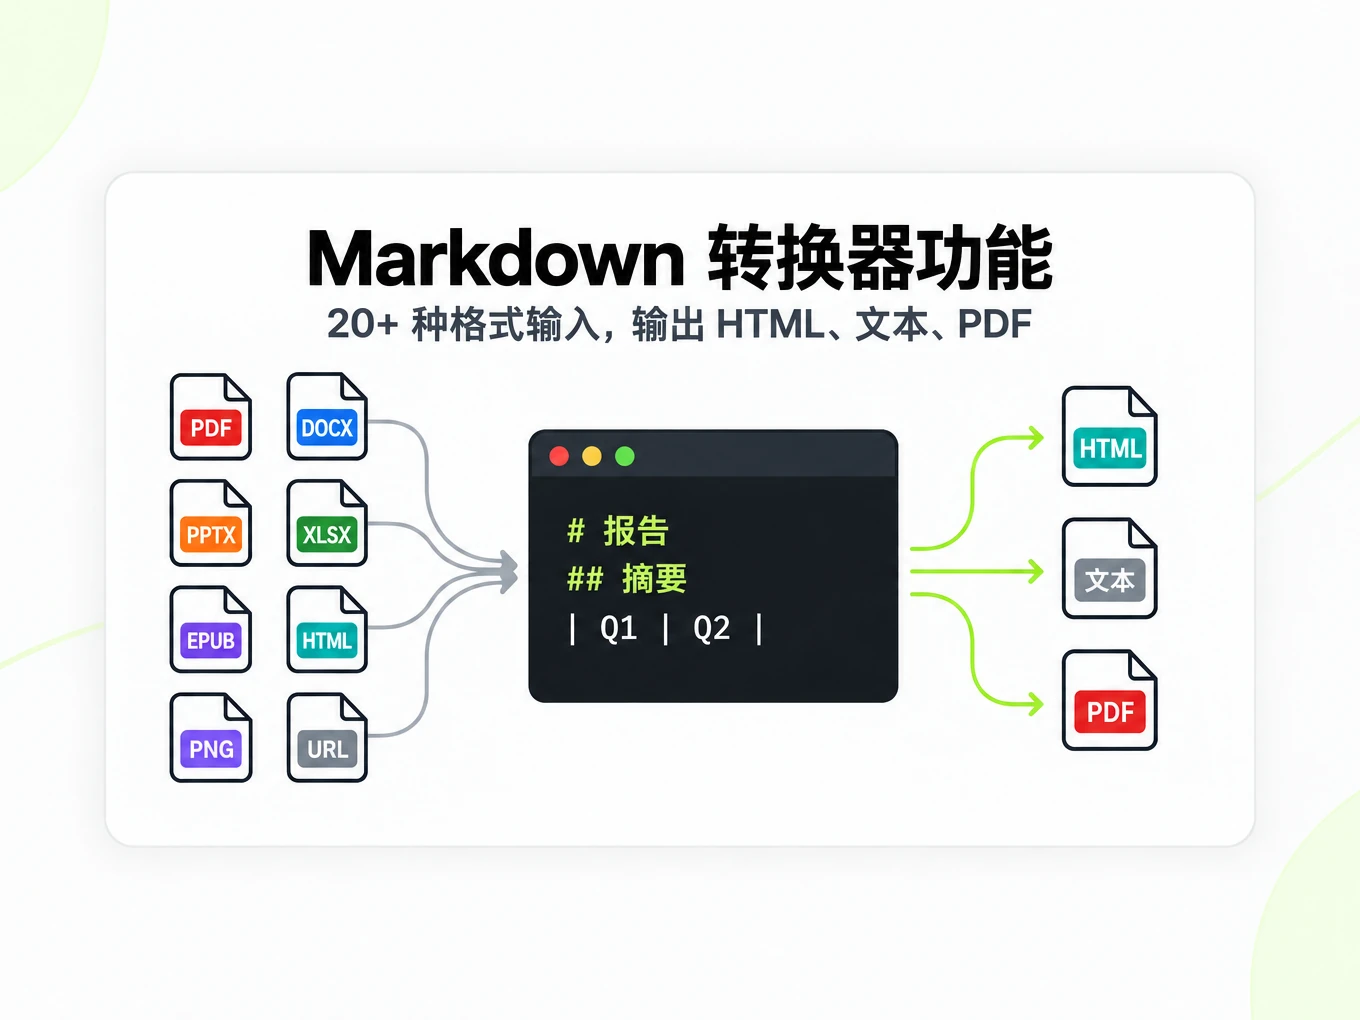
真正的 Markdown 表格
行、列和表头都会输出为 GitHub 风格的竖线表格——而不是被压平的一串数字——适用于 PDF、Office 文件、电子表格和 HTML。
缓存控制
对重复的文件复用匹配的结果,或按每次运行关闭缓存。
图表描述
在付费套餐中,图表和图示可以用文字描述出来,供模型推理。
文档、表格、幻灯片与网页
PDF、Word、PowerPoint、Excel、CSV、EPUB、OpenDocument、图片、HTML 和 URL。
可审计的用量
按路由和日期统计的 credit,外加账单和活动日志。
指南
用真实样本测试
用一个能反映你实际要处理的工作的样本来测试。要包含一张难处理的表格、一个章节边界和来源引用,而不是只测一段短文字。把同一份文档在预览、Markdown 源码和你目标落点里分别对照。这能把解析差异和显示差异区分开,并给你一个实用的依据,判断某套自动化工作流能否承接更大的文档集。
按来源类型选择功能
按你实际拿到的来源来选择 Markdown 转换功能。一份可编辑的 Word 文档、一份纯图片 PDF 和一个公开网页,暴露出的结构各不相同。一次成功的转换应当给你该来源的可读呈现,但之后要做的检查会不同。对 Word 文档,对照标题大纲并复核批注。对扫描件,检查不确定的字符和表格单元格。对网页,留意本不该进入下游文档的导航或页脚文字。试一个有代表性的难输入,比只转换一段简单文字能告诉你更多。在评估转换是否对你的任务有用时,把源文件和输出放在一起看。
检查准确性
用能直接与源文件对照的段落来评估 Markdown 转换的准确性。检查一个标题、一段位于分栏边界附近的文字、一张带单位的表格,以及文档的最后一节。一个干净的预览很有用,但它可能掩盖一个被漏掉的限定条件,或一个落在错误表头下的数值。当你需要查看提示词或摄取脚本会收到的那段确切文字时,切到 Markdown 源码。本服务产出一份输出产物;它并不独立判定原始材料的真伪。复用抽取出的内容时保留来源引用,尤其是当另一个人需要核对某段引文,或把检索到的答案回溯到文档时。
检索工作流
Markdown 转换属于分块、索引和检索这些应用专属工作之前的一步。标题和表格能给切分器比一整条扁平文本流更好的边界,但它们不会替你选嵌入模型,也不保证搜索一定返回正确段落。要把文档标题和章节上下文与你应用创建的分块放在一起。用你在源文件里核对过答案的代表性问题做测试。如果一张表格跨越多个分块,检查每一段被检索到的内容是否仍带有它的表头和单位。像 LangChain 和 LlamaIndex 这类工具可以参与你自己的摄取工作流;Markdown 输出是那套工作流可复用的输入,而不是一个完整的搜索系统。
浏览器、批量与 API
用浏览器检查单个结果,用批量转换整理重复的文件,用 API 把转换接入你自己的应用。这些入口共用账号的转换服务和 credit 余额,但它们解决的是不同的交互需求。浏览器复核让你在自动化之前先看清一份输出。批量给出可以回看的逐文件结果。API 集成则要处理鉴权、请求限额和异步完成。只有在你审查过预期会收到的来源类型之后,才开始自动化,并保留一条追查单个失败的途径。从单个文件走向大批量,改变的是你跟踪结果的方式,而不是丢掉让第一个结果有用的那些质量检查。
现已可用
文档、网页和图片解析现已能产出 Markdown。浏览器还提供 Markdown 转 HTML、纯文本和可打印 PDF。浏览器打印是当前可用的 PDF 输出路径;它不是服务器生成的 PDF 下载。结构化 JSON 抽取、音频和视频转录,以及服务器端 PDF 或 DOCX 输出都是规划中的能力。不要围绕规划中的路由搭建当前集成,也不要以为 OCR 就给出了照片或图表的完整描述。针对你需要的输入和输出,去读对应的转换器页面,然后验证一个有代表性的结果。产品专注于可复用的内容,所以精确的版式还原和协作文档编辑不属于这套工作流。
FAQ
常见问题
是什么让输出适合 AI?
转换会在可能的情况下保留标题、列表、表格和阅读顺序,因此这份 Markdown 转换能力的输出足够可预测,可以直接分块、嵌入和检索,无需手动清理。
可以转换哪些文件类型?
常见文档格式包括 PDF、Word、PowerPoint、Excel、图片和网页内容。匿名试用接受最大 10 MB、25 页的文件,每个 IP 每小时 3 次、每天 10 次。
可以用在 RAG 或智能体工作流里吗?
可以。干净的 Markdown 本就是在分块和嵌入之前的输入层,而 API 让你能在数据摄取任务和智能体流水线里运行转换。
网页端和 API 有什么区别?
网页端用于手动上传、预览、保存和批量处理文档。API 用于在你自己的产品或工具里自动运行同样的转换。
可以批量转换文档吗?
可以。批量转换在付费套餐中提供,让你无需逐个上传和下载就能处理重复的文件。
支持扫描版文档吗?
基于图片的文件和扫描版文档现已用 OCR 处理。识别质量取决于源图片。
会支持 schema JSON 抽取吗?
它是规划中的下一层能力,不是当前功能。Markdown 是我们首先构建的基础产物。
会支持 Markdown 翻译吗?
保留结构的翻译作为规划中的下一层能力,位于路线图上。
这是文档编辑器或 PDF 版式工具吗?
都不是。markitdown.ai 把文档转换成适合 AI 和文本工作流的干净 Markdown;它不是可视化 PDF 或版式编辑器。