
转换器
PDF 转 Markdown
PDF 转 Markdown 是一款把多栏阅读顺序重建为结构化 Markdown 的转换器,适合 RAG。匿名试用接受最大 10 MB 的文件。
如何操作
如何把 PDF 转 Markdown
可以上传什么
- 文件类型:.pdf
- 无需账号即可试用:单文件最大 10 MB、25 页,每小时 3 次、每天 10 次转换
- Lite 支持最大 100 MB 的文件,Pro 支持 200 MB
- Max 没有单文件大小上限;转换量由 credit 限制
需要检查什么
- 阅读顺序重建 —— PDF 转换会尝试重建逻辑阅读顺序。请对照原始文件检查分栏处,尤其是复杂的报告和论文。
- 表格与标题 —— 当 PDF 暴露结构元数据时,标题层级和表格数据会被保留;纯文本 PDF 产出纯文本输出。
- 扫描版和纯图片 PDF —— 没有文本层的 PDF(扫描页和插入的图片)目前用 OCR 处理;准确度取决于扫描质量。
- 受密码保护的文件 —— 加密 PDF 无法解析;请在上传前移除密码。
Markdown 的去向
- 直接从预览中复制 Markdown
- 下载 .md 文件;登录后会保存到你的资料库
- 用批量转换处理整个文件夹或 ZIP 压缩包
- 用 POST /v1/convert/pdf 和你的 API key 自动完成
为什么使用
为什么使用 PDF 转 Markdown
报告变成可读文本
把报告的段落和受支持的结构变成 Markdown,便于检查和编辑,并与源 PDF 并列保存。
扫描页走 OCR
纯图片页面可以用 OCR 识别。把小字、标点和数字表格与原始扫描件对照。
保留标题上下文
为笔记和检索工作流保留可识别的章节,同时检查视觉化的标题是否被正确解读。
表格待复核
受支持的表格会变成文本表格。在把导出的值当作证据前,先检查复杂或合并的单元格。
复用前先预览
在把段落复制进 ChatGPT、Claude 或文档仓库前,把 Markdown 源码与它的渲染视图对照。
可重复调用的 API 路径
在浏览器里复核代表性输出后,把 PDF 转换路径用于你的摄取脚本。
问题所在
为什么 PDF 分栏会难住语言模型
分栏交错
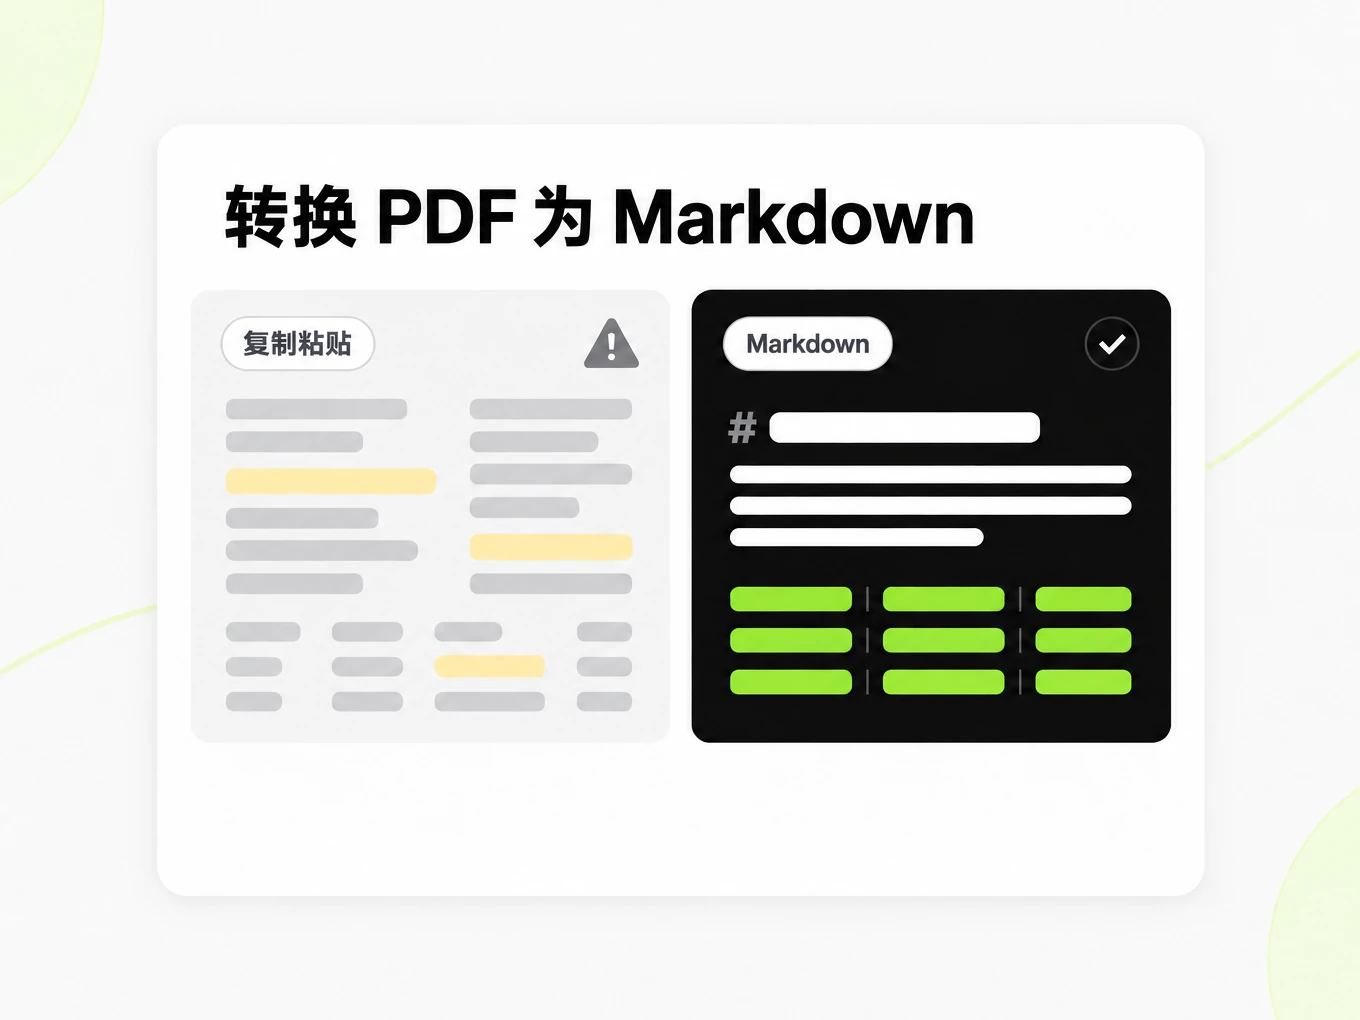
双栏报告按自上而下阅读会混合左右两股文本,于是模型看到一句在页面上从未出现过的话。
表格丢失网格
从 PDF 复制粘贴,会把一张结果表变成一串数字,下游解析器拿不到表头行。
扫描件没有文本层
纯图片页面携带的是像素,不是字形,所以扫描版 PDF 目前用 OCR 处理。
保留什么
这款 PDF 转换器保留什么
- 阅读顺序重建
- PDF 转换会尝试重建逻辑阅读顺序。请对照原始文件检查分栏处,尤其是复杂的报告和论文。Source: ISO 32000-2 (PDF 2.0)
- 表格与标题
- 当 PDF 暴露结构元数据时,标题层级和表格数据会被保留;纯文本 PDF 产出纯文本输出。Source: CommonMark Spec
- 扫描版和纯图片 PDF
- 没有文本层的 PDF(扫描页和插入的图片)目前用 OCR 处理;准确度取决于扫描质量。Source: product pipeline
- 受密码保护的文件
- 加密 PDF 无法解析;请在上传前移除密码。Source: ISO 32000-2 (PDF 2.0)
示例:NIST Cybersecurity Framework 2.0,第 15 页· https://nvlpubs.nist.gov/nistpubs/CSWP/NIST.CSWP.29.pdf
## Appendix A. CSF Core This appendix describes the Functions, Categories, and Subcategories of the CSF Core. Table 1 lists the CSF 2.0 Core Function and Category names and unique alphabetic identifiers. Each Function name in the table is linked to its portion of the appendix. The order of Functions, Categories, and Subcategories of the Core is not alphabetical; it is intended to resonate most with those charged with operationalizing risk management within an organization. The numbering of the Subcategories is intentionally not sequential; gaps in numbering indicate CSF 1.1 Subcategories that were relocated in CSF 2.0. **Table 1. CSF 2.0 Core Function and Category names and identifiers** | Function | Category | Category Identifier || --- | --- | --- || **Govern (GV)** | Organizational Context | GV.OC || | Risk Management Strategy | GV.RM || | Roles, Responsibilities, and Authorities | GV.RR || | Policy | GV.PO || | Oversight | GV.OV || | Cybersecurity Supply Chain Risk Management | GV.SC || **Identify (ID)** | Asset Management | ID.AM || | Risk Assessment | ID.RA || | Improvement | ID.IM || **Protect (PR)** | Identity Management, Authentication, and Access Control | PR.AA || | Awareness and Training | PR.AT || | Data Security | PR.DS || | Platform Security | PR.PS || | Technology Infrastructure Resilience | PR.IR || **Detect (DE)** | Continuous Monitoring | DE.CM || | Adverse Event Analysis | DE.AE | 使用场景
PDF 转 Markdown 的真实工作流
研究笔记
把论文提取成可编辑的笔记,核对引用段落,并保留 PDF 引用以备后续复核。
报告摄取
为切分准备报告,同时保留表头、章节上下文和指向原始文档的链接。
政策库
把复核过的政策转成可搜索文本,并把已发布的 PDF 保留为权威版本。
文档评估
在自动化整个集合前比较有代表性的 PDF,包括扫描件、分栏和一张棘手的表格。
API
PDF 转 Markdown API
用 POST /v1/convert/pdf,带上 x-api-key 请求头和受支持的源文件。已完成的请求可以内联返回输出;HTTP 202 表示转换仍在进行。读取 Location 响应头并在访问文件输出前轮询它。一次 multipart 请求最多接受 100 个文件;订阅额度和总请求限额同样适用。把 API 密钥放在你的服务器环境里。API 访问需要 Lite、Pro 或 Max 订阅。
阅读 API 指南curl -i "https://api.markitdown.ai/v1/convert/pdf" \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F "file=@source.pdf"# If HTTP 202, GET the Location URL with the same API key.指南
检查输出结果
在把 PDF 转 Markdown 的输出当作依据之前,先拿它和原始 PDF 对照。从一页同时包含分栏、脚注和表格的页面开始,而不是简单的标题页。读一栏的最后一句和下一栏的第一句:它们应当连成人在 PDF 里读到的同一顺序。再对照一个表头、一个负值和一个单位。一份可读的 Markdown 预览仍可能包含 OCR 替换错误或错位的单元格。如果这份文档要支撑财务或技术决策,请把 PDF 与 Markdown 一并保留,并核对打算引用的段落。转换让文本更好处理,但它并不为来源或其转录背书。
有哪些变化
PDF 转 Markdown 用文本结构取代视觉定位。大标题可能变成标题标记,段落变成段落,受支持的表格变成用竖线分隔的行。页面几何、装饰线、字体选择和原始换行都不是输出的约定。当你想编辑摘录或构建检索索引时,这很有用;但当目标是精确复刻一本宣传册时,它并不合适。若要保留权威版式,请留存原始 PDF。当某个版式无法用简单的 Markdown 表格表达时,请考虑一段简短说明或人工核对过的表格是否是更清晰的呈现方式。
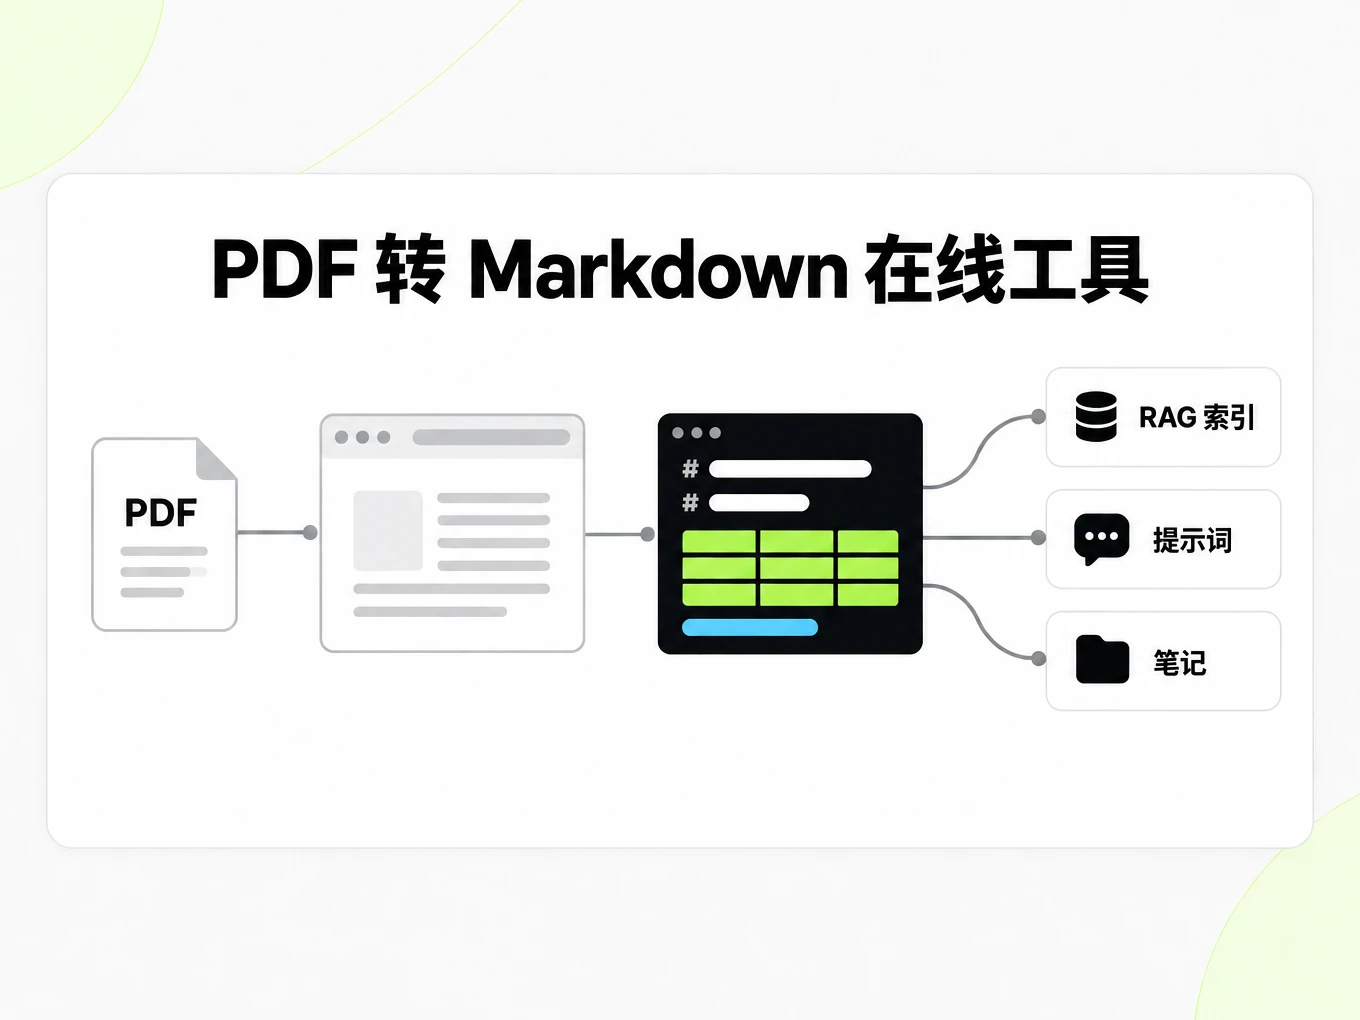
RAG 素材
把 Markdown 切分成段落时,用 PDF 标题和有意义的章节标题来保留上下文。一个只以 Results 为标题的分块在离开文档后可能有歧义;你的摄取代码可以把文档名和父级标题与该段落一起保留。让表头与它的行待在一起,也不要把一个列表从限定条件处截断。单独保存原始 PDF 的引用,这样检索到的答案能把读者带回来源。LangChain 和 LlamaIndex 可以消费你自己摄取流程产出的文本,但选择切分器、嵌入模型和检索策略仍是你应用本身的工作。用你已在 PDF 里核对过答案的问题来测试检索。
如何挑选 PDF
只要原始 PDF 导出含可读文本,就优先用它。对该 PDF 截图会引入额外的图像识别步骤,可能在转换开始前就丢失小字符。对扫描版 PDF,先把旋转的页面摆正,并使用在正常缩放下标点和表格边框仍清晰可辨的版本。上传加密 PDF 前先移除密码。如果长报告里只有一部分相关,就准备相关的源页,并在笔记里保留它们的原始引用。反复重试同一份损坏的扫描件不太可能补回缺失的细节;先改善来源,再把新的 PDF 转 Markdown 输出与此前的结果对照。
分块边界
检索质量取决于与人类阅读的文档相匹配的分块边界。这款转换器会重排分栏并保留标题层级,好让切分器产出一个个段落,而不是双栏论文里交错的碎片。
- 把 Markdown 当作你切分和嵌入的产物,而不是一坨拍平的文本。
- 在有账号的套餐里,标准页和 OCR 页按每页 1 credit 计费。
- 受密码保护的文件必须先解锁再上传;加密 PDF 会被拒绝。
更多 Markdown 转换器
- Word → Markdown保留标题与列表的 DOCX
- PPT → Markdown幻灯片文字、备注与表格
- Excel → Markdown每个工作表一张表
- Image → Markdown扫描件与截图的 OCR
- HTML → Markdown粘贴或上传 HTML
- URL → Markdown任意公开网页,清洗后输出
- Markdown → HTML干净、语义化的 HTML
- Markdown → Text去掉标记的纯文本
- Markdown → PDF本地打印为 PDF
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
PDF 转 Markdown 常见问题
PDF 转 Markdown 是怎么工作的?
PDF 转 Markdown 把受支持的来源转换成可读的 Markdown,便于复核和复用。匿名试用接受每个文件最大 10 MB、25 页,每个 IP 每小时 3 次转换、每天 10 次。使用前请把结果与来源对照。
PDF 最大能有多大?
公开转换器接受最大 10 MB 的 PDF 文件。Lite 支持最大 100 MB 的文件;Pro 和 Max 有更高的上限。
它处理扫描版 PDF 吗?
处理。基于图片的 PDF 目前用 OCR 识别;干净、高分辨率的扫描件效果最好。
多栏研究论文能处理吗?
能。PDF 转 Markdown 会尝试重建阅读顺序。请把分栏处与来源对照,因为复杂版式仍可能需要人工修正。
财务表格能保留下来吗?
带有结构元数据的 PDF 表格会转换成 Markdown 表格。拍平成图片的表格需要 OCR 来恢复。
可以转换受密码保护的 PDF 吗?
不可以。加密 PDF 无法解析。请在上传前移除密码。
输出质量足以切分后用于 RAG 吗?
Markdown 会在可能的情况下保留标题、列表和表格,因此与复制粘贴相比,切分和嵌入更可预测。
可以从代码里转换 PDF 吗?
可以。用 API 密钥把文件 POST 到 /v1/convert/pdf,再从响应里读回 Markdown。见 /developers。