
转换器
URL 转 Markdown 转换器
URL 转 Markdown 是一款免费转换器,把公开可访问的网页变成干净的正文 Markdown——文章、文档页或帖子本身,不含站点导航——可直接用于 LLM、RAG 流程和笔记。试用无需注册;试用允许每个 IP 每小时 3 次转换、每天 10 次。
如何操作
如何把网页转成 Markdown
可以粘贴什么
- 任意公开的 http(s) 页面 —— 文章、文档、博客文章
- 需要登录或位于付费墙后的页面无法抓取
- 页面在我们的服务器上抓取,不会执行其 JavaScript
- 无需账号即可试用:单文件最大 10 MB、25 页,每小时 3 次、每天 10 次转换
需要检查什么
- 服务端抓取 —— 页面在服务端被抓取,会先请求 Markdown、再请求 HTML;只有站点自己的 Markdown 通过质量检查时才会使用它。无需浏览器插件或本地工具。
- 正文提取 —— 多种提取方式——可读性评分、样板内容检测、文本密度分析,以及页面自身的 main 或 article 元素——会相互竞争,保留结构和正文最多的一种胜出。文档生成器、GitHub、Wikipedia 等知名站点则使用站点专属规则。
- JavaScript 渲染的页面 —— 空的应用外壳会先在无头浏览器里渲染,浏览器等待页面稳定后,把渲染出的 DOM 交给同一套提取流程处理。只有点击或滚动后才出现的内容不会被捕获。
- 公开页面、大小与身份 —— 只支持公开可访问的 URL:位于身份验证、付费墙或登录墙之后的页面无法抓取。抓取的页面受响应大小限制约束,抓取器的 user agent 记录在 /docs/fetcher。
Markdown 的去向
- 直接从预览中复制 Markdown
- 下载 .md 文件;登录后会保存到你的资料库
- 在 POST /v1/convert/url 上用 urls 数组一次转换多个页面
- 用 POST /v1/convert/url 和你的 API key 自动完成
为什么使用
为什么使用这款 URL 转 Markdown 转换器
网页是写给浏览器看的。Markdown 是写给人看、给模型读的。这款转换器会找出页面里承载含义的部分,保留其结构,把站点的边角装饰留在外面。
只留正文,不留整页
多个提取器会分别读取页面,保留文章内容最多的结果胜出,因此菜单、Cookie 提示条、页脚和相关文章栏都不会出现在 Markdown 里。
能留存下来的结构
标题、列表、表格和代码块都以 Markdown 形式呈现,页面里每个相对链接和图片路径都会被改写成完整 URL,离开原页面也能使用。
JavaScript 页面也能渲染
当初始 HTML 只是一个空的应用外壳时,页面会先在无头浏览器里渲染,再转换渲染后的内容。
免费试用,无需登录
无需账号即可预览并复制 Markdown,每小时最多 3 次转换、每天 10 次。登录后可下载 .md 文件。
有礼、表明身份的抓取器
每次请求都会用有文档记录的 user agent 表明身份,站点所有者可以屏蔽它——见文档里的抓取器页面。
与 API 同一套引擎
本页的转换器和 POST /v1/convert/url 运行同一份代码,所以脚本每次调用最多可转换 20 个 URL。
问题所在
为什么在线页面对模型来说很嘈杂
页面很嘈杂
在线网页把内容埋在导航、广告、横幅和脚本之下——这些文字的总量往往是文章本身的好几倍。
标记很乱
手写和生成的 HTML 很少能干净地映射为可读结构。
AI 需要的是文章
RAG 和 agent 想要的是文章本身,而不是它周围的页面外壳——而有些页面只有在 JavaScript 运行之后才会显示文章。
保留什么
这款 URL 转换器抓取什么
- 服务端抓取
- 页面在服务端被抓取,会先请求 Markdown、再请求 HTML;只有站点自己的 Markdown 通过质量检查时才会使用它。无需浏览器插件或本地工具。Source: RFC 9110: HTTP Semantics
- 正文提取
- 多种提取方式——可读性评分、样板内容检测、文本密度分析,以及页面自身的 main 或 article 元素——会相互竞争,保留结构和正文最多的一种胜出。文档生成器、GitHub、Wikipedia 等知名站点则使用站点专属规则。Source: HTML Living Standard: the main element
- JavaScript 渲染的页面
- 空的应用外壳会先在无头浏览器里渲染,浏览器等待页面稳定后,把渲染出的 DOM 交给同一套提取流程处理。只有点击或滚动后才出现的内容不会被捕获。Source: HTML Living Standard
- 公开页面、大小与身份
- 只支持公开可访问的 URL:位于身份验证、付费墙或登录墙之后的页面无法抓取。抓取的页面受响应大小限制约束,抓取器的 user agent 记录在 /docs/fetcher。Source: product pipeline
示例:通过 URL 抓取 markitdown.ai 博客文章· https://markitdown.ai/blog/why-pdfs-break-llms
# Why PDFs break LLMs — and what clean Markdown fixes _Published 2026-06-12 · The markitdown.ai team_ > A PDF that looks perfect to a human often falls apart the moment a model reads it. Here's what goes wrong, and why converting to clean Markdown first makes downstream AI far more reliable. A PDF renders perfectly for a human and falls apart the moment a model reads it. The page you see — columns, tables, headers, footnotes — is a *visual* arrangement, not a logical one. When you pull raw text out of it, that visual order rarely survives, and whatever you feed a language model is only as good as the text it actually receives. ## What actually goes wrong When teams pipe documents straight into an LLM or a retrieval index, a few failure modes show up again and again: - **Reading order breaks.** Multi-column layouts interleave. A two-column page becomes "line 1 left, line 1 right, line 2 left, line 2 right…", so a sentence a human reads top-to-bottom arrives at the model scrambled.- **Tables collapse.** Copy-paste turns a table into a loose run of numbers. The relationship between a header and its cell — the entire point of a table — is gone.- **Headings disappear.** The visual hierarchy (this is a section, this is a subsection) is encoded as font size and weight, not structure. Strip the styling and you get one undifferentiated wall of text. 使用场景
网页转 Markdown 的使用场景
从 AI agent 到内容迁移,把网页转换成 Markdown 是许多工作流都依赖的一小步。
AI 与 LLM 流程
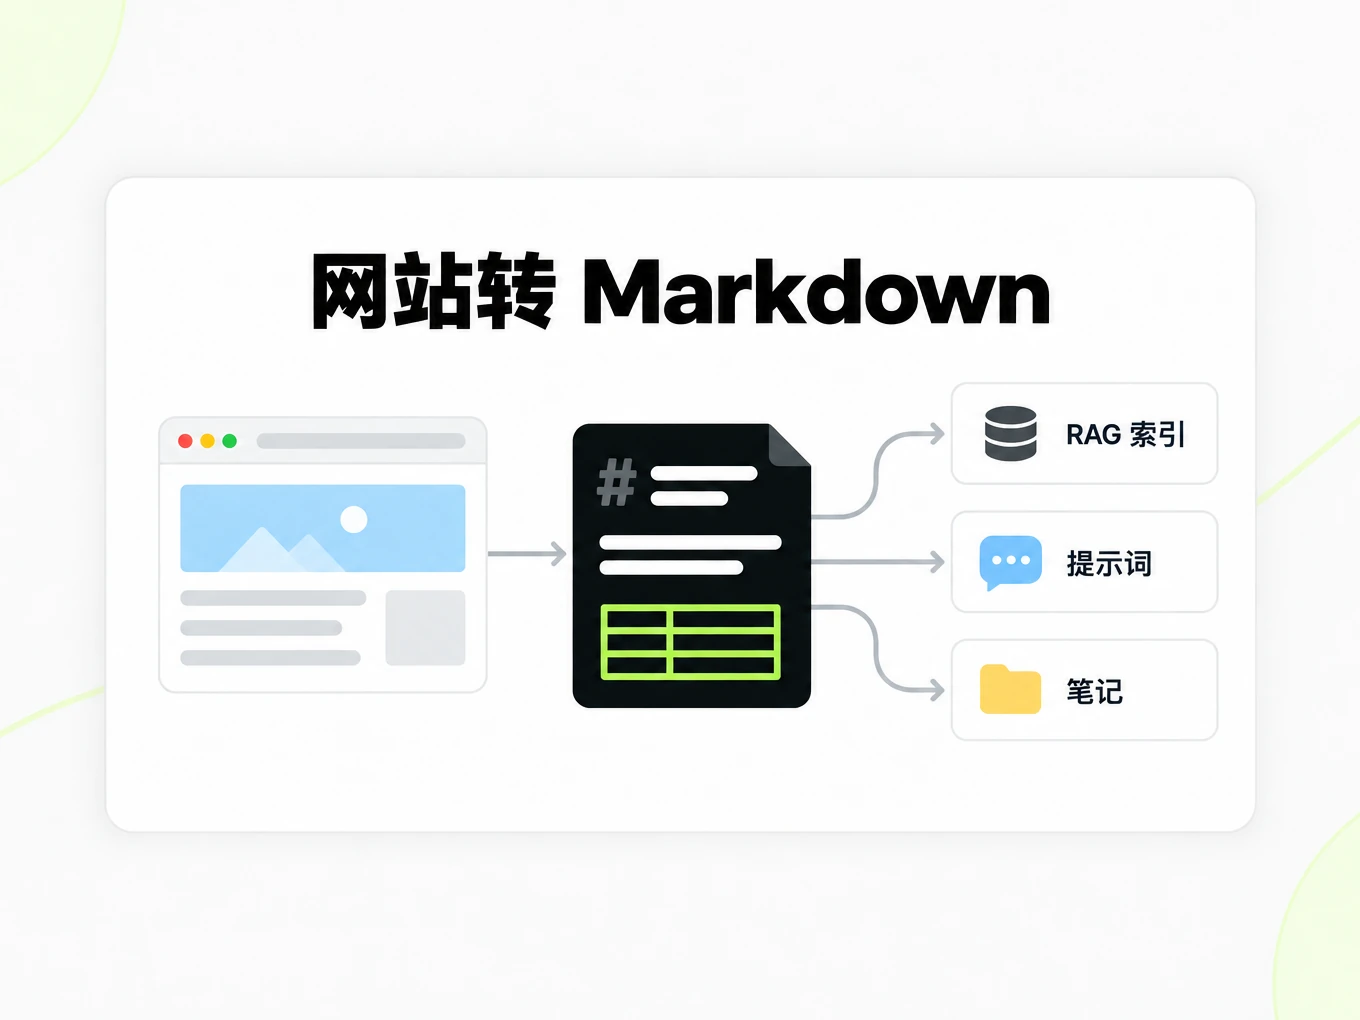
把文章和文档作为带完整标题的干净文本喂给 RAG 索引、agent 工具和提示词,而不是原始 HTML。
研究与笔记
把来源保存为 Markdown,用于引用、批注或留在 Obsidian 或笔记仓库里——原始链接依然在位。
内容团队
把文章和帮助中心页面从一个 CMS 迁到另一个,或把参考资料拉进基于 Markdown 的文档站。
开发者
在你已有的摄取任务和爬虫里调用 API,拿到与浏览器转换器显示的同一份 Markdown。
API
面向开发者的 URL 转 Markdown API
要从代码转换页面?把一个 URL——或 urls 数组里最多 20 个——发到带 API 密钥的 POST /v1/convert/url。把 render 设为 auto、force 或 skip 可以控制是否渲染 JavaScript,把 frontmatter 设为 true 可以把页面标题、作者和发布日期放进 YAML front matter。页面在等待窗口内完成时,Markdown 会在同一个响应里返回;否则你会拿到一个可轮询的转换,或它尘埃落定时的一个 webhook。API 访问在付费套餐上提供。
阅读 API 指南curl -X POST https://api.markitdown.ai/v1/convert/url \ -H "x-api-key: mdai_…" \ -H "content-type: application/json" \ -d '{"url":"https://markitdown.ai/blog/why-pdfs-break-llms","frontmatter":true}'指南
检查输出结果
把 URL 转 Markdown 的输出与你提交的公开页面对照。转换器会保留正文,去掉导航、Cookie 提示和页脚链接,但对没有明确文章结构的页面——产品页、落地页、带很多推荐位的首页——仍可能丢掉一个侧栏,或保留一段你并不想引用的内容。在为结果建索引之前,先核对开头和结尾段落与原页面是否一致。用 JavaScript 构建内容的页面会先在浏览器里渲染;只有点击、滚动或登录后才加载的文字仍然无法捕获。如果某个站点已经为请求 Markdown 的客户端提供了自己的 Markdown,转换器会在它通过质量检查时直接使用;如果它看起来像整站菜单或归档转储,则会回退到 HTML 页面。把来源 URL 与 Markdown 一起保留,让读者能回到原始页面。
保留来源上下文
在你自己的工作流里,把提交的 URL 和你的检索日期与 URL 转 Markdown 的结果一起保留。公开页面在你转换之后可能改动,后来的访客可能看到修改过的段落。开启 front matter 后,结果开头会带上来源 URL、canonical URL、标题,以及页面声明了的作者、发布日期、描述、站点名称、语言和主图——这些都读自页面的 meta 标签、结构化数据和署名信息。这些字段只是复述页面自己声明的内容;如果你的研究依赖它们,请在来源处核对。API 的 metadata 字段则不同:它只携带你自己提供的上下文。在引用一张表或一段话之前,先与页面对照,并保留足够的周边上下文以免改变含义。Markdown 让网页内容更易复用;它并不确立该页面是否准确,也不确立你是否有权转载它。
保存的 HTML 与 URL
当你已经拥有需要处理的确切页面快照时,选择 HTML 转换器。当公开可访问的地址就是本次转换的输入时,选择 URL 转 Markdown。这是两种相关但来源控制不同的工作流:保存的文件固定了你提交的输入,并会被完整转换;而 URL 取决于网站在请求时返回什么,并会被压缩为正文内容。两条路径都不会绕过访问限制。如果某个站点拒绝抓取器或要求登录,请使用你有授权通过合适工作流获取的材料。不要反复重试一个无法访问的 URL,仿佛再转换一次就能获得访问权限。
LLM 研究
研究者粘贴的是一个来源,而不是一个文件。这个转换器抓取你提交的 URL,保留文章或文档正文,并返回你可以引用、切分或放进笔记库的 Markdown,其中的链接依然可以打开。当服务器返回一个空外壳时,它会渲染 JavaScript 页面;它不会登录付费墙。
- 只支持公开可访问的 URL。
- 抓取器会表明自身身份;运营方可以拒绝该 user agent——见 /docs/fetcher。
- 保存的 HTML 文件属于 /html-to-markdown,不属于这里。
更多 Markdown 转换器
- PDF → Markdown正文、表格与扫描件
- Word → Markdown保留标题与列表的 DOCX
- PPT → Markdown幻灯片文字、备注与表格
- Excel → Markdown每个工作表一张表
- EPUB → Markdown电子书章节转为标题
- Image → Markdown扫描件与截图的 OCR
- HTML → Markdown粘贴或上传 HTML
- Markdown → HTML干净、语义化的 HTML
- Markdown → Text去掉标记的纯文本
- Markdown → PDF本地打印为 PDF
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
URL 转 Markdown 常见问题
URL 转 Markdown 是怎么工作的?
URL 转 Markdown 会抓取你粘贴的公开页面,保留其正文内容,并转换成带完整 URL 链接的 Markdown——无需上传文件。需要 JavaScript 的页面会先在浏览器里渲染。
它会从在线页面里去掉广告和导航吗?
对有明确正文区域的页面可以。URL 转 Markdown 会保留文章、文档正文或帖子内容,去掉菜单、Cookie 提示条和页脚;没有单一正文区块的落地页或产品页仍可能保留或丢失某个侧栏,请检查结果。
抓取的页面有大小限制吗?
公开转换器对公开网页生效。抓取的页面受响应大小限制约束,过大时会被拒绝。
对登录后的页面有效吗?
无效。只支持公开可访问的 URL。位于身份验证、付费墙或登录墙之后的页面无法抓取。
依赖 JavaScript 渲染的页面呢?
当初始 HTML 只是一个空外壳时,JavaScript 渲染的页面会先在无头浏览器里渲染,然后像其它页面一样转换。通过 API,把 render 设为 force 会始终渲染,设为 skip 则从不渲染。只有点击、滚动或登录后才出现的文字不会被捕获。
可以一次转换多个 URL 吗?
把最多 20 个公开 URL 的 urls 数组发到 POST /v1/convert/url。逐个跟踪文件结果并处理异步响应。见 /developers。
URL 转 Markdown 免费吗?
免费。无需账号即可预览并复制 Markdown,每小时最多 3 次转换、每天 10 次;下载 .md 文件需要登录。仅限公开网页(不支持内网或私有 URL)。
转换器保留哪些内容?
转换器会保留正文中的标题、段落、列表、链接、图片、表格和代码块,相对链接会被改写成完整 URL。脚本、样式、导航和页脚会被丢弃;开启 front matter 后,页面标题、作者和发布日期会放在开头。
有 URL 转换 API 吗?
有。可以通过 REST API 以 URL 编程转换网页。见 /developers。保存的 HTML 文件请改用 /html-to-markdown。