
批量转换
批量转换为 Markdown
批量转换为 Markdown 是付费套餐里的批量模式,接受许多文件、文件夹或 ZIP 压缩包,在后台转换,并把每一个结果收集到一处。
为什么用批量转换为 Markdown
「转换为 Markdown」一次处理一份文件。当转换文档变成一项反复出现的工作时,就该用批量转换。
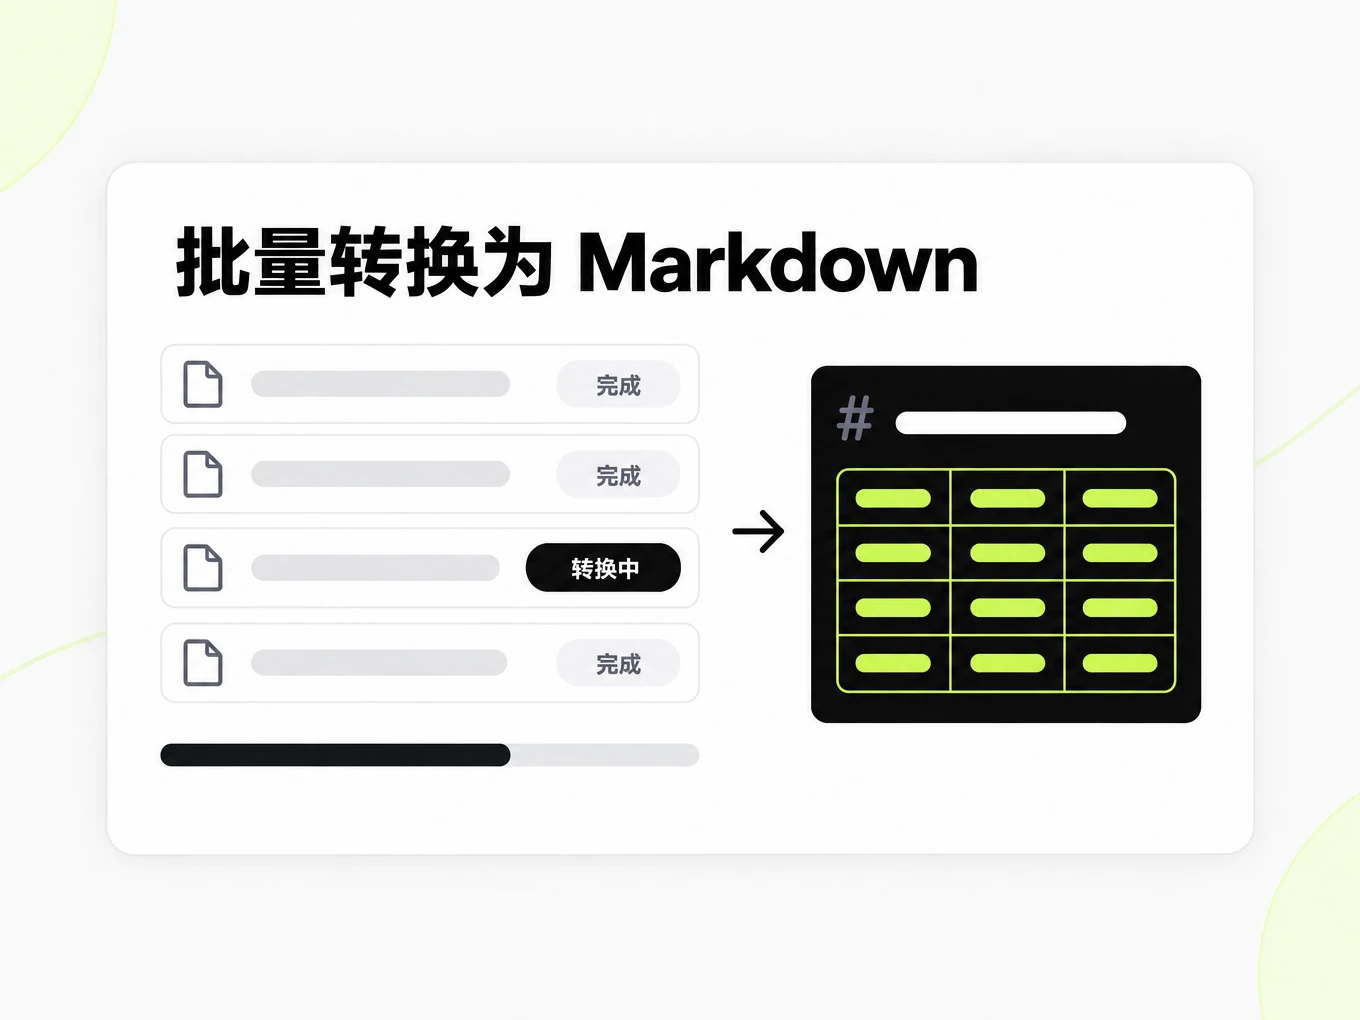
不再手动循环
一次性加入一堆文件、一个文件夹或一个 ZIP 压缩包,而不是一份一份地反复上传和下载。
在后台运行
转换在服务端处理,所以你可以关掉标签页,稍后再回来取结果。
结果集中在一处
每一份输出都落进你的资料库,并与它的源文件配对。
成本可预期
能看到一批用了多少 credit,文件越重,用量越清楚。
批量转换如何运行
加入你的文件
选择许多文档、一个文件夹或一个 ZIP 压缩包;开始前会显示预计的 credit。
这一批开始运行
文件在后台经过与「转换为 Markdown」相同的转换引擎处理。
跟踪进度
看着每份文件从排队中走到进行中、再走到已完成——或把失败的挑出来。
下载或保存
把 Markdown 输出收集起来,或留在资料库里以便之后复用。
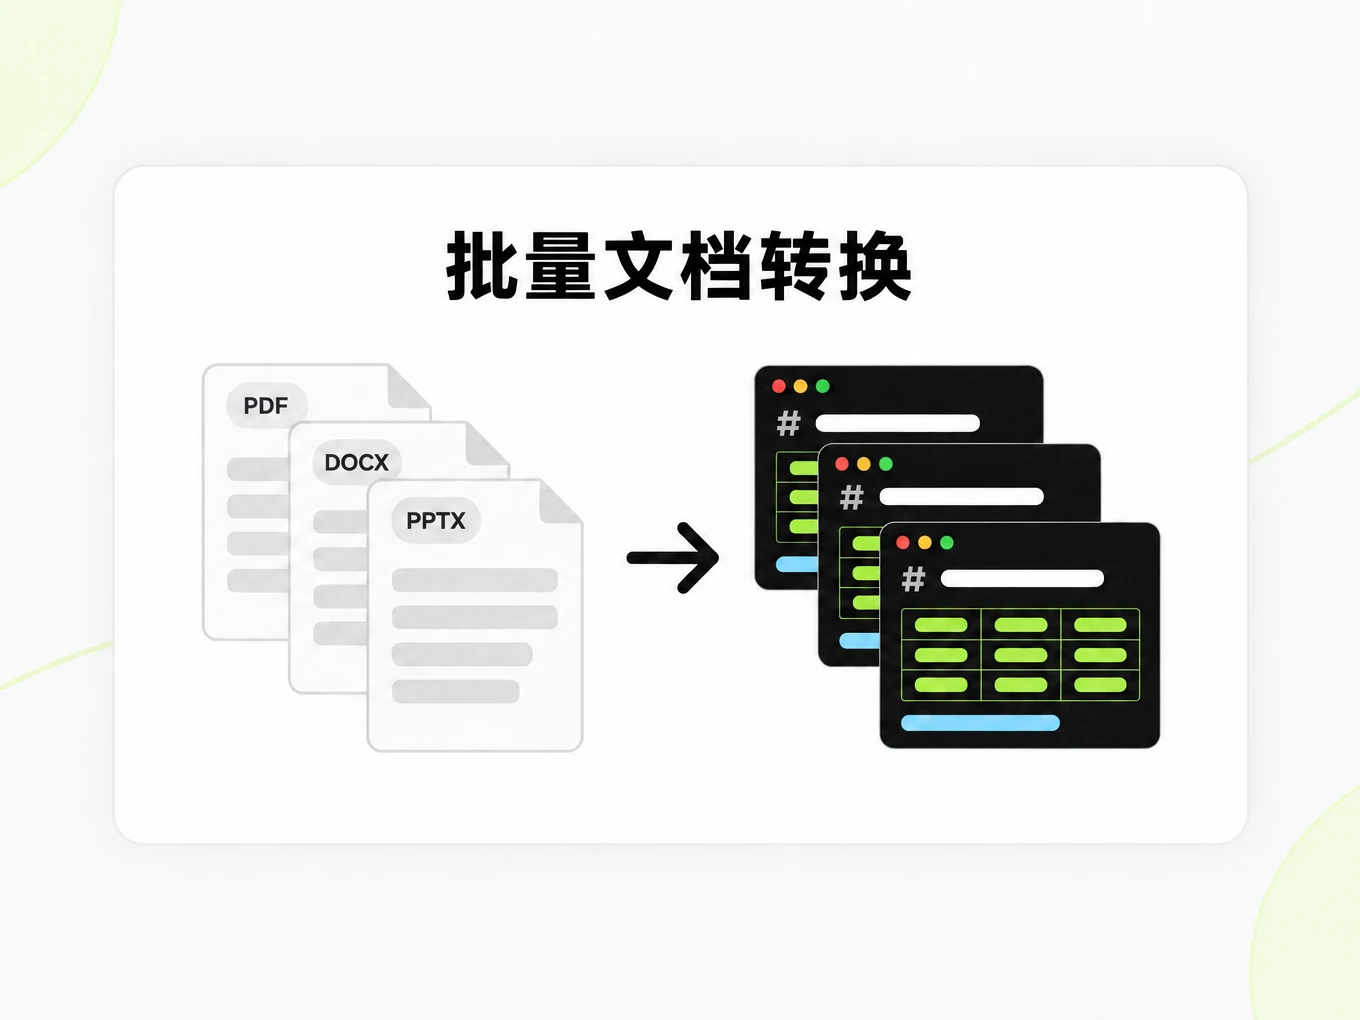
内置的进度跟踪
只有当你能看清发生了什么,一批转换才有用。每一次运行都留下一份可以随时回看的记录。
批量历史
回看过去的批次,不用把同样的文件再跑一遍。
逐文件状态
每份文件各自报告排队中、进行中、已完成或失败。
重试失败的条目
一份坏文件不会拖垮整批——单独处理它就好。
credit 与用量
看看每一批消耗了多少,以及限额什么时候重置。
指南
准备文件
在批量转换为 Markdown 之前,先把这批文件整理好,让每一份输出都能和它的来源对上。用有意义的文件名,把同一文档的不同修订版分开。先打开每类输入里的一份代表性文件,检查一次样本转换,再放进整批。一组扫描版 PDF 的复核需求,和一组可编辑的 Word 文档并不相同,即便两者都会变成 Markdown。确认加密文档已解锁、源文件可读。批量流程减少的是反复提交的功夫;它并不能代替你搞清楚自己在提交什么,也不能代替你辨认一份结果是由哪个版本文档产生的。
已完成的批次
一批完成,只说明处理走到了某个结局,并不说明每份来源都成功转换、或它的文本已经可以发布。逐文件查看状态,把失败的条目和成功的输出分开。一整套跑完时,可能是可用结果和需要处理的文件混在一起。除了失败清单,也要抽查有代表性的输出,尤其当你的素材质量参差不齐时。在把这一批当作检索语料或发布档案之前,先在自己的流程里记录你核对过哪些文档。把处理状态、输出质量和编辑审批当成三件独立的事实,才不会把一次成功的请求误当成一份已复核的文档。
失败的文件
重试之前先调查失败的那份文件。损坏的来源、不支持的输入或受密码保护的文档,需要先改来源;原样再提交一次,可能还是同样的结果。临时的服务或限流错误,则需要另一种应对。保留转换标识和屏幕上可见的错误细节,好让这次重试能对上最初那次尝试。只重试那些确实需要再试的条目,之后再看看它们的新状态。不要仅仅因为一个文件失败,就重跑整批。这样能让复核更聚焦,也更容易说清楚哪些输出来自最初那一批、哪些是在修正之后才产生的。
批量限额
一批既要落在订阅的额度里,也要符合提交方式。一次 multipart API 请求最多包含 100 个文件,但整个请求上限为 100 MB。URL 提交每次最多接受 20 个 URL。这些传输限额并不能替代 Lite、Pro 或 Max 的单文件、页数、存储和 credit 限额。超过一次性请求上限的文件,即便套餐允许该文件大小,也需要走文档里说明的上传流程。计划的并发量决定同时跑多少工作,但它并不承诺一批里的每个文件都会立刻开始。
构建知识库
让每一份 Markdown 输出都和它的源文档、以及它被收集时的上下文保持关联。一个叫 report.md 的文件,进入检索索引后很难和另一份报告区分开。你的下游流程可以把文档标题、来源引用和修订信息与文本一起留存。在把表格密集、扫描版或格外长的文档切分成检索段落之前,先复核它们。如果一批里含有重复页眉或网页导航,就在摄取流程里决定怎么清理这些元素,而不是假设转换已经把它们去掉了。一套有用的语料,是每一段都能被追溯和验证;而不只是一个装了很多 Markdown 文件的文件夹。
转向 API
当由人来整理一批文件、并想在网页应用里查看进度和结果时,用批量转换。当你自己系统里有反复运行的流程要提交输入并接收结果、不需要人工介入时,用文档转换 API。API 集成仍然需要为每个来源留记录、处理异步完成,并制定重试策略。先用一小批有代表性的文件测试这个流程,再跑更大的一批。网页和 API 共用同一个账号余额,所以要盯住合计用量。自动化提交应当让反复出现的工作更容易观察和恢复,而不是把失败藏在一个看起来成功的批量请求后面。
FAQ
常见问题
哪些套餐包含批量转换为 Markdown?
批量转换为 Markdown 在付费套餐中提供。公开的免费转换器一次只处理一份文件。当前套餐限额见定价页。
如果其中一个文件失败了会怎样?
每份文件各自独立跟踪。失败的文件会被标出,你可以只重试它,而不必重跑已经成功的文件。
可以批量转换哪些格式?
和「转换为 Markdown」相同的格式——PDF、Word、PowerPoint、Excel、图片、HTML 和文本——以文件、整个文件夹或 ZIP 压缩包的形式加入。批量转换使用同一个转换引擎。
结果去了哪里?
输出会连同它的源文件一起落进你的资料库,所以批次结束后你可以预览、下载或复用它们。
需要一直开着标签页吗?
不需要。批量转换在服务端运行,所以你可以离开,之后从批量历史里回来取结果。