
Convertisseur Markdown pour documents et pages web.
Un convertisseur Markdown pour les documents et les pages web publiques : PDF, Word, PowerPoint, Excel, images et HTML deviennent un texte que vous pouvez inspecter, réutiliser et transmettre à un flux de travail IA.
Essai anonyme · 10 MB · 3 conversions par heure · 10 par jour
Convertir en Markdown depuis
- DOCX
- PPTX
- XLSX
- PNG / JPG
- HTML
- URL
Comment ça marche
Convertisseur Markdown : comment ça marche
markitdown.ai est un convertisseur Markdown qui transforme les PDF, les fichiers Office, les images et les pages web en Markdown propre et prêt pour l'IA, pour ChatGPT, Claude, les pipelines RAG et les agents, via un essai anonyme ou un compte payant avec accès à l'API développeur.
What happens
Importez un fichier ou collez une URL. La conversion s'exécute sur nos serveurs, et non par un bricolage de copier-coller du navigateur : le même fichier produit donc le même Markdown, d'où qu'il vienne. Chaque page est traitée selon ce qu'elle contient, et les titres, les listes et les tableaux ressortent sous forme de véritable structure Markdown.
What you get
- Les pages avec couche de texte sont lues directement ; les numérisations et les images passent automatiquement par l'OCR
- Les téléchargements d'URL s'exécutent depuis nos serveurs, avec les adresses privées et internes bloquées
- Convertisseur public : jusqu'à 10 MB et 25 pages, sans connexion
- Les forfaits avec connexion relèvent ces deux limites, jusqu'à 200 MB et 200 pages avec Pro
What happens
Le visualiseur place le document source et le Markdown généré l'un à côté de l'autre, pour que vous vérifiiez les titres, les tableaux et l'ordre de lecture avant d'utiliser le résultat. Basculez entre l'aperçu rendu et le Markdown brut pour voir exactement ce que recevra un modèle ou un pipeline.
What you get
- La source et le Markdown s'affichent côte à côte dans le visualiseur
- Basculez le volet Markdown entre l'aperçu rendu et le code source brut
- Copiez le résultat gratuitement, sans compte
- Téléchargez le fichier .md une fois connecté
What happens
Les mêmes réglages qui ont fonctionné pour un fichier valent pour une pile de fichiers ou un appel de pipeline, et chaque résultat arrive dans votre bibliothèque. Batch suit chaque fichier avec son propre état et sa propre reprise, et l'API transmet le même Markdown directement à votre code.
What you get
- Le même moteur d'analyse pour l'application web, Batch (ZIP ou liste d'URL) et l'API
- POST /v1/convert/{name} renvoie le Markdown en un seul appel en 60 secondes, ou une conversion que vous interrogez ou recevez par webhook
- La bibliothèque conserve chaque exécution pendant la fenêtre d'historique de votre forfait : 30, 60 ou 90 jours
Crédits
La précision du Markdown, facturée à la page.
Une facture avec couche de texte et un bilan numérisé coûtent le même prix par page : le pipeline choisit pour vous l'extraction directe ou l'OCR. Les options IA pour les figures et les images sont facultatives et facturées séparément.
- par page, texte ou numérisation
- 1 crédit
- par page, texte ou numérisation
PDF avec couche de texte, fichiers Office et HTML
OCR pour pages numérisées, photos et captures d'écran
Graphiques et figures décrits dans les PDF · forfaits payants
Contenu de l'image décrit, pas seulement l'OCR · forfaits payants
API Markdown
Une API Markdown pour votre pipeline RAG.
- Le même pipeline d'analyse que l'application web
- Des milliers de fichiers par lots avec des webhooks à la fin
- Clés d'API à portée limitée et journal d'activité complet
- Le Markdown en un seul appel, ou une conversion à interroger quand un fichier demande plus de 60 secondes
curl -X POST https://api.markitdown.ai/v1/convert/word \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F file=@vendor-security-review-q3-2026.docx # If HTTP 202, GET the Location URL with the same API key.# Verified local parser output for vendor-security-review-q3-2026.docx:# ## Review Findings# # Risk ratings follow the standard High / Medium / Low scale defined in the vendor risk management policy.# # | Vendor | Risk Rating | Finding | Owner |# | --- | --- | --- | --- |# | CloudScan OCR | Medium | No documented data retention limit on uploaded scans | Security |# | PayBridge | Low | SOC 2 Type II renewed; no open items | Finance |# | LingoTrans API | High | Sub-processor list not disclosed on request | Legal |# | ArchiveNow Storage | Medium | Encryption at rest confirmed; key rotation overdue | Security |Tarifs
Une tarification simple pour la conversion en Markdown.
Le problème
Les documents ne sont pas prêts pour l'IA
La plupart des documents ont été conçus pour des personnes et des imprimantes, pas pour des modèles de langage. Avant qu'un fichier puisse être vectorisé, recherché ou utilisé par un raisonnement, il doit devenir un texte prévisible. C'est plus difficile qu'il n'y paraît, et c'est exactement là que l'extraction naïve échoue.
L'ordre de lecture se casse
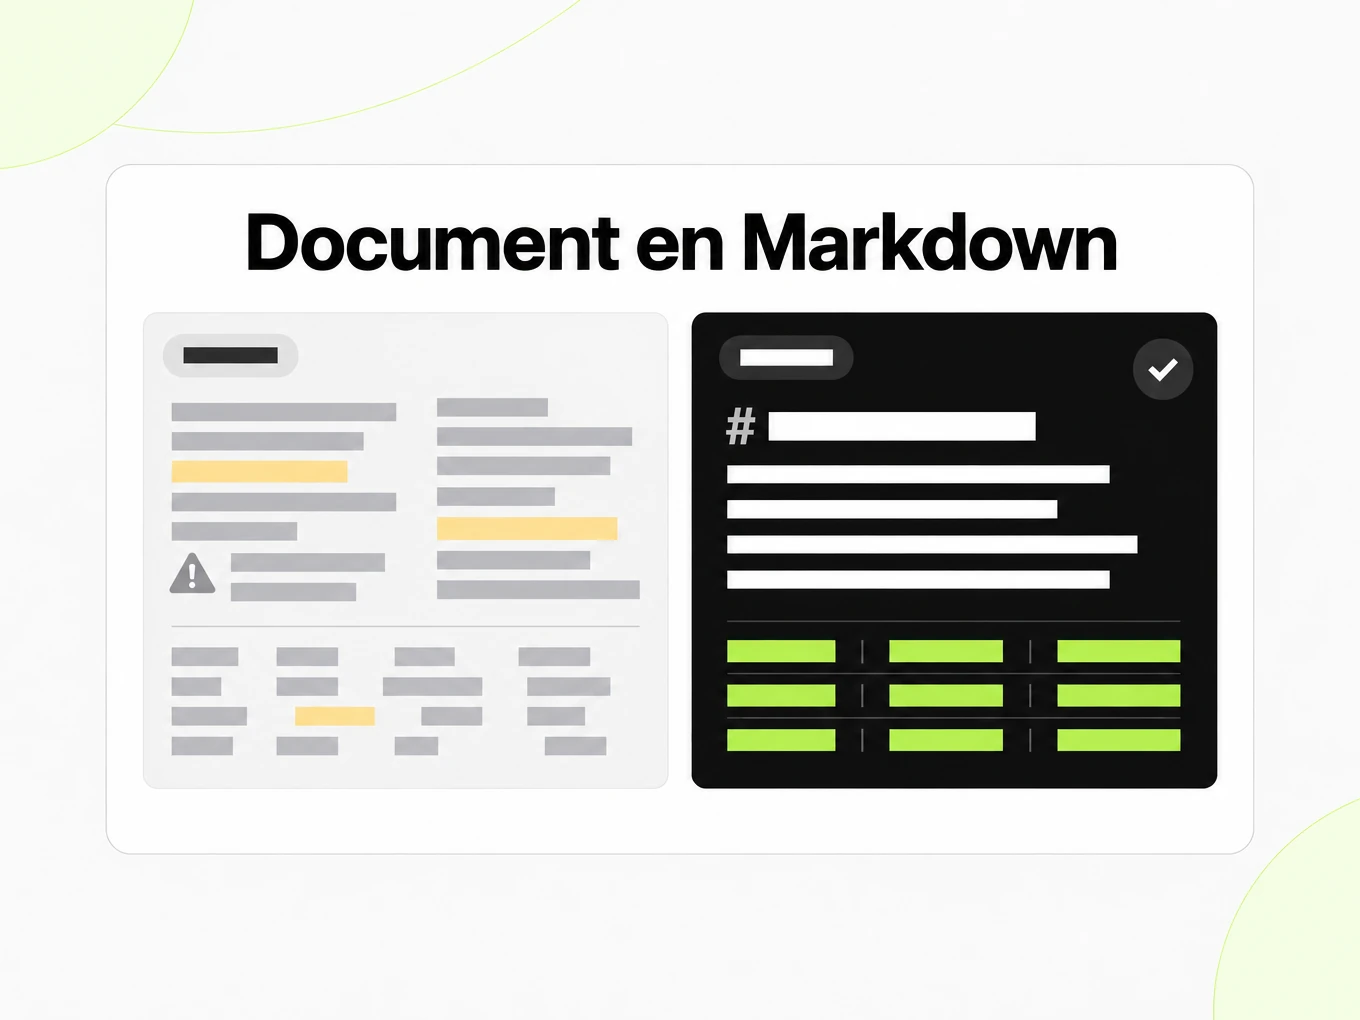
Les PDF à plusieurs colonnes, les en-têtes et les notes de bas de page s'entremêlent, et le texte que lit un LLM ne correspond plus au document que voit une personne.
Les tableaux et les titres s'aplatissent
Le copier-coller réduit les tableaux à des séries de nombres et supprime la hiérarchie de titres qui donne sa structure au document.
Les numérisations ont besoin de l'OCR
Les pages sous forme d'image et les contrats numérisés n'ont aucune couche de texte tant qu'ils ne passent pas par la reconnaissance optique de caractères.
Le texte brut est bruité
L'extraction bricolée laisse des numéros de page, des césures coupées et des caractères parasites qui polluent les prompts et les résultats de recherche.
Les pipelines RAG et les agents ont besoin d'une structure cohérente, pas seulement de caractères extraits. Un Markdown prévisible est ce qui fait que le découpage, la vectorisation et la recherche se comportent de la même manière sur des milliers de documents au lieu d'échouer en silence sur les plus désordonnés. C'est l'analyseur qui gère les fichiers difficiles qui rend les fichiers propres fiables.
Formats d'entrée
Convertir n'importe quel document en Markdown
Chaque format d'entrée a sa propre page de conversion avec les limites, les notes de format et un exemple de sortie. Toutes partagent un même moteur d'analyse, alors choisissez la page qui correspond à votre fichier :
- PDF en Markdown — rapports, articles, manuels et contrats. Les PDF à texte natif sont analysés directement et l'ordre de lecture multicolonne est reconstruit ; les PDF numérisés passent par l'OCR page par page.
- Word en Markdown — fichiers .docx et .doc hérités, avec les titres, les listes, les tableaux et les commentaires conservés, pour qu'une politique ou une spécification se lise comme un plan plutôt que comme un seul bloc.
- PPT en Markdown — présentations .pptx et .ppt diapositive par diapositive, avec les titres de diapositive en titres et les puces et tableaux conservés, ce qui rend une présentation de 40 diapositives consultable.
- Excel en Markdown — classeurs .xlsx et .xls où chaque feuille devient un tableau Markdown sous le nom de sa feuille.
- Image en Markdown — captures d'écran et numérisations PNG et JPG via l'OCR. La compréhension des images par IA est une option distincte, avec connexion.
- HTML en Markdown — pages enregistrées, exports et fragments, avec les scripts et les styles supprimés et la structure de l'article, les liens et les tableaux conservés.
- URL en Markdown — collez une adresse web publique et obtenez la page en Markdown, récupérée côté serveur avec une limite de taille et un délai d'expiration pour qu'un site lent ne bloque pas la requête.
Formats de sortie
Du Markdown vers n'importe quel format
Markdown est le format d'échange, donc la conversion fonctionne aussi dans l'autre sens. Les éditeurs Markdown ci-dessous s'affichent au fur et à mesure de votre saisie dans le navigateur et n'envoient jamais votre texte :
- Markdown en HTML — HTML sémantique et propre avec tableaux au format GitHub, listes de tâches et coloration syntaxique du code, prêt à coller dans un CMS ou un e-mail.
- Markdown en texte — texte brut avec titres, listes et tableaux aplatis de manière lisible pour les fenêtres de chat, les tickets et les formulaires.
- Markdown en PDF — un aperçu d'impression local ; utilisez Imprimer / Enregistrer au format PDF dans votre navigateur et vérifiez les pages enregistrées.
L'extraction de JSON structuré et la transcription audio et vidéo sont des couches prévues au-dessus de Markdown. Elles figurent comme feuille de route, pas comme fonctionnalités déjà disponibles.
Cas d'usage
Conçu pour toutes les équipes
Le convertisseur Markdown propose un essai anonyme pour vérifier un premier résultat. Ce qui fait revenir les équipes, c'est tout ce qui vient après le premier fichier : historique, lots, documents plus volumineux et une API qui intègre la conversion aux systèmes que vous utilisez déjà. Le même Markdown fonctionne que le consommateur soit une personne, un index de recherche ou un modèle.
RAG et pipelines IA
Convertissez les documents sources en Markdown propre avant le découpage, la vectorisation ou le traitement par des agents. Une structure prévisible fait que votre découpeur voit de vrais titres et tableaux au lieu d'un mur de texte extrait, ce qui garde la recherche pertinente et les prompts exempts de bruit de mise en page.
Recherche et rapports
Transformez articles, livres blancs et présentations en Markdown modifiable et consultable. Les chercheurs et les analystes peuvent citer, annoter, résumer et réutiliser leurs résultats sans retaper les tableaux ni perdre l'ordre de lecture d'un PDF dense.
Documents d'exploitation
Traitez politiques, contrats, factures et fichiers internes sans nettoyage manuel du copier-coller. Un historique Markdown conservé rend le travail documentaire récurrent plus facile à vérifier, à comparer et à réutiliser au quotidien dans une équipe.
Automatisation pour développeurs
Utilisez l'API pour convertir des fichiers dans des tâches d'ingestion, des outils internes et des flux documentaires. Envoyez une requête, recevez du Markdown et alimentez un CMS, une base de connaissances, un bot de support ou un pipeline d'agents avec une sortie fiable.
Bases de connaissances et support
Réunissez manuels produits, notes de version et wikis internes dans un seul corpus Markdown qu'un bot de support ou un assistant interne peut interroger. Comme les titres et les tableaux survivent, les réponses pointent vers la bonne section au lieu d'un bloc de la taille d'une page.
Agents et outils
Donnez à un agent un convertisseur Markdown pour les fichiers pris en charge et les URL publiques, et vérifiez la fin du traitement avant qu'il consomme le résultat. Lisez ce site de la même manière : chaque page publique répond à Accept: text/markdown par un jumeau Markdown, et llms.txt les liste tous.
Qualité de sortie
De la structure, pas seulement du texte
Un convertisseur Markdown utile conserve plus que des caractères isolés d'un PDF. L'objectif ici est un Markdown qui préserve la structure dont dépendent vos outils en aval, produite par un pipeline d'analyse côté serveur plutôt qu'un fragile copier-coller du navigateur.
- Conserve les titres, les listes, les tableaux, les liens et l'ordre de lecture là où la source les possède.
- Gère PDF, Word, PowerPoint, Excel, images, HTML et URL via un seul pipeline.
- Traite dès aujourd'hui les PDF numérisés et les images avec l'OCR ; la qualité de reconnaissance dépend de l'image source.
- Exécute les documents longs de façon asynchrone, pour que les gros rapports et présentations aboutissent au lieu d'expirer.
Les pages standard et les pages OCR coûtent 1 crédit par page ; les comptes avec forfait payant peuvent utiliser la compréhension des images par IA à 5 crédits par image. La sortie suit CommonMark avec des tableaux au format GitHub, donc elle s'affiche dans n'importe quel visualiseur Markdown et s'analyse avec n'importe quelle bibliothèque Markdown. Chaque conversion doit produire un artefact que vous pouvez inspecter, enregistrer et réutiliser : c'est la barre à atteindre.
Trois façons d'entrer
Navigateur, API ou agent
Le convertisseur Markdown de l'application web couvre la conversion manuelle ponctuelle et récurrente. Batch couvre les piles de fichiers. L'API couvre tout ce qui doit se produire automatiquement, y compris les agents qui l'appellent comme outil. Les trois partagent un compte, un solde de crédits et un moteur d'analyse. La plupart des équipes commencent dans le navigateur et passent à l'API une fois que la conversion fait partie d'un produit ou d'un flux interne.
| Aspect | Navigateur | Batch | API |
|---|---|---|---|
| Idéal pour | Un fichier à la fois | De nombreux fichiers en une exécution | Pipelines, outils et agents |
| Connexion | Inutile pour le premier fichier | Forfaits payants | Forfaits payants, clé d'API |
| Entrée | Import ou URL | Une liste d'imports ou d'identifiants de fichier | Import, URL, texte en ligne ou identifiant de fichier |
| Sortie | Aperçu, copie, téléchargement .md | Bibliothèque avec état par fichier | JSON avec Markdown, sortie par page, webhooks |
| Limites | 10 MB et 25 pages sans connexion | Concurrence du forfait | 20 à 60 requêtes par minute selon le forfait |
| Attente | Quelques secondes, dans la page | En arrière-plan | Synchrone jusqu'à 60 s, puis une conversion à interroger |
Application web
- Importez des fichiers ou collez des URL et prévisualisez le Markdown rendu
- Enregistrez l'historique des conversions et téléchargez les résultats .md
- Convertissez par lots le travail répétitif avec un état par fichier
- Suivez les crédits et l'usage par forfait
API développeur
- POST /v1/convert/{name} renvoie le Markdown en un seul appel, ou une conversion quand un fichier demande plus de 60 secondes
- Interrogez les conversions ou recevez des webhooks à leur aboutissement
- Envoyez Accept: text/markdown pour lire n'importe quelle page publique comme du Markdown
- Spécification lisible par machine à l'adresse /v1/openapi.json
FAQ
Questions que posent les équipes
Que fait un convertisseur Markdown ?
Un convertisseur de documents en Markdown est un outil qui lit un PDF, un fichier Word, PowerPoint, Excel, une image ou une page web et réécrit son contenu en Markdown : les titres deviennent des lignes #, les tableaux des tableaux à barres verticales et les listes restent des listes. Le but est d'obtenir un texte brut prévisible que les modèles de langage, les pipelines RAG et les agents peuvent découper, vectoriser et citer sans bruit de mise en page.
Le convertisseur gratuit est-il vraiment gratuit ?
Oui. Les pages du convertisseur public ne demandent ni compte ni carte. Les fichiers jusqu'à 10 MB et 25 pages sont convertis dans le navigateur, et vous pouvez prévisualiser et copier le Markdown. Les abonnements Lite, Pro et Max commencent à $20 par mois et ajoutent une bibliothèque enregistrée, les lots et l'API.
Comment fonctionnent les PDF numérisés et les images ?
Les pages uniquement composées d'images n'ont pas de couche de texte, donc le pipeline exécute l'OCR automatiquement et renvoie du Markdown comme pour du texte numérique. Les pages standard et les pages OCR coûtent 1 crédit par page. La qualité de reconnaissance dépend de l'image source : une numérisation à 300 dpi se lit bien mieux que la photo d'une page prise au téléphone.
Puis-je l'utiliser depuis du code ou depuis un agent ?
Oui. POST /v1/convert/{name} accepte un import, une URL ou du texte en ligne avec une clé d'API et renvoie le Markdown en un seul appel quand le fichier se termine en 60 secondes, ou une conversion que vous pouvez interroger ou recevoir par webhook. Les agents peuvent demander Accept: text/markdown sur n'importe quelle page publique, et la spécification lisible par machine se trouve à l'adresse /v1/openapi.json.
Que deviennent mes fichiers après la conversion ?
Supprimer une conversion la retire immédiatement de votre bibliothèque et efface ses fichiers stockés dans l'heure ; un fichier source partagé avec une autre conversion est conservé jusqu'à ce que celle-ci soit supprimée aussi. Supprimer votre compte efface tous vos fichiers sources et de résultat stockés. Les forfaits payants conservent l'historique pendant 30, 60 ou 90 jours selon le forfait.
Convertissez votre premier fichier en Markdown.
Essai gratuit — sans inscription.