
Convertisseur
Convertisseur URL en Markdown
Convertisseur URL en Markdown est un convertisseur gratuit qui transforme une page web d'accès public en Markdown propre de son contenu principal — l'article, la page de documentation ou le fil, sans la navigation du site — prêt pour les LLM, les pipelines RAG et vos notes. Aucun compte n'est nécessaire pour l'essayer ; l'essai permet 3 conversions par IP et par heure et 10 par jour.
Comment faire
Comment convertir une page web en Markdown
Ce que vous pouvez coller
- Toute page http(s) publique — articles, documentation, articles de blog
- Les pages derrière une connexion ou un paywall ne peuvent pas être récupérées
- La page est récupérée sur notre serveur, sans exécuter son JavaScript
- Essayez sans compte : jusqu'à 10 MB et 25 pages par fichier, 3 conversions par heure et 10 par jour
Ce qu'il faut vérifier
- Téléchargement côté serveur — La page est téléchargée côté serveur, en demandant d'abord le Markdown puis le HTML ; le Markdown propre d'un site n'est utilisé que s'il passe un contrôle de qualité.
- Extraction du contenu principal — Plusieurs extracteurs — score de lisibilité, détection de passe-partout, analyse de densité de texte et l'élément main ou article propre à la page — sont en concurrence, et celui qui conserve le plus de structure et de texte l'emporte.
- Pages rendues en JavaScript — Une coquille d'application vide est rendue dans un navigateur headless, qui attend que la page se stabilise puis transmet le DOM rendu à la même extraction.
- Pages publiques, taille et identité — Seules les URL d'accès public sont prises en charge : les pages derrière une authentification, un paywall ou un écran de connexion ne peuvent pas être téléchargées.
Où va le Markdown
- Copiez le Markdown directement depuis l'aperçu
- Téléchargez le fichier .md et conservez-le dans votre bibliothèque une fois connecté
- Convertissez plusieurs pages à la fois avec un tableau urls sur POST /v1/convert/url
- Automatisez-le avec POST /v1/convert/url et votre clé d'API
Pourquoi l'utiliser
Pourquoi utiliser ce convertisseur URL en Markdown
Une page web est écrite pour un navigateur. Le Markdown est écrit pour les personnes et les modèles. Ce convertisseur trouve la partie de la page qui porte le sens, en conserve la structure et laisse de côté les éléments de décor du site.
Le contenu principal, pas toute la page
Plusieurs extracteurs lisent la page, et le résultat qui conserve le plus de l'article l'emporte, si bien que les menus, les bandeaux de cookies, les pieds de page et les carrousels d'articles liés restent hors du Markdown.
Une structure qui dure
Les titres, les listes, les tableaux et les blocs de code arrivent en Markdown, et chaque lien ou chemin d'image relatif est réécrit en URL complète qui continue de fonctionner hors de la page.
Les pages en JavaScript sont aussi rendues
Quand le HTML initial est une coquille d'application vide, la page est rendue dans un navigateur headless et c'est ce contenu rendu qui est converti.
Gratuit à l'essai, sans connexion
Prévisualisez et copiez le Markdown sans compte, jusqu'à 3 conversions par heure et 10 par jour. Connectez-vous pour télécharger le fichier .md.
Un récupérateur poli et identifié
Chaque requête s'identifie par un user agent documenté, et les propriétaires de sites peuvent le bloquer : consultez la page du récupérateur dans la documentation.
Le même moteur que l'API
Le convertisseur de cette page et POST /v1/convert/url exécutent le même code, donc un script peut convertir jusqu'à 20 URL par appel.
Le problème
Pourquoi une page active est bruyante pour les modèles
Les pages sont bruyantes
Les pages web actives enterrent le contenu sous la navigation, les publicités, les bandeaux et les scripts — souvent plusieurs fois plus de texte que l'article lui-même.
Le balisage est désordonné
Le HTML écrit à la main et le HTML généré correspondent rarement de façon propre à une structure lisible.
L'IA veut l'article
Le RAG et les agents veulent l'article, pas les éléments d'interface qui l'entourent, et certaines pages n'affichent l'article qu'après l'exécution du JavaScript.
Ce qui est conservé
Ce que ce convertisseur URL télécharge
- Téléchargement côté serveur
- La page est téléchargée côté serveur, en demandant d'abord le Markdown puis le HTML ; le Markdown propre d'un site n'est utilisé que s'il passe un contrôle de qualité. Aucun plugin de navigateur ni outil local n'est nécessaire.Source: RFC 9110: HTTP Semantics
- Extraction du contenu principal
- Plusieurs extracteurs — score de lisibilité, détection de passe-partout, analyse de densité de texte et l'élément main ou article propre à la page — sont en concurrence, et celui qui conserve le plus de structure et de texte l'emporte. Les sites connus, comme les générateurs de documentation, GitHub et Wikipédia, utilisent des règles propres au site.Source: HTML Living Standard: the main element
- Pages rendues en JavaScript
- Une coquille d'application vide est rendue dans un navigateur headless, qui attend que la page se stabilise puis transmet le DOM rendu à la même extraction. Le contenu qui n'apparaît qu'après un clic ou un défilement n'est pas capturé.Source: HTML Living Standard
- Pages publiques, taille et identité
- Seules les URL d'accès public sont prises en charge : les pages derrière une authentification, un paywall ou un écran de connexion ne peuvent pas être téléchargées. Les pages téléchargées sont soumises à des limites de taille de réponse, et le user agent du récupérateur est documenté sur /docs/fetcher.Source: product pipeline
Exemple : article de blog markitdown.ai via un téléchargement par URL· https://markitdown.ai/blog/why-pdfs-break-llms
# Why PDFs break LLMs — and what clean Markdown fixes _Published 2026-06-12 · The markitdown.ai team_ > A PDF that looks perfect to a human often falls apart the moment a model reads it. Here's what goes wrong, and why converting to clean Markdown first makes downstream AI far more reliable. A PDF renders perfectly for a human and falls apart the moment a model reads it. The page you see — columns, tables, headers, footnotes — is a *visual* arrangement, not a logical one. When you pull raw text out of it, that visual order rarely survives, and whatever you feed a language model is only as good as the text it actually receives. ## What actually goes wrong When teams pipe documents straight into an LLM or a retrieval index, a few failure modes show up again and again: - **Reading order breaks.** Multi-column layouts interleave. A two-column page becomes "line 1 left, line 1 right, line 2 left, line 2 right…", so a sentence a human reads top-to-bottom arrives at the model scrambled.- **Tables collapse.** Copy-paste turns a table into a loose run of numbers. The relationship between a header and its cell — the entire point of a table — is gone.- **Headings disappear.** The visual hierarchy (this is a section, this is a subsection) is encoded as font size and weight, not structure. Strip the styling and you get one undifferentiated wall of text. Cas d'usage
Cas d'usage de la conversion de sites web en Markdown
Des agents IA aux migrations de contenu, convertir une page web en Markdown est une petite étape dont dépendent beaucoup de flux de travail.
Pipelines IA et LLM
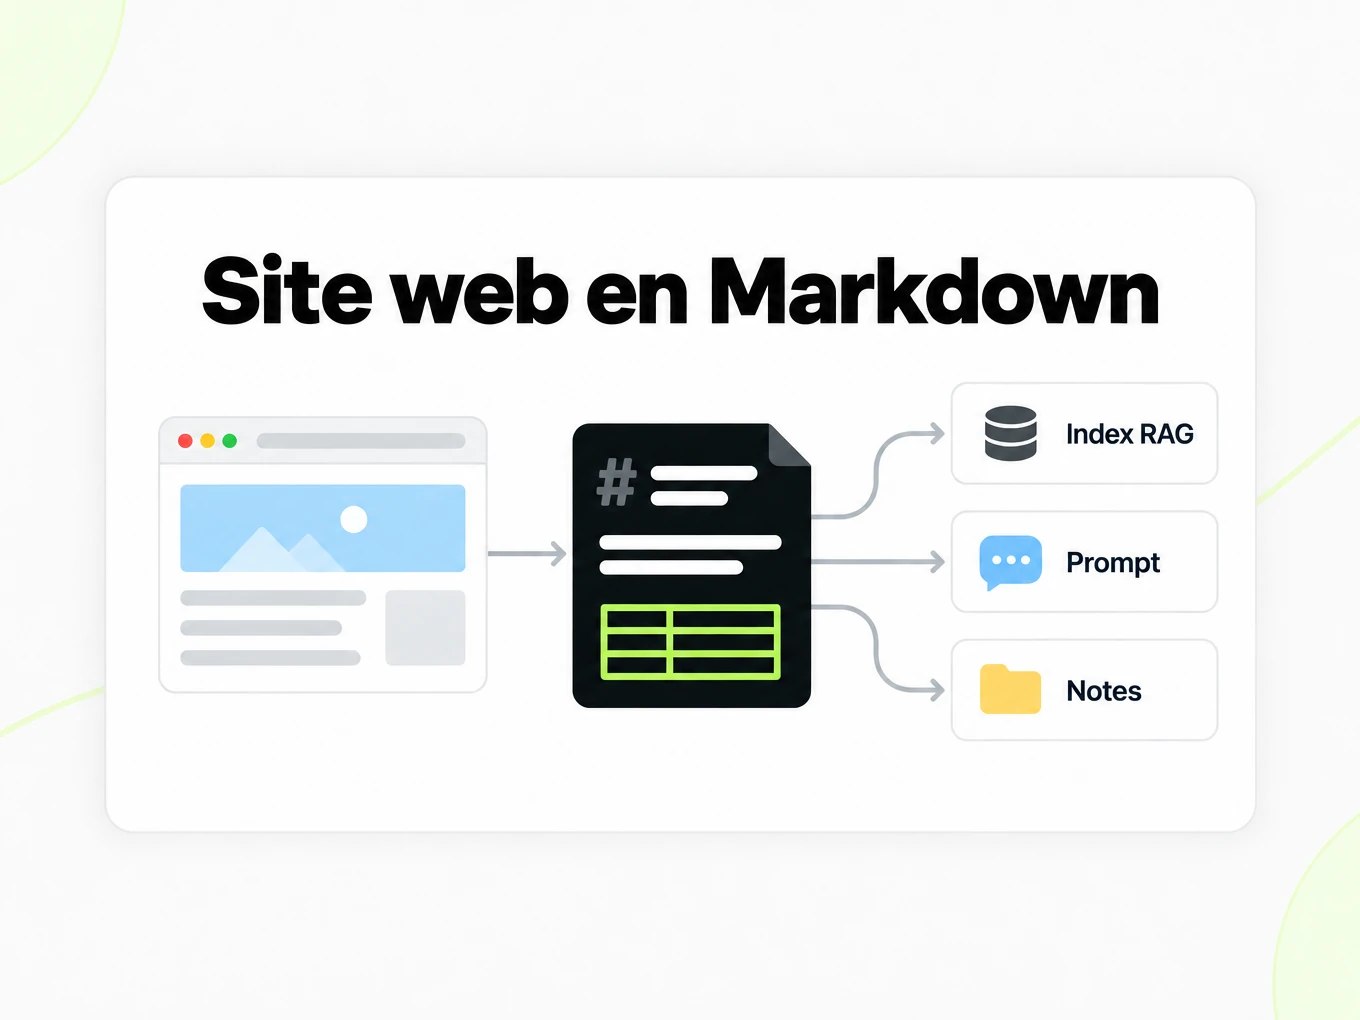
Alimentez les index RAG, les outils d'agents et les prompts avec des articles et de la documentation en texte propre et aux titres intacts, plutôt qu'en HTML brut.
Recherche et notes
Enregistrez une source en Markdown pour la citer, l'annoter ou la conserver dans Obsidian ou un dépôt de notes, avec les liens d'origine toujours en place.
Équipes de contenu
Transférez articles et pages d'aide d'un CMS à un autre, ou portez du matériel de référence vers un site de documentation basé sur Markdown.
Développeurs
Appelez l'API depuis des tâches d'ingestion et des crawlers que vous exécutez déjà et obtenez le même Markdown que celui affiché par le convertisseur du navigateur.
API
API URL en Markdown pour les développeurs
Vous convertissez des pages depuis du code ? Envoyez une URL — ou jusqu'à 20 dans un tableau urls — à POST /v1/convert/url avec votre clé d'API. Réglez render sur auto, force ou skip pour contrôler le rendu JavaScript, et frontmatter sur true pour placer le titre, l'auteur et la date de publication de la page dans le front matter YAML. Le Markdown revient dans la même réponse quand la page se termine dans la fenêtre d'attente ; sinon, vous obtenez une conversion à interroger ou un webhook à son aboutissement. L'accès à l'API fait partie des forfaits payants.
Lire le guide de l'APIcurl -X POST https://api.markitdown.ai/v1/convert/url \ -H "x-api-key: mdai_…" \ -H "content-type: application/json" \ -d '{"url":"https://markitdown.ai/blog/why-pdfs-break-llms","frontmatter":true}'Guide
Vérifier le résultat
Examinez le résultat URL en Markdown à côté de la page publique que vous avez soumise. Le convertisseur conserve le contenu principal et laisse de côté la navigation, les bandeaux de cookies et les liens de pied de page, mais une page sans article net — une page produit, une landing page, une page d'accueil avec de nombreux teasers — peut quand même perdre un panneau latéral ou garder un bloc que vous ne citeriez pas. Vérifiez les premiers et les derniers paragraphes par rapport à la page avant d'indexer le résultat. Les pages qui construisent leur contenu en JavaScript sont d'abord rendues dans un navigateur ; une page qui ne charge son texte qu'après un clic, un défilement ou une connexion ne peut toujours pas être capturée. Quand un site sert déjà son propre Markdown aux clients qui le demandent, le convertisseur utilise cette version si elle passe un contrôle de qualité, et se rabat sur la page HTML quand elle ressemble à un menu de tout le site ou à un export d'archive. Conservez l'URL source à côté du Markdown pour qu'un lecteur puisse revenir à la page d'origine.
Conserver le contexte de la source
Conservez l'URL soumise et votre date de récupération à côté d'un résultat URL en Markdown dans votre propre flux de travail. Une page publique peut changer après votre conversion, donc un visiteur ultérieur peut voir un passage révisé. Avec le front matter activé, le résultat commence par l'URL source, l'URL canonique, le titre et, quand la page les déclare, l'auteur, la date de publication, la description, le nom du site, la langue et l'image principale, lus dans les balises meta, les données structurées et la signature de la page. Ces champs répètent ce que la page dit d'elle-même ; vérifiez-les à la source si votre recherche en dépend. Le champ de métadonnées de l'API est différent : il ne porte que le contexte que vous fournissez. Avant de citer un tableau ou un paragraphe, comparez-le à la page et conservez assez de contexte autour pour ne pas changer son sens. Le Markdown rend le contenu web plus facile à réutiliser ; il ne détermine pas si la page est exacte ni si vous avez le droit de la republier.
HTML enregistré contre URL
Choisissez le convertisseur HTML quand vous avez déjà l'instantané exact de la page à traiter. Choisissez URL en Markdown quand une adresse d'accès public est l'entrée de la conversion courante. Ce sont des flux de travail apparentés mais aux contrôles de source différents : un fichier enregistré fixe l'entrée que vous soumettez et est converti en entier, tandis qu'une URL dépend de ce que le site renvoie au moment de la requête et est réduite à son contenu principal. Aucune des deux voies ne contourne les restrictions d'accès. Si un site refuse le récupérateur ou exige une connexion, utilisez du matériel que vous êtes autorisé à obtenir par un flux de travail approprié. Ne relancez pas sans cesse une URL inaccessible comme si une nouvelle tentative de conversion accordait l'accès.
Recherche avec un LLM
Les chercheurs collent une source, pas un fichier. Ce convertisseur télécharge l'URL que vous soumettez, conserve le corps de l'article ou de la documentation et renvoie un Markdown que vous pouvez citer, découper ou déposer dans un gestionnaire de notes, avec des liens qui restent valides. Il rend les pages en JavaScript quand le serveur envoie une coquille vide, et ne se connecte pas derrière les paywalls.
- Seules les URL d'accès public sont prises en charge.
- Le récupérateur s'identifie ; les opérateurs peuvent refuser le user agent : voir /docs/fetcher.
- Les fichiers HTML enregistrés vont sur /html-to-markdown, pas ici.
Plus de convertisseurs Markdown
- PDF → MarkdownTexte, tableaux et numérisations
- Word → MarkdownDOCX avec titres et listes
- PPT → MarkdownTexte des diapositives, notes et tableaux
- Excel → MarkdownChaque feuille en tableau
- EPUB → MarkdownChapitres de livres numériques en titres
- Image → MarkdownOCR pour numérisations et captures
- HTML → MarkdownCollez ou importez du HTML
- Markdown → HTMLHTML propre et sémantique
- Markdown → TextTexte brut sans balisage
- Markdown → PDFImpression locale en PDF
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
Questions sur URL en Markdown
Comment fonctionne URL en Markdown ?
URL en Markdown télécharge la page publique que vous collez, en conserve le contenu principal et le convertit en Markdown avec des liens en URL complète — aucun fichier à importer. Les pages qui ont besoin de JavaScript sont d'abord rendues dans un navigateur.
Supprime-t-il les publicités et la navigation d'une page active ?
Oui, pour les pages avec une zone de contenu principal nette. URL en Markdown conserve l'article, le corps de documentation ou le fil, et écarte les menus, les bandeaux de cookies et les pieds de page ; une landing page ou une page produit sans bloc principal net peut encore garder ou perdre un panneau latéral, donc vérifiez le résultat.
Y a-t-il des limites de taille pour une page téléchargée ?
Le convertisseur public fonctionne avec des pages web publiques. Les pages téléchargées sont soumises à des limites de taille de réponse et peuvent être refusées si elles sont trop grandes.
Fonctionne-t-il sur les pages derrière une connexion ?
Non. Seules les URL d'accès public sont prises en charge. Les pages derrière une authentification, un paywall ou un écran de connexion ne peuvent pas être téléchargées.
Et les pages rendues avec JavaScript ?
Les pages rendues en JavaScript sont rendues dans un navigateur headless quand le HTML initial est une coquille vide, puis converties comme n'importe quelle autre page. Via l'API, render réglé sur force rend toujours et sur skip jamais. Le texte qui n'apparaît qu'après un clic, un défilement ou une connexion n'est pas capturé.
Puis-je convertir plusieurs URL à la fois ?
Envoyez un tableau urls avec jusqu'à 20 URL publiques à POST /v1/convert/url. Suivez le résultat de chaque fichier et gérez les réponses asynchrones. Voir /developers.
URL en Markdown est-il gratuit ?
Oui. Prévisualiser et copier le Markdown est gratuit sans compte, jusqu'à 3 conversions par heure et 10 par jour ; télécharger le fichier .md nécessite une connexion. Uniquement des pages web publiques (pas d'URL internes ni privées).
Quel contenu le convertisseur conserve-t-il ?
Le convertisseur conserve les titres, paragraphes, listes, liens, images, tableaux et blocs de code du contenu principal, avec les liens relatifs réécrits en URL complètes. Les scripts, les styles, la navigation et les pieds de page sont écartés ; avec le front matter activé, le titre, l'auteur et la date de publication de la page vont en haut.
Existe-t-il une API de conversion par URL ?
Oui. Convertissez des pages web par URL de façon programmatique via l'API REST. Voir /developers. Les fichiers HTML enregistrés passent par /html-to-markdown.
Convertissez URL en Markdown à grande échelle.
Essai gratuit — sans inscription.