
Convertisseur
Convertir PDF en Markdown
Convertir PDF en Markdown est un convertisseur qui reconstruit l'ordre de lecture multicolonne en Markdown structuré pour le RAG et permet d'extraire le texte d'un PDF. L'essai public accepte des fichiers jusqu'à 10 MB.
Essayez un fichier avant de choisir un forfait.
- Sans compte : jusqu'à 10 MB et 25 pages par fichier, 3 conversions par heure et 10 par jour, aperçu et copie dans le navigateur.
- Connecté : 20 conversions gratuites par jour, enregistrées dans votre bibliothèque.
- Lite, Pro et Max incluent des crédits de conversion, le traitement par lots, l'accès à l'API et l'historique conservé. Lite inclut 30 jours d'historique.
Comment faire
Comment convertir un PDF en Markdown
Ce que vous pouvez importer
- Types de fichiers : .pdf
- Essayez sans compte : jusqu'à 10 MB et 25 pages par fichier, 3 conversions par heure et 10 par jour
- Lite prend des fichiers jusqu'à 100 MB, Pro jusqu'à 200 MB
- Max n'a pas de limite de taille par fichier ; les conversions sont bornées par les crédits
Ce qu'il faut vérifier
- Reconstruction de l'ordre de lecture — La conversion PDF tente de reconstruire un ordre de lecture logique.
- Tableaux et titres — Les niveaux de titre et les données tabulaires sont conservés quand le PDF expose des métadonnées structurelles ; les PDF en texte plat produisent une sortie en texte plat.
- PDF numérisés et uniquement composés d'images — Les PDF sans couche de texte (pages numérisées et images insérées) passent aujourd'hui par l'OCR ; la précision dépend de la qualité de la numérisation.
- Fichiers protégés par mot de passe — Les PDF chiffrés ne peuvent pas être analysés ; retirez le mot de passe avant de les importer.
Où va le Markdown
- Copiez le Markdown directement depuis l'aperçu
- Téléchargez le fichier .md et conservez-le dans votre bibliothèque une fois connecté
- Convertissez des dossiers entiers ou des archives ZIP avec Batch Convert
- Automatisez-le avec POST /v1/convert/pdf et votre clé d'API
Pourquoi l'utiliser
Pourquoi utiliser PDF en Markdown
Des rapports en texte lisible
Convertissez les paragraphes et la structure prise en charge d'un rapport en Markdown que vous pouvez inspecter, modifier et conserver à côté du PDF d'origine.
OCR pour les pages numérisées
Les pages uniquement composées d'images peuvent être reconnues par OCR. Comparez les petits caractères, la ponctuation et les tableaux numériques à la numérisation d'origine.
Contexte des titres
Conservez des sections reconnaissables pour vos notes et vos flux de recherche, tout en vérifiant si les titres au style visuel ont été correctement interprétés.
Des tableaux à vérifier
Les tableaux pris en charge deviennent des tableaux textuels. Vérifiez les cellules complexes ou fusionnées avant de traiter les valeurs exportées comme des preuves.
Prévisualiser avant de réutiliser
Comparez le code Markdown à sa vue rendue avant de copier un passage dans ChatGPT, Claude ou un dépôt de documentation.
Une route d'API reproductible
Utilisez la route de conversion PDF dans un script d'ingestion après avoir vérifié dans le navigateur des résultats représentatifs.
Le problème
Pourquoi les colonnes d'un PDF cassent les modèles de langage
Les colonnes s'entremêlent
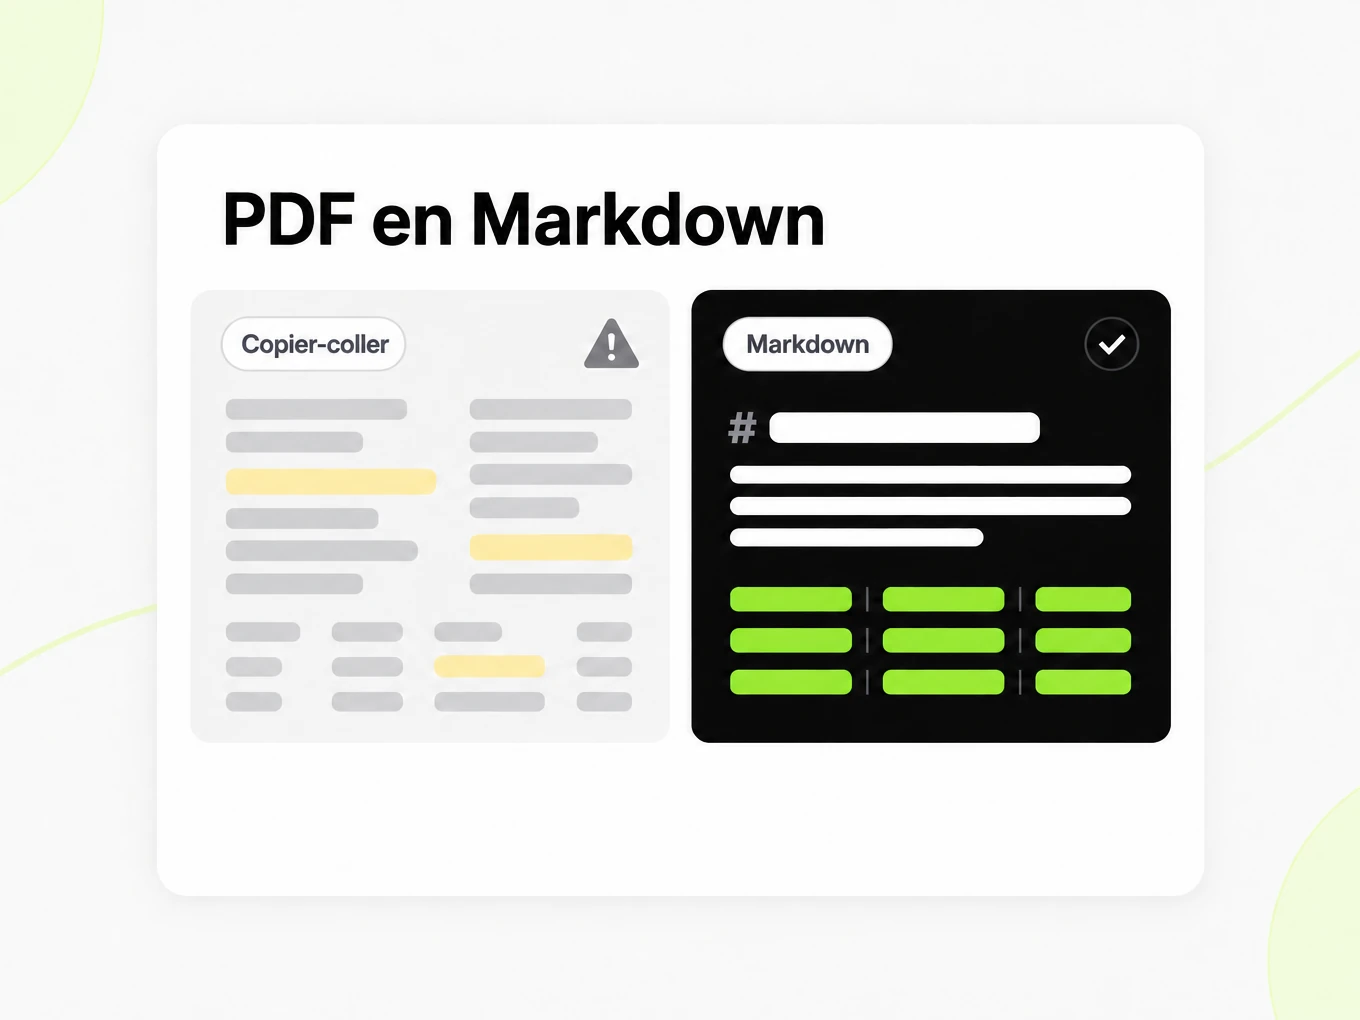
Un rapport à deux colonnes lu de haut en bas mélange le flux de gauche et celui de droite, et le modèle voit une phrase qui n'a jamais existé sur la page.
Les tableaux perdent leur grille
Le copier-coller depuis un PDF transforme un tableau de résultats en une suite de nombres sans ligne d'en-tête pour un analyseur en aval.
Les numérisations n'ont pas de couche de texte
Les pages uniquement composées d'images contiennent des pixels, pas des glyphes, donc les PDF numérisés passent aujourd'hui par l'OCR.
Ce qui est conservé
Ce que ce convertisseur PDF conserve
- Reconstruction de l'ordre de lecture
- La conversion PDF tente de reconstruire un ordre de lecture logique. Vérifiez les transitions entre colonnes par rapport à l'original, surtout pour les rapports et articles complexes.Source: ISO 32000-2 (PDF 2.0)
- Tableaux et titres
- Les niveaux de titre et les données tabulaires sont conservés quand le PDF expose des métadonnées structurelles ; les PDF en texte plat produisent une sortie en texte plat.Source: CommonMark Spec
- PDF numérisés et uniquement composés d'images
- Les PDF sans couche de texte (pages numérisées et images insérées) passent aujourd'hui par l'OCR ; la précision dépend de la qualité de la numérisation.Source: product pipeline
- Fichiers protégés par mot de passe
- Les PDF chiffrés ne peuvent pas être analysés ; retirez le mot de passe avant de les importer.Source: ISO 32000-2 (PDF 2.0)
Exemple : NIST Cybersecurity Framework 2.0, page 15· https://nvlpubs.nist.gov/nistpubs/CSWP/NIST.CSWP.29.pdf
## Appendix A. CSF Core This appendix describes the Functions, Categories, and Subcategories of the CSF Core. Table 1 lists the CSF 2.0 Core Function and Category names and unique alphabetic identifiers. Each Function name in the table is linked to its portion of the appendix. The order of Functions, Categories, and Subcategories of the Core is not alphabetical; it is intended to resonate most with those charged with operationalizing risk management within an organization. The numbering of the Subcategories is intentionally not sequential; gaps in numbering indicate CSF 1.1 Subcategories that were relocated in CSF 2.0. **Table 1. CSF 2.0 Core Function and Category names and identifiers** | Function | Category | Category Identifier || --- | --- | --- || **Govern (GV)** | Organizational Context | GV.OC || | Risk Management Strategy | GV.RM || | Roles, Responsibilities, and Authorities | GV.RR || | Policy | GV.PO || | Oversight | GV.OV || | Cybersecurity Supply Chain Risk Management | GV.SC || **Identify (ID)** | Asset Management | ID.AM || | Risk Assessment | ID.RA || | Improvement | ID.IM || **Protect (PR)** | Identity Management, Authentication, and Access Control | PR.AA || | Awareness and Training | PR.AT || | Data Security | PR.DS || | Platform Security | PR.PS || | Technology Infrastructure Resilience | PR.IR || **Detect (DE)** | Continuous Monitoring | DE.CM || | Adverse Event Analysis | DE.AE | Cas d'usage
PDF en Markdown dans des flux de travail réels
Notes de recherche
Extrayez un article en notes modifiables, vérifiez les passages cités et conservez la référence du PDF pour y revenir plus tard.
Ingestion de rapports
Préparez des rapports au découpage en conservant les en-têtes de tableau, le contexte de section et un lien vers le document d'origine.
Bibliothèques de normes
Convertissez une norme vérifiée en texte consultable et conservez le PDF publié comme version faisant foi.
Évaluation de documents
Comparez des PDF représentatifs avant d'automatiser une collection, y compris des numérisations, des colonnes et un tableau difficile.
API
PDF en Markdown API
Utilisez POST /v1/convert/pdf avec un en-tête x-api-key et un fichier source pris en charge. Une requête terminée peut renvoyer les résultats dans la réponse elle-même ; un HTTP 202 signifie que la conversion se poursuit. Lisez l'en-tête Location de la réponse et interrogez-la avant d'accéder aux fichiers de sortie. Une requête multipart accepte au plus 100 fichiers ; les limites d'abonnement et de requête totale s'appliquent aussi. Gardez les clés d'API dans l'environnement de votre serveur. L'accès à l'API nécessite un abonnement Lite, Pro ou Max.
Lire le guide de l'APIcurl -i "https://api.markitdown.ai/v1/convert/pdf" \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F "file=@source.pdf"# If HTTP 202, GET the Location URL with the same API key.Guide
Vérifier le résultat
Comparez la sortie PDF en Markdown au PDF d'origine avant de l'utiliser comme preuve. Commencez par une page avec des colonnes, une note de bas de page et un tableau plutôt qu'une simple page de couverture. Lisez la dernière phrase d'une colonne et la première de la suivante : elles devraient former la même séquence qu'une personne suit dans le PDF. Comparez ensuite un en-tête de tableau, une valeur négative et une unité. Un aperçu Markdown lisible peut tout de même contenir une substitution de l'OCR ou une cellule mal placée. Si le document oriente une décision financière ou technique, conservez le PDF à côté du Markdown et vérifiez le passage que vous comptez citer. La conversion facilite le travail sur le texte ; elle ne certifie pas la source ni sa transcription.
Ce qui change
La conversion PDF en Markdown remplace la position visuelle par une structure textuelle. Un grand titre peut devenir un marqueur de titre, les paragraphes restent des paragraphes et un tableau pris en charge devient des lignes séparées par des barres verticales. La géométrie de la page, les lignes décoratives, les polices et les sauts de ligne d'origine ne font pas partie du contrat de sortie. C'est utile quand vous voulez modifier un extrait ou construire un index de recherche, mais pas quand l'objectif est de reproduire une brochure avec exactitude. Conservez le PDF d'origine pour sa mise en page faisant foi. Quand une mise en page ne peut pas être représentée par un simple tableau Markdown, voyez si une brève explication ou un tableau corrigé à la main n'est pas la représentation ultérieure la plus claire.
Sources pour le RAG
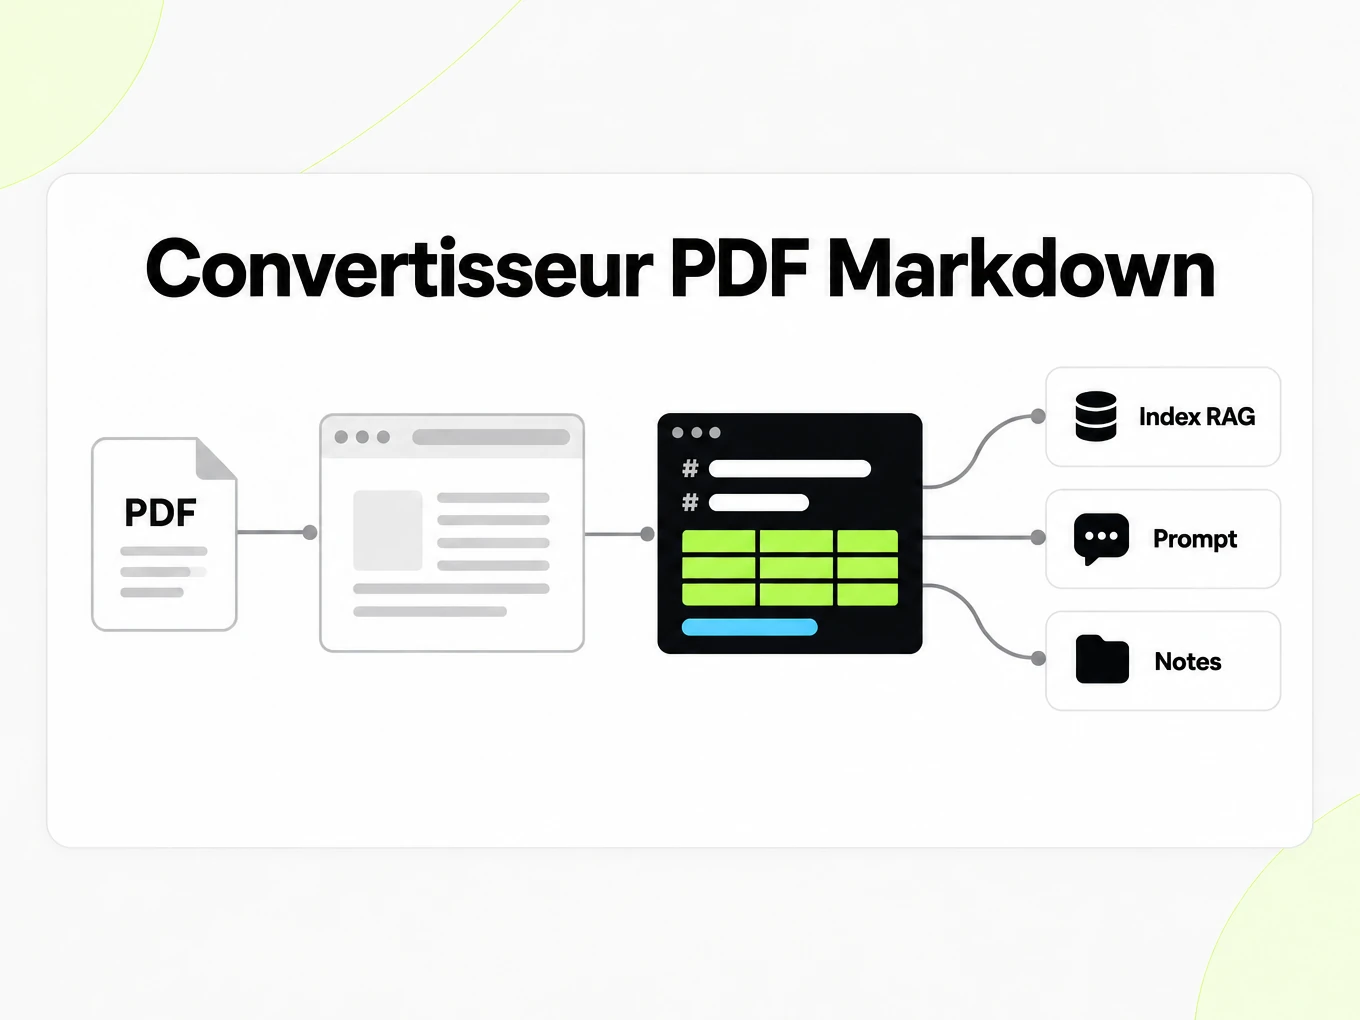
Utilisez le titre du PDF et des en-têtes de section significatifs pour conserver le contexte quand vous découpez le Markdown en fragments. Un fragment dont le seul en-tête est Résultats peut devenir ambigu une fois sorti du document ; votre code d'ingestion peut conserver le nom du document et l'en-tête parent avec ce fragment. Gardez un en-tête de tableau avec ses lignes et évitez de couper une liste au milieu d'une condition. Conservez la référence du PDF d'origine à part pour qu'une réponse retrouvée puisse ramener le lecteur à la source. LangChain et LlamaIndex peuvent consommer le texte de votre propre processus d'ingestion, mais le choix du découpeur, du modèle de vectorisation et de la politique de recherche reste du ressort de votre application. Testez la recherche avec des questions dont vous avez vérifié la réponse dans le PDF.
Choisir le PDF
Préférez le PDF exporté d'origine quand il contient du texte lisible. Une capture d'écran de ce PDF ajoute une étape de reconnaissance d'image et peut perdre les petits caractères avant même que la conversion ne commence. Pour les PDF numérisés, redressez les pages pivotées et utilisez une version où la ponctuation et les bords des tableaux restent lisibles à un zoom normal. Retirez le mot de passe avant d'importer un PDF chiffré. Si seule une partie d'un long rapport est pertinente, préparez les pages sources concernées et conservez leur référence d'origine dans vos notes. Répéter la même numérisation abîmée ne corrigera guère le détail manquant ; améliorez d'abord la source, puis comparez le nouveau résultat PDF en Markdown à l'ancien.
Limites de découpage
La qualité de la recherche dépend de limites de fragments qui correspondent au document qu'une personne lirait. Ce convertisseur réordonne les colonnes et conserve les niveaux de titre pour qu'un découpeur émette des passages plutôt que des fragments entrelacés issus d'un article à deux colonnes. Même sur un PDF en texte aplati, l'extraction de texte PDF vise à préserver la structure.
- Utilisez le Markdown comme l'artefact que vous découpez et vectorisez, pas un vidage de texte aplati.
- Les pages standard et les pages OCR sont facturées à 1 crédit par page sur les forfaits avec connexion.
- Les fichiers protégés par mot de passe doivent être déverrouillés avant l'import ; les PDF chiffrés sont refusés.
Plus de convertisseurs Markdown
- Word → MarkdownDOCX avec titres et listes
- PPT → MarkdownTexte des diapositives, notes et tableaux
- Excel → MarkdownChaque feuille en tableau
- Image → MarkdownOCR pour numérisations et captures
- HTML → MarkdownCollez ou importez du HTML
- URL → MarkdownToute page web publique, nettoyée
- Markdown → HTMLHTML propre et sémantique
- Markdown → TextTexte brut sans balisage
- Markdown → PDFImpression locale en PDF
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
Questions sur PDF en Markdown
Comment fonctionne PDF en Markdown ?
PDF en Markdown convertit la source prise en charge en Markdown lisible pour le vérifier et le réutiliser. L'essai anonyme accepte jusqu'à 10 MB et 25 pages par fichier, avec 3 conversions par IP et par heure et 10 par jour. Comparez la sortie à la source avant de l'utiliser.
Quelle est la taille maximale d'un PDF ?
Le convertisseur public accepte des fichiers PDF jusqu'à 10 MB. Lite prend en charge des fichiers jusqu'à 100 MB ; Pro et Max ont des limites plus élevées.
Prenez-vous en charge l'OCR PDF et les numérisations ?
Oui. L'OCR PDF traite aujourd'hui les PDF basés sur l'image ; les numérisations nettes et à haute résolution donnent les meilleurs résultats.
Les articles de recherche multicolonnes sont-ils gérés ?
Oui. Convertir PDF en Markdown tente de reconstruire l'ordre de lecture. Comparez les transitions entre colonnes à la source, car les mises en page complexes peuvent encore demander une correction.
Les tableaux financiers survivront-ils ?
Les tableaux des PDF qui portent des métadonnées structurelles sont convertis en tableaux Markdown. Pour un PDF en texte aplati, les tableaux ont besoin de l'OCR pour être récupérés.
Puis-je convertir un PDF protégé par mot de passe ?
Non. Les PDF chiffrés ne peuvent pas être analysés. Retirez le mot de passe avant de les importer.
Le résultat convient-il à un découpage pour le RAG ?
Le Markdown conserve les titres, les listes et les tableaux lorsque c'est possible, de sorte que le découpage et la vectorisation restent prévisibles par rapport au copier-coller.
Puis-je convertir un PDF depuis du code ?
Oui. Utilisez une clé d'API pour envoyer le fichier directement à /v1/convert/pdf et lire le Markdown dans la réponse. Voir /developers.
Convertissez PDF en Markdown à grande échelle.
Essai gratuit — sans inscription.