
Convertitore Markdown per documenti e pagine web.
Un convertitore Markdown per documenti e pagine web pubbliche: PDF, Word, PowerPoint, Excel, immagini e HTML diventano testo che puoi ispezionare, riutilizzare e passare a un flusso di lavoro con l'IA.
Prova anonima · 10 MB · 3 conversioni / ora · 10 / giorno
Converti in Markdown da
- DOCX
- PPTX
- XLSX
- PNG / JPG
- HTML
- URL
Come funziona
Convertitore Markdown: come funziona
markitdown.ai è un convertitore Markdown che converte PDF, file di Office, immagini e pagine web in Markdown pulito e pronto per l'IA per ChatGPT, Claude, pipeline RAG e agenti, tramite una prova anonima o un account a pagamento con accesso API per sviluppatori.
What happens
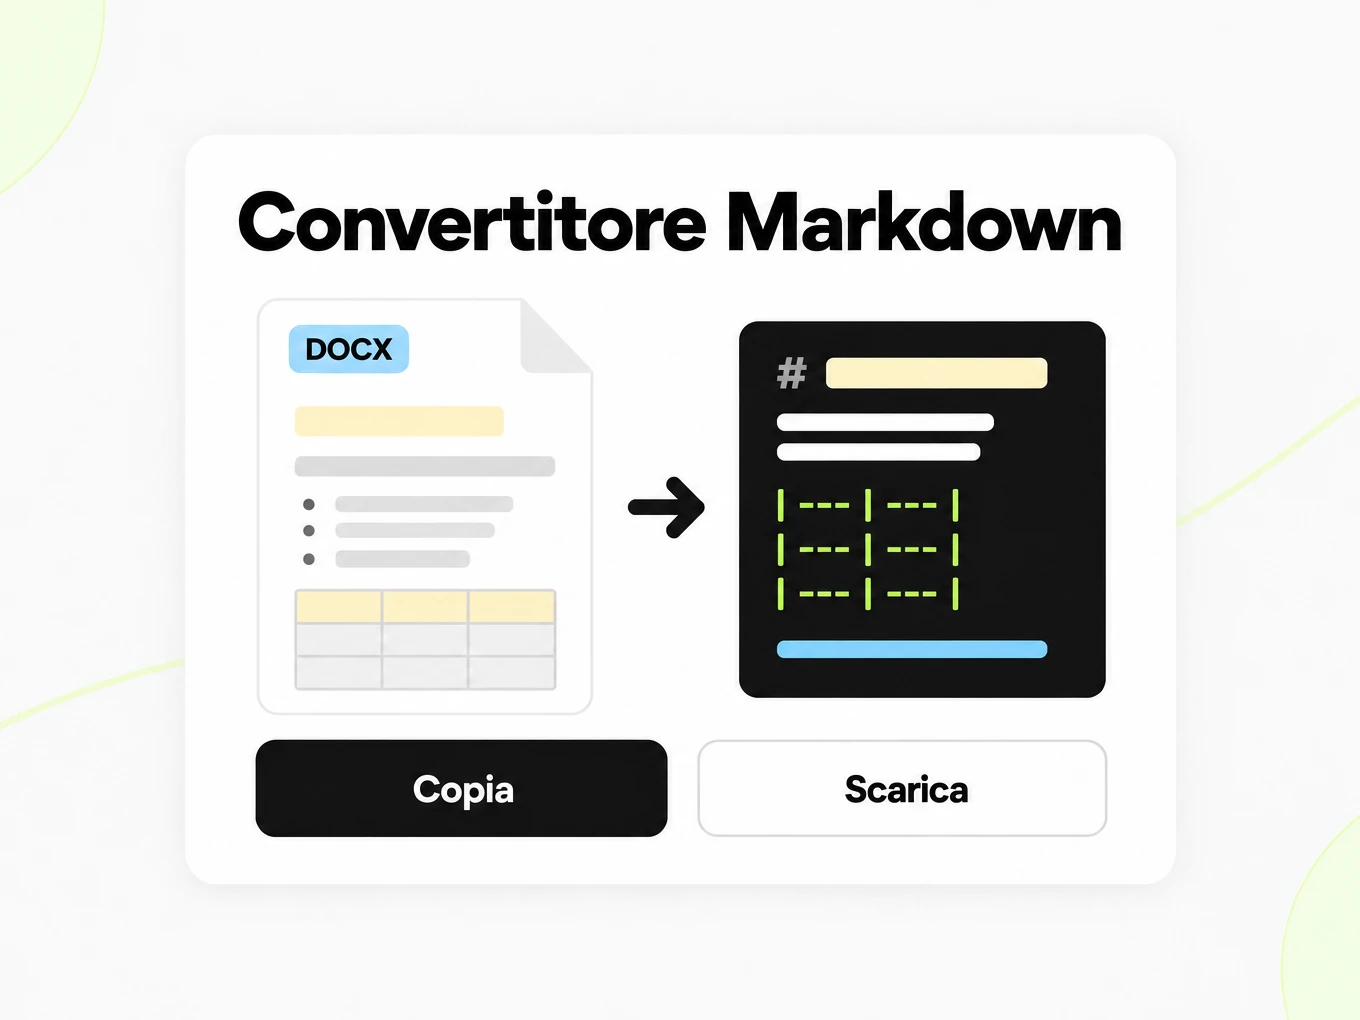
Carica un file o incolla un URL. La conversione avviene sui nostri server, non come copia e incolla nel browser, quindi lo stesso file produce lo stesso Markdown da qualsiasi origine. Ogni pagina viene elaborata in base a ciò che contiene, e intestazioni, elenchi e tabelle escono come vera struttura Markdown.
What you get
- Le pagine con livello di testo vengono lette direttamente; scansioni e immagini passano automaticamente dall'OCR
- I download da URL avvengono dai nostri server, con indirizzi privati e interni bloccati
- Convertitore pubblico: fino a 10 MB e 25 pagine, senza accedere
- I piani con accesso alzano entrambi i limiti, fino a 200 MB e 200 pagine in Pro
What happens
Il visualizzatore mette il documento di origine e il Markdown generato uno accanto all'altro, così puoi controllare intestazioni, tabelle e ordine di lettura prima di usare il risultato. Passa dall'anteprima renderizzata al Markdown non elaborato per vedere esattamente ciò che riceverà un modello o una pipeline.
What you get
- Origine e Markdown sono mostrati affiancati nel visualizzatore
- Passa il pannello Markdown dall'anteprima renderizzata al codice non elaborato
- Copia il risultato gratis, senza bisogno di un account
- Scarica il file .md quando accedi
What happens
Le stesse impostazioni che hanno funzionato per un file valgono per una pila di file o una chiamata di pipeline, e ogni risultato resta nella tua Libreria. Batch segue ogni file con stato e nuovo tentativo propri, e l'API consegna lo stesso Markdown direttamente al tuo codice.
What you get
- Lo stesso motore di analisi per l'app web, Batch (ZIP o un elenco di URL) e l'API
- POST /v1/convert/{name} restituisce Markdown in una sola chiamata in 60 secondi, oppure una conversione che interroghi o ricevi via webhook
- La Libreria conserva ogni esecuzione per la finestra di cronologia del tuo piano: 30, 60 o 90 giorni
Crediti
Precisione in Markdown, con prezzo per pagina.
Una fattura con livello di testo e un estratto conto scansionato costano lo stesso per pagina: la pipeline sceglie l'estrazione diretta o l'OCR per te. Gli extra IA per figure e immagini sono opzionali e misurati separatamente.
- per pagina, testo o scansione
- 1 credito
- per pagina, testo o scansione
PDF con livello di testo, file di Office e HTML
OCR per pagine scansionate, foto e screenshot
Grafici e figure descritti in PDF · piani a pagamento
Contenuto dell'immagine descritto, non solo OCR · piani a pagamento
API Markdown
Un'API Markdown per la tua pipeline RAG.
- La stessa pipeline di analisi dell'app web
- Migliaia di file in batch con webhook al completamento
- Chiavi API con ambito e un registro attività completo
- Markdown in una sola chiamata, oppure una conversione da interrogare quando un file impiega più di 60 secondi
curl -X POST https://api.markitdown.ai/v1/convert/word \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F file=@vendor-security-review-q3-2026.docx # If HTTP 202, GET the Location URL with the same API key.# Verified local parser output for vendor-security-review-q3-2026.docx:# ## Review Findings# # Risk ratings follow the standard High / Medium / Low scale defined in the vendor risk management policy.# # | Vendor | Risk Rating | Finding | Owner |# | --- | --- | --- | --- |# | CloudScan OCR | Medium | No documented data retention limit on uploaded scans | Security |# | PayBridge | Low | SOC 2 Type II renewed; no open items | Finance |# | LingoTrans API | High | Sub-processor list not disclosed on request | Legal |# | ArchiveNow Storage | Medium | Encryption at rest confirmed; key rotation overdue | Security |Prezzi
Prezzi semplici per la conversione in Markdown.
Il problema
I documenti non sono pronti per l'IA
La maggior parte dei documenti è stata creata per persone e stampanti, non per modelli linguistici. Prima di poter incorporare, recuperare o ragionare su un file, bisogna trasformarlo in testo prevedibile. È più difficile di quanto sembri, ed è esattamente dove fallisce l'estrazione ingenua.
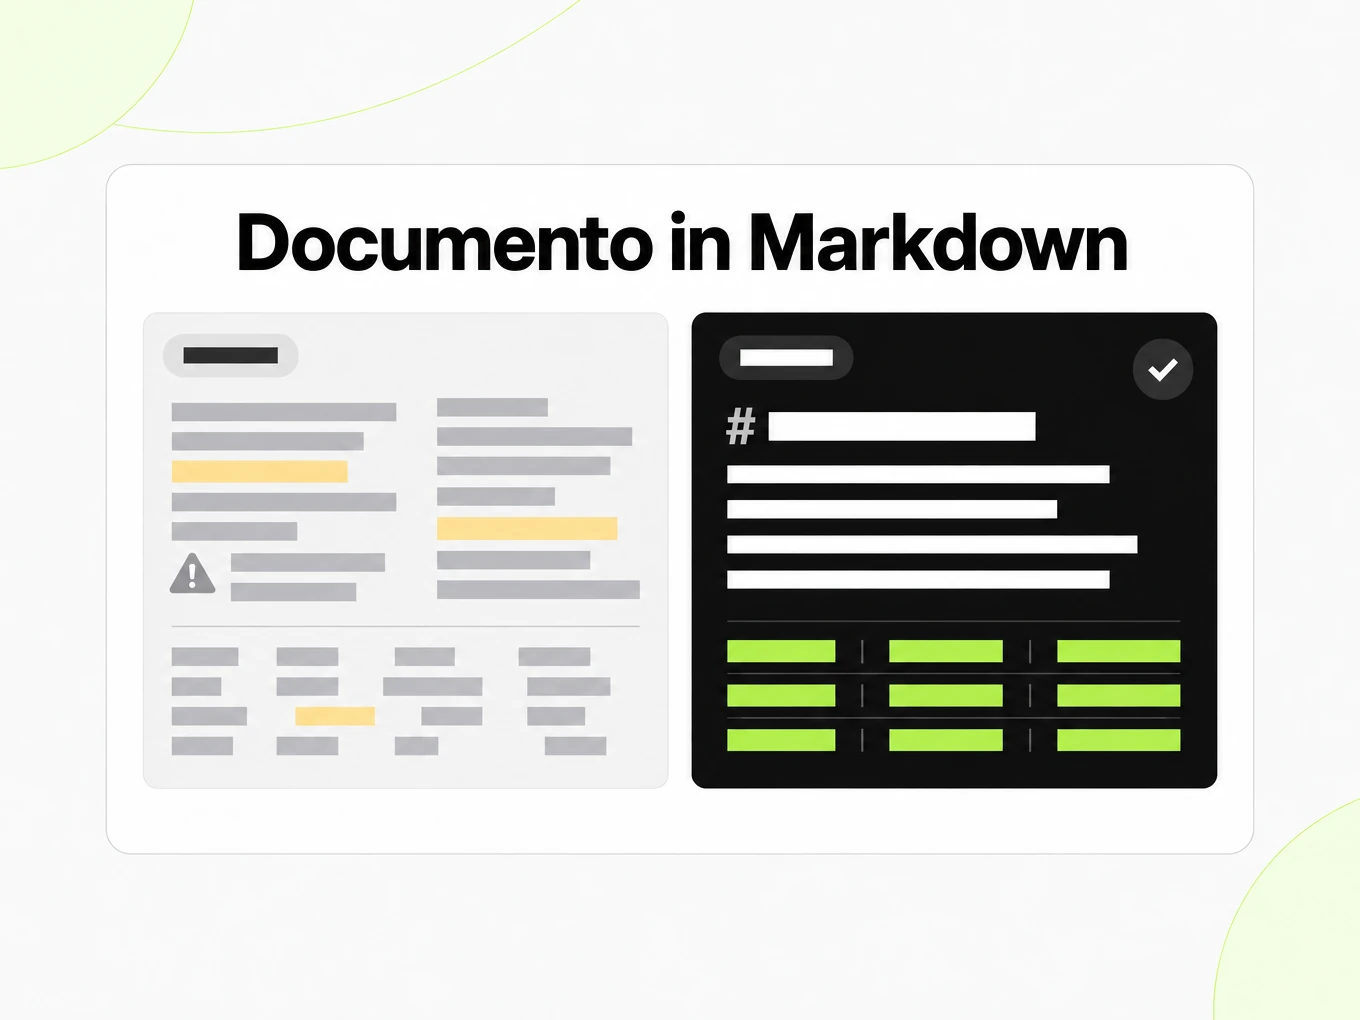
L'ordine di lettura si rompe
I PDF a più colonne, i titoli e le note a piè di pagina si intrecciano, e il testo che legge un LLM non corrisponde più al documento che vede una persona.
Tabelle e titoli vengono appiattiti
Copia e incolla fa collassare le tabelle in serie di numeri ed elimina la gerarchia di titoli che dà struttura al documento.
Le scansioni richiedono l'OCR
Le pagine basate su immagini e i contratti scansionati non hanno alcun livello di testo finché non passano dal riconoscimento ottico dei caratteri.
Il testo non elaborato è rumoroso
L'estrazione improvvisata lascia numeri di pagina, trattini spezzati e caratteri sparsi che inquinano i prompt e i risultati di recupero.
Le pipeline RAG e gli agenti hanno bisogno di una struttura coerente, non solo di caratteri estratti. Il Markdown prevedibile è ciò che fa comportare allo stesso modo suddivisione, incorporamento e recupero su migliaia di documenti, invece di fallire in silenzio con i più disordinati. L'analizzatore che gestisce i file difficili è ciò che mantiene affidabili quelli puliti.
Formati di input
Converti qualsiasi documento in Markdown
Ogni formato di input ha la sua pagina di conversione con limiti, note di formato e un esempio di output. Condividono tutti lo stesso motore di analisi, quindi scegli la pagina corrispondente al tuo file:
- PDF in Markdown — report, articoli, manuali e contratti. I PDF con testo nativo vengono analizzati direttamente e l'ordine di lettura a più colonne viene ricostruito; i PDF scansionati passano dall'OCR pagina per pagina.
- Word in Markdown — file .docx e .doc legacy con titoli, elenchi, tabelle e commenti conservati, così una policy o una specifica si leggono come uno schema invece che come un unico blocco.
- PPT in Markdown — presentazioni .pptx e .ppt diapositiva per diapositiva, con i titoli delle diapositive come intestazioni e punti elenco e tabelle conservati, il che rende cercabile una presentazione di 40 diapositive.
- Excel in Markdown — cartelle di lavoro .xlsx e .xls in cui ogni foglio diventa una tabella Markdown sotto il nome del foglio.
- Immagine in Markdown — screenshot e scansioni PNG e JPG tramite OCR. La comprensione immagini con IA è un'opzione separata, con accesso effettuato.
- HTML in Markdown — pagine salvate, esportazioni e frammenti, con script e stili rimossi e la struttura dell'articolo, i link e le tabelle conservati.
- URL in Markdown — incolla un indirizzo web pubblico e ottieni la pagina in Markdown, scaricata sul server con un limite di dimensione e un timeout, così un sito lento non blocca la richiesta.
Formati di output
Da Markdown a qualsiasi formato
Markdown è il formato di scambio, quindi la conversione funziona anche al contrario. Gli editor Markdown qui sotto vengono renderizzati mentre scrivi nel browser e non caricano mai il tuo testo:
- Markdown in HTML — HTML semantico e pulito con tabelle in stile GitHub, elenchi di attività ed evidenziazione del codice, pronto da incollare in un CMS o in un'email.
- Markdown in testo — testo semplice con titoli, elenchi e tabelle appiattiti in modo leggibile per finestre di chat, ticket e moduli.
- Markdown in PDF — un'anteprima di stampa locale; usa Stampa / Salva come PDF nel browser e controlla le pagine salvate.
L'estrazione di JSON strutturato e la trascrizione di audio e video sono livelli pianificati sopra il Markdown. Sono elencati come roadmap, non come funzionalità già disponibili.
Casi d'uso
Fatto per tutti i team
Il convertitore Markdown offre una prova anonima per verificare un primo risultato. Il motivo per cui i team continuano a usarlo è tutto ciò che viene dopo il primo file: cronologia, batch, documenti più grandi e un'API che integra la conversione nei sistemi che già usi. Lo stesso Markdown funziona sia che lo consumi una persona sia un indice di ricerca o un modello.
RAG e pipeline IA
Converti i documenti di origine in Markdown pulito prima della suddivisione, dell'incorporamento o dell'elaborazione da parte degli agenti. Una struttura prevedibile fa sì che il tuo splitter veda titoli e tabelle reali invece di un muro di testo estratto, mantenendo il recupero pertinente e i prompt liberi dal rumore dell'impaginazione.
Ricerca e report
Converti articoli, white paper e presentazioni in Markdown modificabile e cercabile. Ricercatori e analisti possono citare, annotare, riassumere e riutilizzare i risultati senza ribattere le tabelle né perdere l'ordine di lettura di un PDF denso.
Documenti operativi
Elabora policy, contratti, fatture e file interni senza ripulire a mano copia e incolla. Una cronologia Markdown salvata rende il lavoro documentale ricorrente più facile da rivedere, confrontare e riutilizzare nella routine di un team.
Automazione per sviluppatori
Usa l'API per convertire file all'interno di job di ingestione, strumenti interni e flussi documentali. Invia una richiesta, ricevi Markdown e portalo in un CMS, una base di conoscenza, un bot di supporto o una pipeline di agenti con un output affidabile.
Basi di conoscenza e supporto
Porta manuali di prodotto, note di rilascio e wiki interne in un unico corpus Markdown che un bot di supporto o un assistente interno possa cercare. Poiché titoli e tabelle sopravvivono, le risposte puntano alla sezione giusta invece che a un blocco grande quanto una pagina.
Agenti e strumenti
Dai a un agente un convertitore Markdown per file supportati e URL pubblici, e verifica il completamento prima che ne consumi il risultato. Leggi questo sito allo stesso modo: ogni pagina pubblica risponde ad Accept: text/markdown con un gemello Markdown, e llms.txt li elenca tutti.
Qualità dell'output
Struttura, non solo testo
Un convertitore Markdown utile conserva più di singoli caratteri di un PDF. L'obiettivo qui è un Markdown che mantenga la struttura da cui dipendono i tuoi strumenti a valle, prodotto da una pipeline di analisi sul server invece che da un fragile copia e incolla del browser.
- Conserva titoli, elenchi, tabelle, link e ordine di lettura dove l'origine li ha.
- Gestisce PDF, Word, PowerPoint, Excel, immagini, HTML e URL con un'unica pipeline.
- Elabora PDF scansionati e immagini con l'OCR già oggi; la qualità del riconoscimento dipende dall'immagine di origine.
- Esegue documenti lunghi in modo asincrono, così report e presentazioni grandi finiscono invece di andare in timeout.
Le pagine standard e le pagine OCR costano 1 credito per pagina; gli account con piano a pagamento possono usare la comprensione immagini con IA a 5 crediti per immagine. L'output segue CommonMark con tabelle in stile GitHub, quindi viene renderizzato in qualsiasi visualizzatore Markdown e analizzato con qualsiasi libreria Markdown. Ogni conversione deve produrre un artefatto che puoi ispezionare, salvare e riutilizzare: questo è il livello da raggiungere.
Tre modi per entrare
Browser, API o agente
Il convertitore Markdown nell'app web copre la conversione manuale una tantum e ricorrente. Batch copre le pile di file. L'API copre tutto ciò che deve avvenire automaticamente, inclusi gli agenti che la chiamano come strumento. Tutti e tre condividono un account, un saldo di crediti e un motore di analisi. La maggior parte dei team inizia dal browser e passa all'API quando la conversione entra in un prodotto o in un flusso di lavoro interno.
| Aspect | Browser | Batch | API |
|---|---|---|---|
| Ideale per | Un file alla volta | Molti file in un'esecuzione | Pipeline, strumenti e agenti |
| Accesso | Non serve per il primo file | Piani a pagamento | Piani a pagamento, chiave API |
| Input | Caricamento o URL | Un elenco di caricamenti o ID file | Caricamento, URL, testo in linea o ID file |
| Output | Anteprima, copia, download .md | Libreria con stato per file | JSON con Markdown, output per pagina, webhook |
| Limiti | 10 MB e 25 pagine senza accedere | Concorrenza del piano | 20 a 60 richieste al minuto secondo il piano |
| Attesa | Secondi, nella pagina | In background | Sincronizzazione fino a 60 s, poi una conversione da interrogare |
App web
- Carica file o incolla URL e visualizza in anteprima il Markdown renderizzato
- Salva la cronologia delle conversioni e scarica i risultati .md
- Converti in batch il lavoro ripetuto con stato per file
- Controlla crediti e utilizzo per piano
API per sviluppatori
- POST /v1/convert/{name} restituisce Markdown in una sola chiamata, oppure una conversione quando un file impiega più di 60 secondi
- Interroga le conversioni o ricevi webhook al termine
- Invia Accept: text/markdown per leggere qualsiasi pagina pubblica come Markdown
- Specifica leggibile dalle macchine in /v1/openapi.json
FAQ
Domande che si fanno i team
Convertitore Markdown: cosa fa?
Un convertitore da documento a Markdown è uno strumento che legge un PDF, Word, PowerPoint, Excel, un'immagine o una pagina web e ne riscrive il contenuto come Markdown: i titoli diventano righe #, le tabelle diventano tabelle con barre e gli elenchi restano elenchi. L'idea è ottenere testo semplice prevedibile che modelli linguistici, pipeline RAG e agenti possano suddividere, incorporare e citare senza rumore di impaginazione.
Il convertitore gratuito è davvero gratuito?
Sì. Le pagine del convertitore pubblico non richiedono un account né una carta. I file fino a 10 MB e 25 pagine vengono convertiti nel browser, e puoi visualizzare in anteprima e copiare il Markdown. Gli abbonamenti Lite, Pro e Max partono da $20 al mese e aggiungono libreria salvata, batch e API.
Come funzionano i PDF scansionati e le immagini?
Le pagine solo immagine non hanno un livello di testo, quindi la pipeline esegue l'OCR automaticamente e restituisce Markdown come con il testo digitale. Le pagine standard e le pagine OCR costano 1 credito per pagina. La qualità del riconoscimento dipende dall'immagine di origine: una scansione a 300 dpi si legge molto meglio della foto di una pagina fatta con il telefono.
Posso eseguirlo da codice o da un agente?
Sì. POST /v1/convert/{name} accetta un caricamento, un URL o testo in linea con una chiave API e restituisce Markdown in una sola chiamata quando il file termina in 60 secondi, oppure una conversione che puoi interrogare o ricevere via webhook. Gli agenti possono chiedere Accept: text/markdown su qualsiasi pagina pubblica, e la specifica leggibile dalle macchine è in /v1/openapi.json.
Cosa succede ai miei file dopo la conversione?
Quando elimini una conversione, questa sparisce subito dalla tua libreria e i suoi file archiviati vengono cancellati entro un'ora; un file di origine condiviso con un'altra conversione viene conservato finché non viene eliminata anche quella. Eliminando il tuo account vengono cancellati tutti i file di origine e di risultato archiviati. I piani a pagamento conservano la cronologia per 30, 60 o 90 giorni a seconda del piano.
Converti il tuo primo file in Markdown.
Provalo gratis: non serve registrarsi.