
Convertitore
URL in Markdown: convertire una pagina web online
URL in Markdown è un convertitore gratuito che trasforma una pagina web accessibile pubblicamente nel Markdown pulito del suo contenuto principale — l'articolo, la pagina di documentazione o la discussione senza la navigazione del sito — pronto per LLM, pipeline RAG e note. Nessuna registrazione per provarlo; la prova consente 3 conversioni per IP all'ora e 10 al giorno.
Come si fa
Come convertire una pagina web in Markdown
Cosa puoi incollare
- Qualsiasi pagina pubblica http(s): articoli, documentazione, post di blog
- Le pagine dietro un accesso o un paywall non possono essere recuperate
- La pagina viene scaricata sul nostro server, senza eseguire il suo JavaScript
- Provalo senza account: fino a 10 MB e 25 pagine per file, 3 conversioni all'ora e 10 al giorno
Cosa controllare
- Download lato server — La pagina viene scaricata lato server, richiedendo prima il Markdown e poi l'HTML; il Markdown proprio di un sito viene usato solo se supera un controllo di qualità.
- Estrazione del contenuto principale — Più estrattori — punteggio di leggibilità, rilevamento del boilerplate, analisi della densità del testo e l'elemento main o article della pagina stessa — competono, e vince quello che conserva più struttura e prosa.
- Pagine renderizzate con JavaScript — Un guscio applicativo vuoto viene renderizzato in un browser headless, che attende che la pagina si stabilizzi e poi passa il DOM renderizzato alla stessa estrazione.
- Pagine pubbliche, dimensione e identità — Sono supportati solo URL accessibili pubblicamente: le pagine dietro autenticazione, paywall o schermate di accesso non possono essere scaricate.
Dove va il Markdown
- Copia il Markdown direttamente dall'anteprima
- Scarica il file .md e conservalo nella tua libreria dopo l'accesso
- Converti più pagine contemporaneamente con un array urls su POST /v1/convert/url
- Automatizzalo con POST /v1/convert/url e la tua chiave API
Perché usarlo
Perché usare questo convertitore da URL a Markdown
Una pagina web è scritta per un browser. Il Markdown è scritto per le persone e i modelli. Questo convertitore trova la parte della pagina che porta il significato, ne conserva la struttura e lascia indietro gli elementi di contorno del sito.
Contenuto principale, non l'intera pagina
Più estrattori leggono la pagina e vince il risultato che conserva la maggior parte dell'articolo, così menu, banner dei cookie, piè di pagina e riquadri di post correlati restano fuori dal Markdown.
Struttura che resiste
Titoli, elenchi, tabelle e blocchi di codice arrivano come Markdown, e ogni link relativo e percorso immagine viene riscritto in un URL completo che funziona anche fuori dalla pagina.
Anche le pagine JavaScript vengono renderizzate
Quando il primo HTML è un guscio applicativo vuoto, la pagina viene renderizzata in un browser headless e viene convertito il contenuto renderizzato al suo posto.
Gratis da provare, senza accesso
Visualizza in anteprima e copia il Markdown senza account, fino a 3 conversioni all'ora e 10 al giorno. Accedi per scaricare il file .md.
Un fetcher educato e identificato
Ogni richiesta si identifica con uno user agent documentato e i proprietari dei siti possono bloccarla: vedi la pagina del fetcher nella documentazione.
Lo stesso motore dell'API
Il convertitore di questa pagina e POST /v1/convert/url eseguono lo stesso codice, quindi uno script può convertire fino a 20 URL per chiamata.
Il problema
Perché una pagina attiva è rumorosa per i modelli
Le pagine sono rumorose
Le pagine web attive seppelliscono il contenuto sotto navigazione, annunci, banner e script — spesso diverse volte più testo dell'articolo stesso.
Il markup è disordinato
L'HTML scritto a mano e quello generato raramente corrispondono in modo pulito a una struttura leggibile.
L'IA vuole l'articolo
RAG e agenti vogliono l'articolo, non gli elementi di interfaccia che lo circondano, e alcune pagine mostrano l'articolo solo dopo l'esecuzione di JavaScript.
Cosa viene conservato
Cosa scarica questo convertitore di URL
- Download lato server
- La pagina viene scaricata lato server, richiedendo prima il Markdown e poi l'HTML; il Markdown proprio di un sito viene usato solo se supera un controllo di qualità. Non serve alcun plugin del browser né strumento locale.Source: RFC 9110: HTTP Semantics
- Estrazione del contenuto principale
- Più estrattori — punteggio di leggibilità, rilevamento del boilerplate, analisi della densità del testo e l'elemento main o article della pagina stessa — competono, e vince quello che conserva più struttura e prosa. I siti noti come i generatori di documentazione, GitHub e Wikipedia usano regole specifiche per sito.Source: HTML Living Standard: the main element
- Pagine renderizzate con JavaScript
- Un guscio applicativo vuoto viene renderizzato in un browser headless, che attende che la pagina si stabilizzi e poi passa il DOM renderizzato alla stessa estrazione. Il contenuto che appare solo dopo un clic o uno scorrimento non viene catturato.Source: HTML Living Standard
- Pagine pubbliche, dimensione e identità
- Sono supportati solo URL accessibili pubblicamente: le pagine dietro autenticazione, paywall o schermate di accesso non possono essere scaricate. Le pagine scaricate sono soggette a limiti di dimensione della risposta e lo user agent del fetcher è documentato su /docs/fetcher.Source: product pipeline
Esempio: articolo del blog markitdown.ai tramite download da URL· https://markitdown.ai/blog/why-pdfs-break-llms
# Why PDFs break LLMs — and what clean Markdown fixes _Published 2026-06-12 · The markitdown.ai team_ > A PDF that looks perfect to a human often falls apart the moment a model reads it. Here's what goes wrong, and why converting to clean Markdown first makes downstream AI far more reliable. A PDF renders perfectly for a human and falls apart the moment a model reads it. The page you see — columns, tables, headers, footnotes — is a *visual* arrangement, not a logical one. When you pull raw text out of it, that visual order rarely survives, and whatever you feed a language model is only as good as the text it actually receives. ## What actually goes wrong When teams pipe documents straight into an LLM or a retrieval index, a few failure modes show up again and again: - **Reading order breaks.** Multi-column layouts interleave. A two-column page becomes "line 1 left, line 1 right, line 2 left, line 2 right…", so a sentence a human reads top-to-bottom arrives at the model scrambled.- **Tables collapse.** Copy-paste turns a table into a loose run of numbers. The relationship between a header and its cell — the entire point of a table — is gone.- **Headings disappear.** The visual hierarchy (this is a section, this is a subsection) is encoded as font size and weight, not structure. Strip the styling and you get one undifferentiated wall of text. Casi d'uso
Casi d'uso per la conversione di un sito web in Markdown
Dagli agenti IA alla migrazione di contenuti, convertire una pagina web in Markdown è un piccolo passo da cui dipendono molti flussi di lavoro.
Pipeline IA e LLM
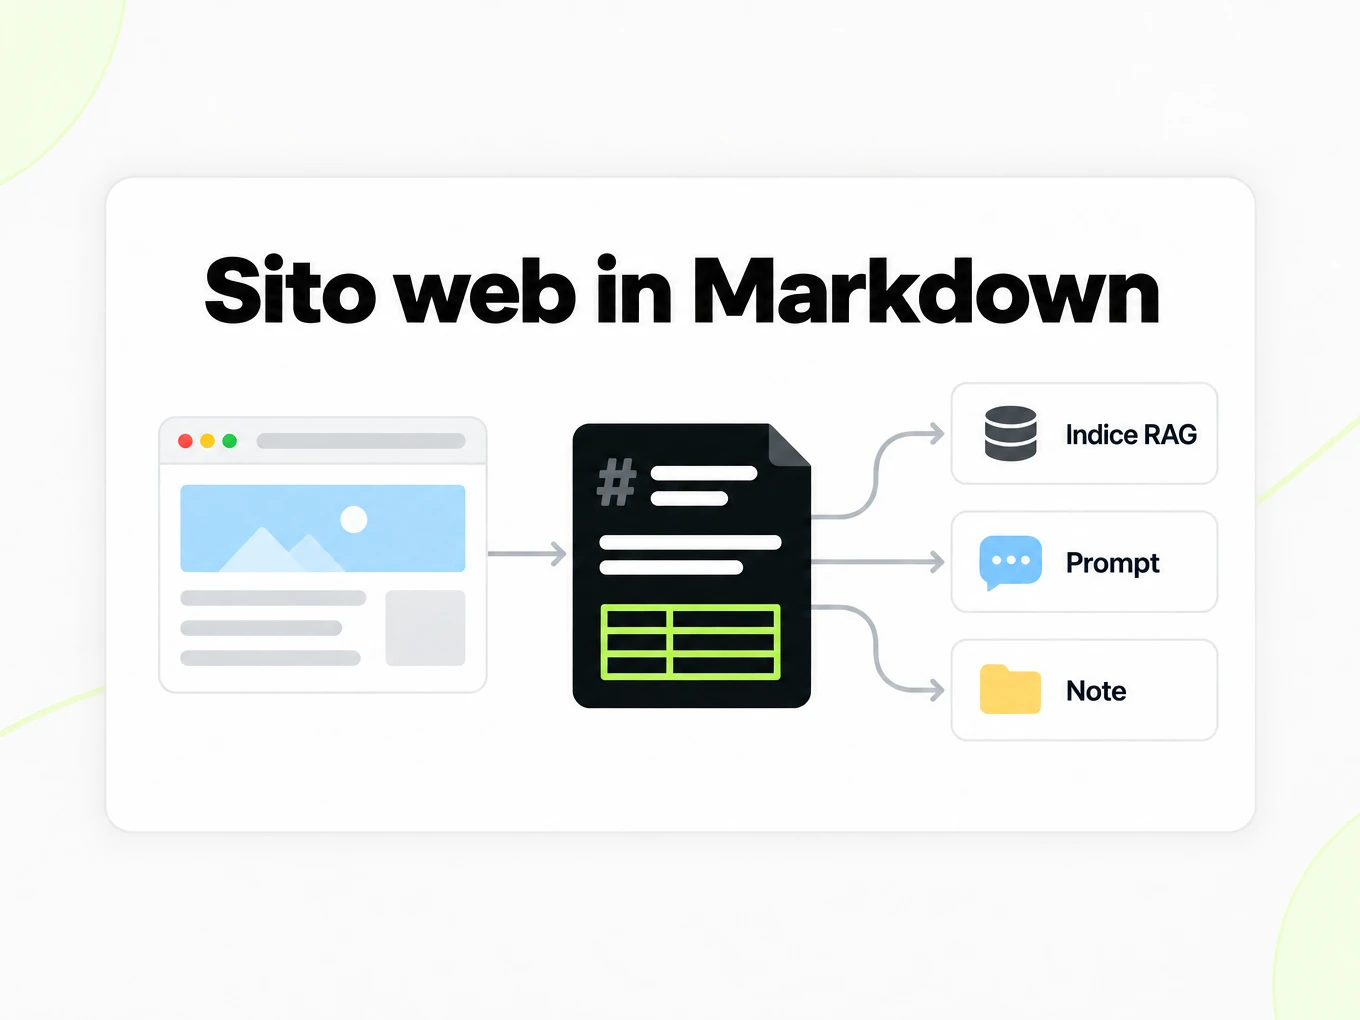
Alimenta indici RAG, strumenti per agenti e prompt con articoli e documentazione come testo pulito e con i titoli intatti, invece che con HTML grezzo.
Ricerca e note
Salva una fonte come Markdown per citarla, annotarla o conservarla in Obsidian o in un repository di note, con i link originali ancora al loro posto.
Team di contenuti
Sposta post e pagine di assistenza da un CMS a un altro, oppure porta materiale di riferimento in un sito di documentazione basato su Markdown.
Sviluppatori
Chiama l'API da job di ingestione e crawler che già esegui e ottieni lo stesso Markdown che mostra il convertitore nel browser.
API
API di URL in Markdown per sviluppatori
Converti pagine dal codice? Invia un solo URL — o fino a 20 in un array urls — a POST /v1/convert/url con la tua chiave API. Imposta render su auto, force o skip per controllare il rendering JavaScript, e frontmatter su true per inserire titolo della pagina, autore e data di pubblicazione nel front matter YAML. Il Markdown torna nella stessa risposta quando la pagina termina entro la finestra di attesa; altrimenti ottieni una conversione da interrogare o un webhook quando si conclude. L'accesso API è disponibile nei piani a pagamento.
Leggi la guida APIcurl -X POST https://api.markitdown.ai/v1/convert/url \ -H "x-api-key: mdai_…" \ -H "content-type: application/json" \ -d '{"url":"https://markitdown.ai/blog/why-pdfs-break-llms","frontmatter":true}'Guida
Controllare l'output
Controlla l'output di URL in Markdown accanto alla pagina pubblica che hai inviato. Il convertitore conserva il contenuto principale e lascia fuori navigazione, avvisi sui cookie e link di piè di pagina, ma una pagina senza un articolo chiaro — una pagina di prodotto, una landing page, una home page con molti teaser — può comunque perdere un pannello laterale o conservare un blocco che non citeresti. Controlla il primo e l'ultimo paragrafo rispetto alla pagina prima di indicizzare il risultato. Le pagine che costruiscono il loro contenuto con JavaScript vengono renderizzate prima in un browser; una pagina che carica il suo testo solo dopo un clic, uno scorrimento o un accesso non può comunque essere catturata. Quando un sito serve già il proprio Markdown ai client che lo richiedono, il convertitore usa quella versione se supera un controllo di qualità, e ricade sulla pagina HTML quando sembra un menu dell'intero sito o un archivio scaricato in blocco. Conserva l'URL di origine insieme al Markdown, così un lettore può tornare alla pagina originale.
Conservare il contesto di origine
Conserva l'URL inviato e la tua data di recupero insieme a un risultato di URL in Markdown nel tuo flusso di lavoro. Una pagina pubblica può cambiare dopo che l'hai convertita, quindi un visitatore successivo può vedere un passaggio rivisto. Con il front matter attivo, il risultato si apre con l'URL di origine, l'URL canonico, il titolo e — quando la pagina li dichiara — autore, data di pubblicazione, descrizione, nome del sito, lingua e immagine principale, letti dai meta tag, dai dati strutturati e dalla byline della pagina. Questi campi ripetono ciò che la pagina dichiara su se stessa; verificali alla fonte se la tua ricerca ne dipende. Il campo di metadati dell'API è diverso: porta solo il contesto che fornisci tu. Prima di citare una tabella o un paragrafo, confrontalo con la pagina e conserva abbastanza contesto circostante da non cambiarne il significato. Il Markdown rende il contenuto web più facile da riutilizzare; non stabilisce se la pagina è accurata né se hai il permesso di ripubblicarla.
HTML salvato o URL
Scegli il convertitore HTML quando possiedi già l'istantanea esatta della pagina che devi elaborare. Scegli URL in Markdown quando un indirizzo accessibile pubblicamente è l'input della conversione corrente. Sono flussi di lavoro correlati con controlli di origine diversi: un file salvato fissa l'input che invii e viene convertito per intero, mentre un URL dipende da ciò che il sito web restituisce al momento della richiesta e viene ridotto al suo contenuto principale. Nessuna delle due strade aggira le restrizioni di accesso. Se un sito nega il fetcher o richiede l'accesso, usa materiale che sei autorizzato a ottenere tramite un flusso di lavoro adeguato. Non ritentare ripetutamente un URL inaccessibile come se un altro tentativo di conversione concedesse l'accesso.
Ricerca con LLM
I ricercatori incollano una fonte, non un file. Questo convertitore scarica l'URL che invii, conserva il corpo dell'articolo o della documentazione e restituisce Markdown che puoi citare, suddividere o inserire in un archivio di note, con link che continuano a funzionare. Renderizza le pagine JavaScript quando il server invia un guscio vuoto, e non accede dietro i paywall.
- Sono supportati solo URL accessibili pubblicamente.
- Il fetcher si identifica; gli operatori possono negare lo user agent: vedi /docs/fetcher.
- I file HTML salvati vanno su /html-to-markdown, non qui.
Altri convertitori Markdown
- PDF → MarkdownTesto, tabelle e scansioni
- Word → MarkdownDOCX con titoli ed elenchi
- PPT → MarkdownTesto, note e tabelle delle diapositive
- Excel → MarkdownOgni foglio come tabella
- EPUB → MarkdownCapitoli di ebook come titoli
- Image → MarkdownOCR per scansioni e screenshot
- HTML → MarkdownIncolla o carica HTML
- Markdown → HTMLHTML pulito e semantico
- Markdown → TextTesto semplice senza markup
- Markdown → PDFStampa in PDF in locale
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
Domande su URL in Markdown
Come funziona URL in Markdown?
URL in Markdown scarica la pagina pubblica che incolli, ne conserva il contenuto principale e lo converte in Markdown con link a URL completi: non c'è alcun file da caricare. Le pagine che richiedono JavaScript vengono renderizzate prima in un browser.
Rimuove gli annunci e la navigazione da una pagina attiva?
Sì, per le pagine con un'area di contenuto principale chiara. URL in Markdown conserva l'articolo, il corpo della documentazione o la discussione e scarta menu, banner dei cookie e piè di pagina; una landing page o una pagina di prodotto senza un blocco principale unico può comunque conservare o perdere un pannello laterale, quindi controlla il risultato.
Ci sono limiti di dimensione per una pagina scaricata?
Il convertitore pubblico funziona con pagine web pubbliche. Le pagine scaricate sono soggette a limiti di dimensione della risposta e possono essere rifiutate se troppo grandi.
Funziona sulle pagine dietro un accesso?
No. Sono supportati solo URL accessibili pubblicamente. Le pagine dietro autenticazione, paywall o schermate di accesso non possono essere scaricate.
E le pagine renderizzate con JavaScript?
Le pagine renderizzate con JavaScript vengono renderizzate in un browser headless quando il primo HTML è un guscio vuoto, poi convertite come qualsiasi altra pagina. Tramite l'API, render impostato su force renderizza sempre e skip mai. Il testo che appare solo dopo un clic, uno scorrimento o un accesso non viene catturato.
Posso convertire più URL contemporaneamente?
Invia un array urls con fino a 20 URL pubblici a POST /v1/convert/url. Segui il risultato di ogni file e gestisci le risposte asincrone. Vedi /developers.
URL in Markdown è gratuito?
Sì. Visualizzare in anteprima e copiare il Markdown è gratuito senza account, fino a 3 conversioni all'ora e 10 al giorno; scaricare il file .md richiede l'accesso. Solo pagine web pubbliche (nessun URL interno o privato).
Quali contenuti conserva il convertitore?
Il convertitore conserva titoli, paragrafi, elenchi, link, immagini, tabelle e blocchi di codice del contenuto principale, con i link relativi riscritti in URL completi. Script, stili, navigazione e piè di pagina vengono scartati; con il front matter attivo, titolo della pagina, autore e data di pubblicazione vanno in cima.
Esiste un'API di conversione da URL?
Sì. Converti pagine web tramite URL a livello di codice con l'API REST. Vedi /developers. I file HTML salvati usano /html-to-markdown.
Converti URL in Markdown su larga scala.
Provalo gratis: non serve registrarsi.