
Convertitore
Convertire PDF in Markdown online
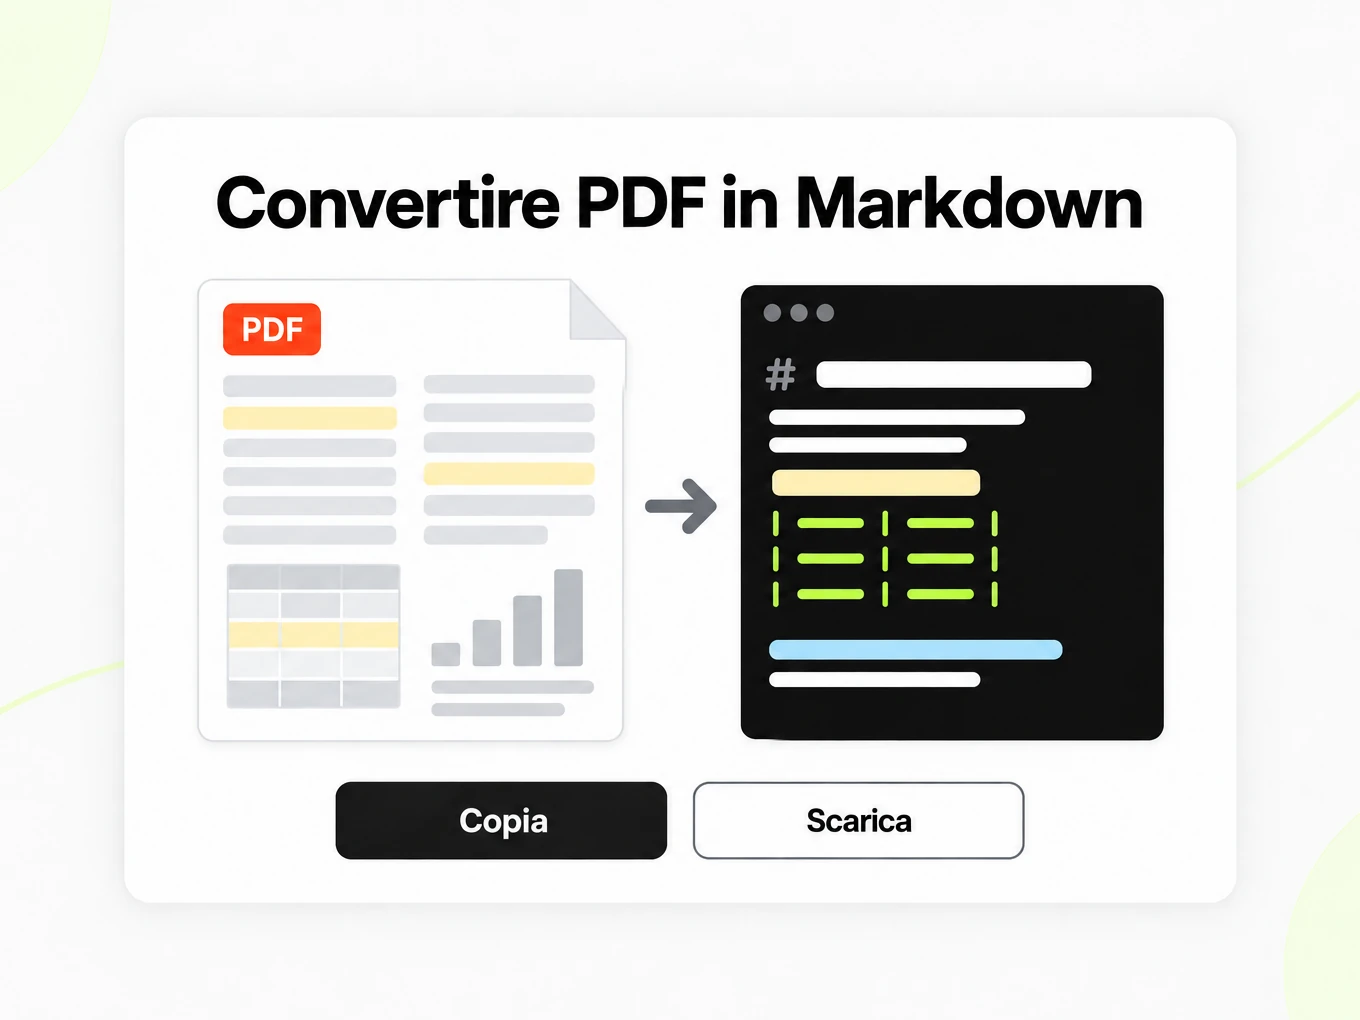
Convertire PDF in Markdown è un convertitore che ricostruisce l'ordine di lettura su più colonne in Markdown strutturato per il RAG ed è ideale per estrarre testo da PDF. La prova pubblica accetta file fino a 10 MB.
Prova un file prima di scegliere un piano.
- Senza account: fino a 10 MB e 25 pagine per file, 3 conversioni all'ora e 10 al giorno, con anteprima e copia nel browser.
- Con accesso: 20 conversioni gratuite al giorno, salvate nella tua libreria.
- Lite, Pro e Max includono crediti di conversione, elaborazione in batch, accesso API e cronologia salvata. Lite include 30 giorni di cronologia.
Come si fa
Come convertire PDF in Markdown
Cosa puoi caricare
- Tipi di file: .pdf
- Provalo senza account: fino a 10 MB e 25 pagine per file, 3 conversioni all'ora e 10 al giorno
- Lite supporta file fino a 100 MB e Pro fino a 200 MB
- Max non ha limiti di dimensione per file; le conversioni sono limitate dai crediti
Cosa controllare
- Ricostruzione dell'ordine di lettura — La conversione PDF tenta di ricostruire un ordine di lettura logico.
- Tabelle e titoli — I livelli dei titoli e i dati tabellari vengono conservati dove il PDF espone metadati strutturali; i PDF di solo testo producono un output di solo testo.
- PDF scansionati e solo immagine — I PDF senza livello di testo (pagine scansionate e immagini inserite) vengono elaborati oggi con l'OCR; la precisione dipende dalla qualità della scansione.
- File protetti da password — I PDF cifrati non possono essere analizzati; rimuovi la password prima di caricarli.
Dove va il Markdown
- Copia il Markdown direttamente dall'anteprima
- Scarica il file .md e conservalo nella tua libreria dopo l'accesso
- Converti intere cartelle o archivi ZIP con la conversione in batch
- Automatizzalo con POST /v1/convert/pdf e la tua chiave API
Perché usarlo
Perché usare PDF in Markdown
Report come testo leggibile
Trasforma i paragrafi e la struttura supportata di un report in Markdown che puoi ispezionare, modificare e conservare accanto al PDF di origine.
OCR per pagine scansionate
Le pagine di sole immagini possono essere riconosciute con l'OCR. Confronta testo piccolo, punteggiatura e tabelle numeriche con la scansione originale.
Contesto dei titoli
Conserva sezioni riconoscibili per appunti e flussi di recupero, verificando al tempo stesso se i titoli formattati visivamente sono stati interpretati correttamente.
Tabelle da rivedere
Le tabelle supportate diventano tabelle di testo. Controlla le celle complesse o unite prima di trattare i valori esportati come prova.
Anteprima prima del riutilizzo
Confronta il sorgente Markdown con la sua resa prima di copiare un passaggio in ChatGPT, Claude o un repository di documentazione.
Una rotta API ripetibile
Usa la rotta di conversione PDF in uno script di ingestione dopo aver revisionato in browser risultati rappresentativi.
Il problema
Perché le colonne di un PDF spezzano i modelli linguistici
Le colonne si interlacciano
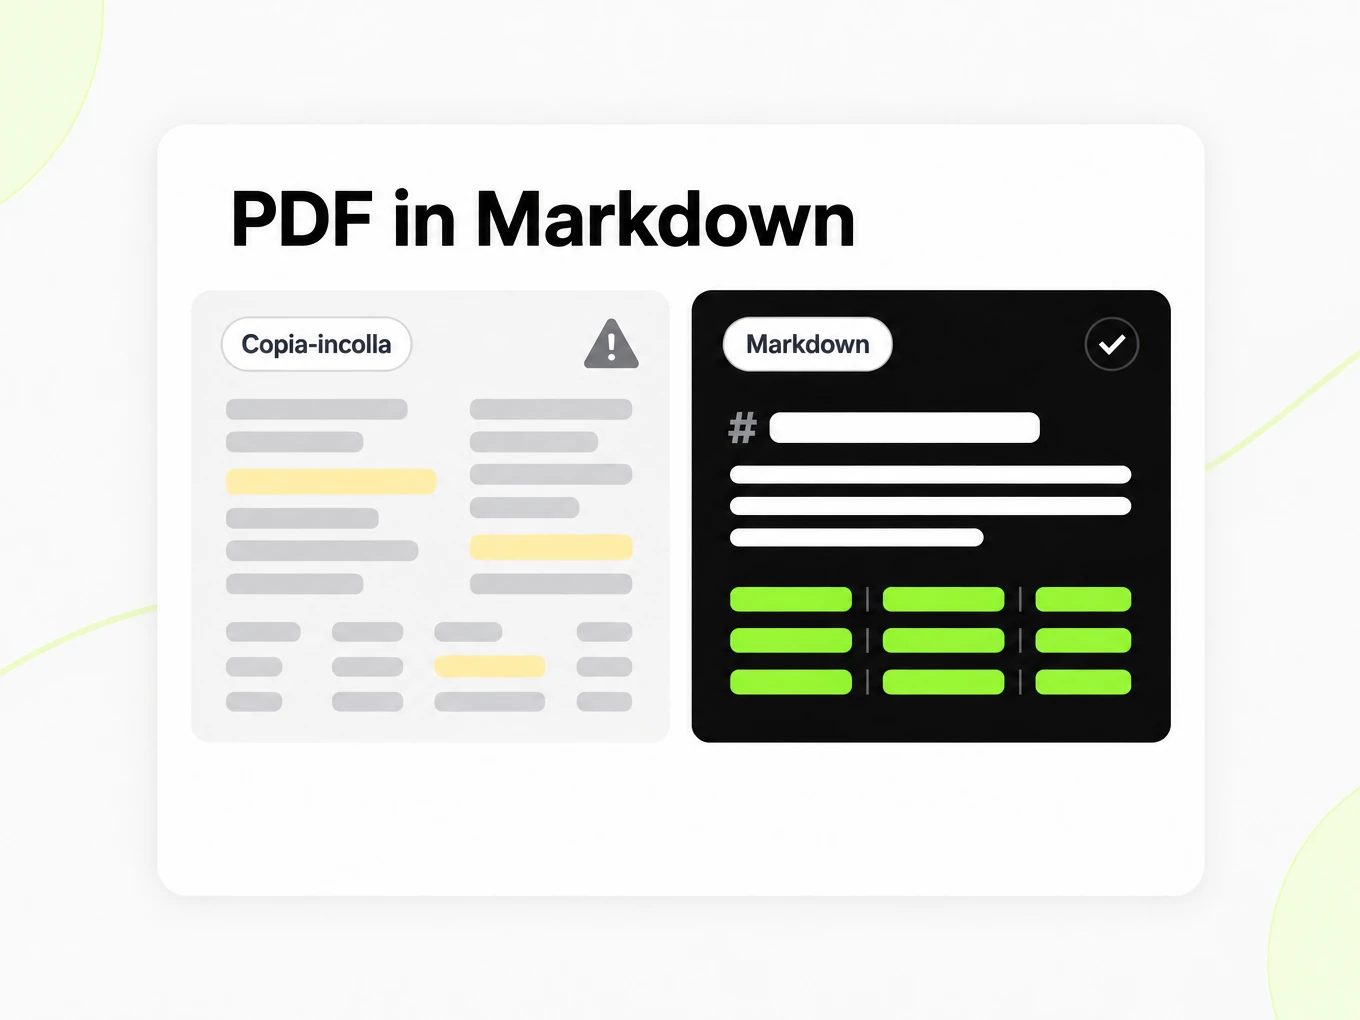
Un report a due colonne letto dall'alto verso il basso mescola il flusso di sinistra e quello di destra, così il modello vede una frase che non è mai esistita nella pagina.
Le tabelle perdono la griglia
Copiare e incollare da un PDF trasforma una tabella di risultati in una sequenza di numeri senza riga di intestazione per un parser a valle.
Le scansioni non hanno livello di testo
Le pagine solo immagine contengono pixel, non glifi, quindi oggi i PDF scansionati vengono elaborati con l'OCR.
Cosa viene conservato
Cosa conserva questo convertitore di PDF
- Ricostruzione dell'ordine di lettura
- La conversione PDF tenta di ricostruire un ordine di lettura logico. Confronta i passaggi tra le colonne con l'originale, soprattutto per report e articoli complessi.Source: ISO 32000-2 (PDF 2.0)
- Tabelle e titoli
- I livelli dei titoli e i dati tabellari vengono conservati dove il PDF espone metadati strutturali; i PDF di solo testo producono un output di solo testo.Source: CommonMark Spec
- PDF scansionati e solo immagine
- I PDF senza livello di testo (pagine scansionate e immagini inserite) vengono elaborati oggi con l'OCR; la precisione dipende dalla qualità della scansione.Source: product pipeline
- File protetti da password
- I PDF cifrati non possono essere analizzati; rimuovi la password prima di caricarli.Source: ISO 32000-2 (PDF 2.0)
Esempio: NIST Cybersecurity Framework 2.0, pagina 15· https://nvlpubs.nist.gov/nistpubs/CSWP/NIST.CSWP.29.pdf
## Appendix A. CSF Core This appendix describes the Functions, Categories, and Subcategories of the CSF Core. Table 1 lists the CSF 2.0 Core Function and Category names and unique alphabetic identifiers. Each Function name in the table is linked to its portion of the appendix. The order of Functions, Categories, and Subcategories of the Core is not alphabetical; it is intended to resonate most with those charged with operationalizing risk management within an organization. The numbering of the Subcategories is intentionally not sequential; gaps in numbering indicate CSF 1.1 Subcategories that were relocated in CSF 2.0. **Table 1. CSF 2.0 Core Function and Category names and identifiers** | Function | Category | Category Identifier || --- | --- | --- || **Govern (GV)** | Organizational Context | GV.OC || | Risk Management Strategy | GV.RM || | Roles, Responsibilities, and Authorities | GV.RR || | Policy | GV.PO || | Oversight | GV.OV || | Cybersecurity Supply Chain Risk Management | GV.SC || **Identify (ID)** | Asset Management | ID.AM || | Risk Assessment | ID.RA || | Improvement | ID.IM || **Protect (PR)** | Identity Management, Authentication, and Access Control | PR.AA || | Awareness and Training | PR.AT || | Data Security | PR.DS || | Platform Security | PR.PS || | Technology Infrastructure Resilience | PR.IR || **Detect (DE)** | Continuous Monitoring | DE.CM || | Adverse Event Analysis | DE.AE | Casi d'uso
PDF in Markdown nei flussi di lavoro reali
Note di ricerca
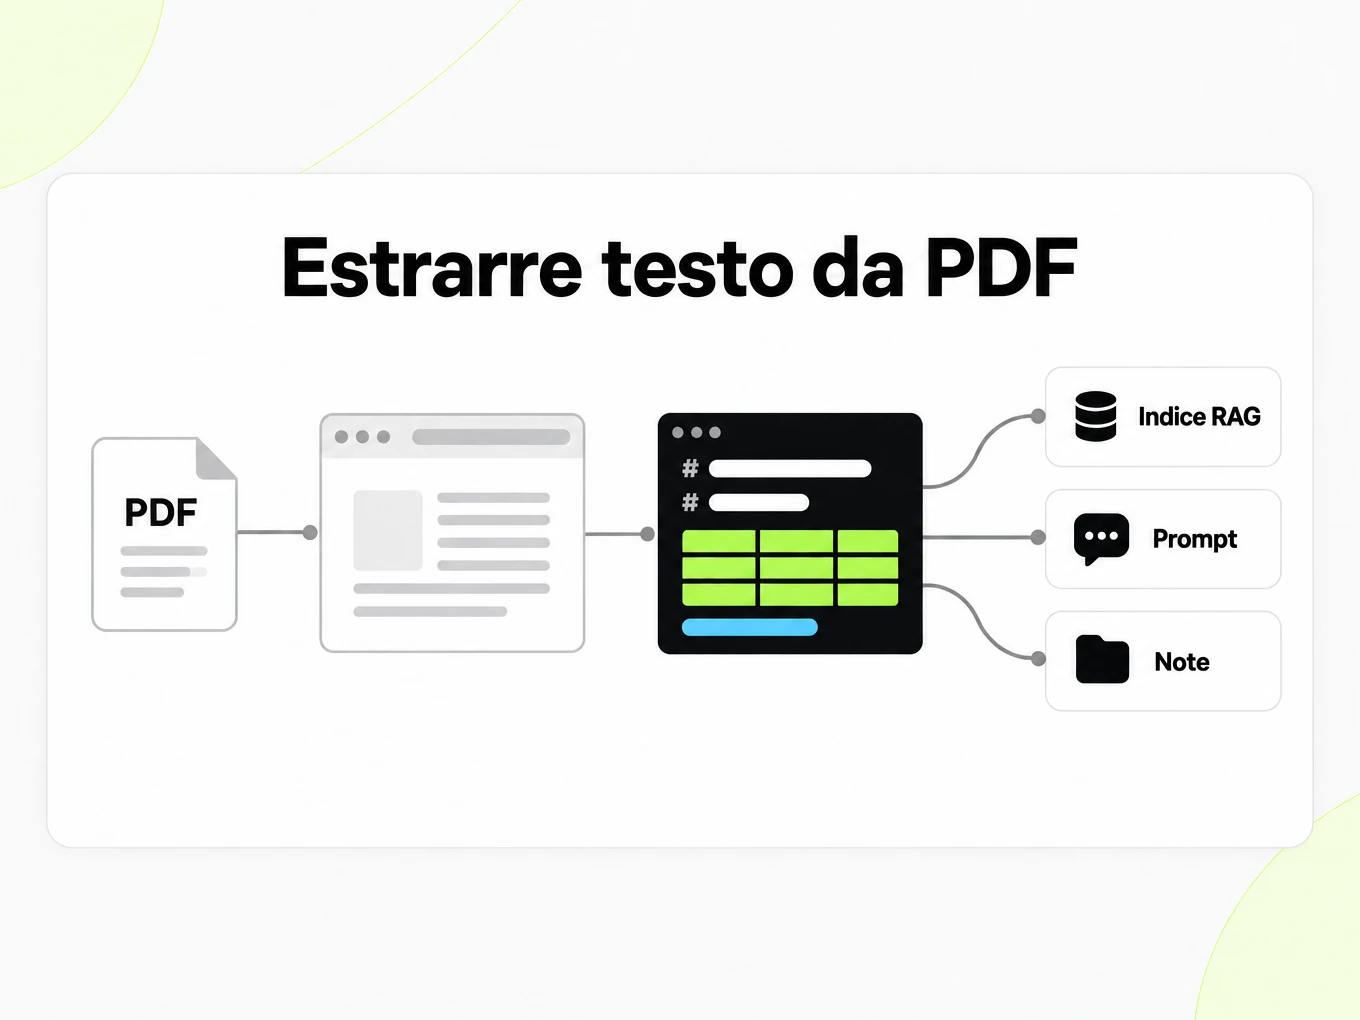
Estrai un articolo in note modificabili, verifica i passaggi citati e conserva il riferimento PDF per una revisione successiva.
Ingestione di report
Prepara i report per la suddivisione in blocchi conservando intestazioni di tabella, contesto di sezione e un link al documento originale.
Biblioteche di policy
Converti una policy revisionata in testo ricercabile e conserva il PDF pubblicato come versione autorevole.
Valutazione di documenti
Confronta PDF rappresentativi prima di automatizzare una raccolta, incluse scansioni, colonne e una tabella difficile.
API
PDF in Markdown API
Usa POST /v1/convert/pdf con un'intestazione x-api-key e un file di origine supportato. Una richiesta completata può restituire gli output in linea; un HTTP 202 significa che la conversione è ancora in corso. Leggi l'intestazione Location della risposta e interrogala prima di accedere ai file di output. Una richiesta multipart accetta al massimo 100 file; si applicano anche i limiti di abbonamento e di richieste totali. Conserva le chiavi API nell'ambiente del tuo server. L'accesso all'API richiede un abbonamento Lite, Pro o Max.
Leggi la guida APIcurl -i "https://api.markitdown.ai/v1/convert/pdf" \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F "file=@source.pdf"# If HTTP 202, GET the Location URL with the same API key.Guida
Rivedere il risultato
Controlla il risultato di PDF in Markdown rispetto al PDF originale prima di usarlo come prova. Inizia da una pagina con colonne, una nota a piè di pagina e una tabella invece di una semplice copertina. Leggi l'ultima frase di una colonna e la prima di quella successiva: dovrebbero formare la stessa sequenza che una persona segue nel PDF. Poi confronta un'intestazione di tabella, un valore negativo e un'unità. Un'anteprima Markdown leggibile può comunque contenere una sostituzione OCR o una cella fuori posto. Se il documento orienta una decisione finanziaria o tecnica, conserva il PDF accanto al Markdown e verifica il passaggio che intendi citare. La conversione semplifica il lavoro sul testo; non certifica la fonte né la sua trascrizione.
Cosa cambia con Convertire PDF in Markdown
Convertire PDF in Markdown sostituisce il posizionamento visivo con una struttura testuale. Un titolo grande può diventare un indicatore di titolo, i paragrafi restano paragrafi e una tabella supportata diventa righe separate da pipe. La geometria della pagina, le righe decorative, la scelta dei font e l'originale ritorno a capo non fanno parte del contratto di output. È utile quando vuoi modificare un estratto o costruire un indice di recupero, ma non è adatto quando l'obiettivo è riprodurre esattamente un opuscolo. Conserva il PDF originale per il suo layout autorevole. Quando un layout non può essere rappresentato con una semplice tabella Markdown, valuta se una breve spiegazione o una tabella rivista a mano sia la rappresentazione a valle più chiara.
Fonti per RAG
Usa il titolo del PDF e titoli di sezione significativi per conservare il contesto quando dividi il Markdown in passaggi. Un blocco intitolato solo Risultati può risultare ambiguo quando esce dal documento; il tuo codice di ingestione può conservare il nome del documento e il titolo padre insieme a quel passaggio. Mantieni un'intestazione di tabella insieme alle sue righe ed evita di spezzare un elenco a metà di una condizione. Archivia separatamente il riferimento al PDF originale, così una risposta recuperata può riportare il lettore alla fonte. LangChain e LlamaIndex possono consumare il testo dal tuo processo di ingestione, ma scegliere lo splitter, il modello di embedding e la policy di recupero resta compito della tua applicazione. Prova il recupero con domande le cui risposte hai verificato nel PDF.
Scegliere il PDF
Preferisci il PDF originale esportato quando contiene testo leggibile. Uno screenshot di quel PDF aggiunge un ulteriore passaggio di riconoscimento dell'immagine e può perdere caratteri piccoli prima che inizi la conversione. Per i PDF scansionati, raddrizza le pagine ruotate e usa una versione in cui punteggiatura e bordi delle tabelle restino leggibili a uno zoom normale. Rimuovi la password prima di caricare un PDF cifrato. Se solo una parte di un lungo report è rilevante, prepara le pagine di origine pertinenti e conserva il loro riferimento originale nei tuoi appunti. Ripetere la stessa scansione danneggiata difficilmente correggerà il dettaglio mancante; migliora prima la fonte, poi confronta il nuovo output di PDF in Markdown con il risultato precedente.
Confini dei chunk
La qualità del recupero dipende da confini dei chunk che corrispondano al documento che leggerebbe una persona. Questo convertitore riordina le colonne e conserva i livelli dei titoli, così uno splitter può produrre passaggi invece di frammenti interlacciati di un articolo a due colonne.
- Usa il Markdown come artefatto da suddividere e indicizzare, non come un dump di testo appiattito.
- Le pagine standard e le pagine OCR vengono fatturate a 1 credito per pagina nei piani con accesso effettuato.
- I file protetti da password devono essere sbloccati prima del caricamento; i PDF cifrati vengono rifiutati.
Altri convertitori Markdown
- Word → MarkdownDOCX con titoli ed elenchi
- PPT → MarkdownTesto, note e tabelle delle diapositive
- Excel → MarkdownOgni foglio come tabella
- Image → MarkdownOCR per scansioni e screenshot
- HTML → MarkdownIncolla o carica HTML
- URL → MarkdownQualsiasi pagina web pubblica, pulita
- Markdown → HTMLHTML pulito e semantico
- Markdown → TextTesto semplice senza markup
- Markdown → PDFStampa in PDF in locale
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
Domande su Convertire PDF in Markdown
Come funziona Convertire PDF in Markdown?
Convertire PDF in Markdown trasforma la fonte supportata in Markdown leggibile da rivedere e riutilizzare. La prova anonima accetta fino a 10 MB e 25 pagine per file, con 3 conversioni per IP all'ora e 10 al giorno. Confronta il risultato con la fonte prima di usarlo.
Qual è la dimensione massima di un PDF?
Il convertitore pubblico accetta file PDF fino a 10 MB. Lite supporta file fino a 100 MB; Pro e Max hanno limiti più alti.
Gestisce i PDF scansionati?
Sì. I PDF basati su immagine vengono elaborati oggi con l'OCR; le scansioni nitide e ad alta risoluzione danno i risultati migliori.
Gli articoli di ricerca su più colonne sono gestiti?
Sì. Convertire PDF in Markdown tenta di ricostruire l'ordine di lettura. Confronta i passaggi tra le colonne con la fonte, perché i layout complessi possono comunque richiedere correzioni.
Le tabelle finanziarie sopravvivono?
Le tabelle nei PDF che contengono metadati strutturali vengono convertite in tabelle Markdown. Le tabelle in immagine appiattita richiedono l'OCR per essere recuperate.
Posso convertire PDF protetti da password?
No. I PDF cifrati non possono essere analizzati. Rimuovi la password prima di caricarli.
L'output è abbastanza buono per essere suddiviso per il RAG?
Il Markdown conserva titoli, elenchi e tabelle dove possibile, così la suddivisione in chunk e l'indicizzazione restano prevedibili rispetto a copiare e incollare.
Posso convertire PDF dal codice?
Sì. Usa una chiave API per inviare il file direttamente a /v1/convert/pdf e leggere il Markdown nella risposta. Vedi /developers.
Converti PDF in Markdown su larga scala.
Provalo gratis: non serve registrarsi.