
轉換器
PDF 轉 Markdown
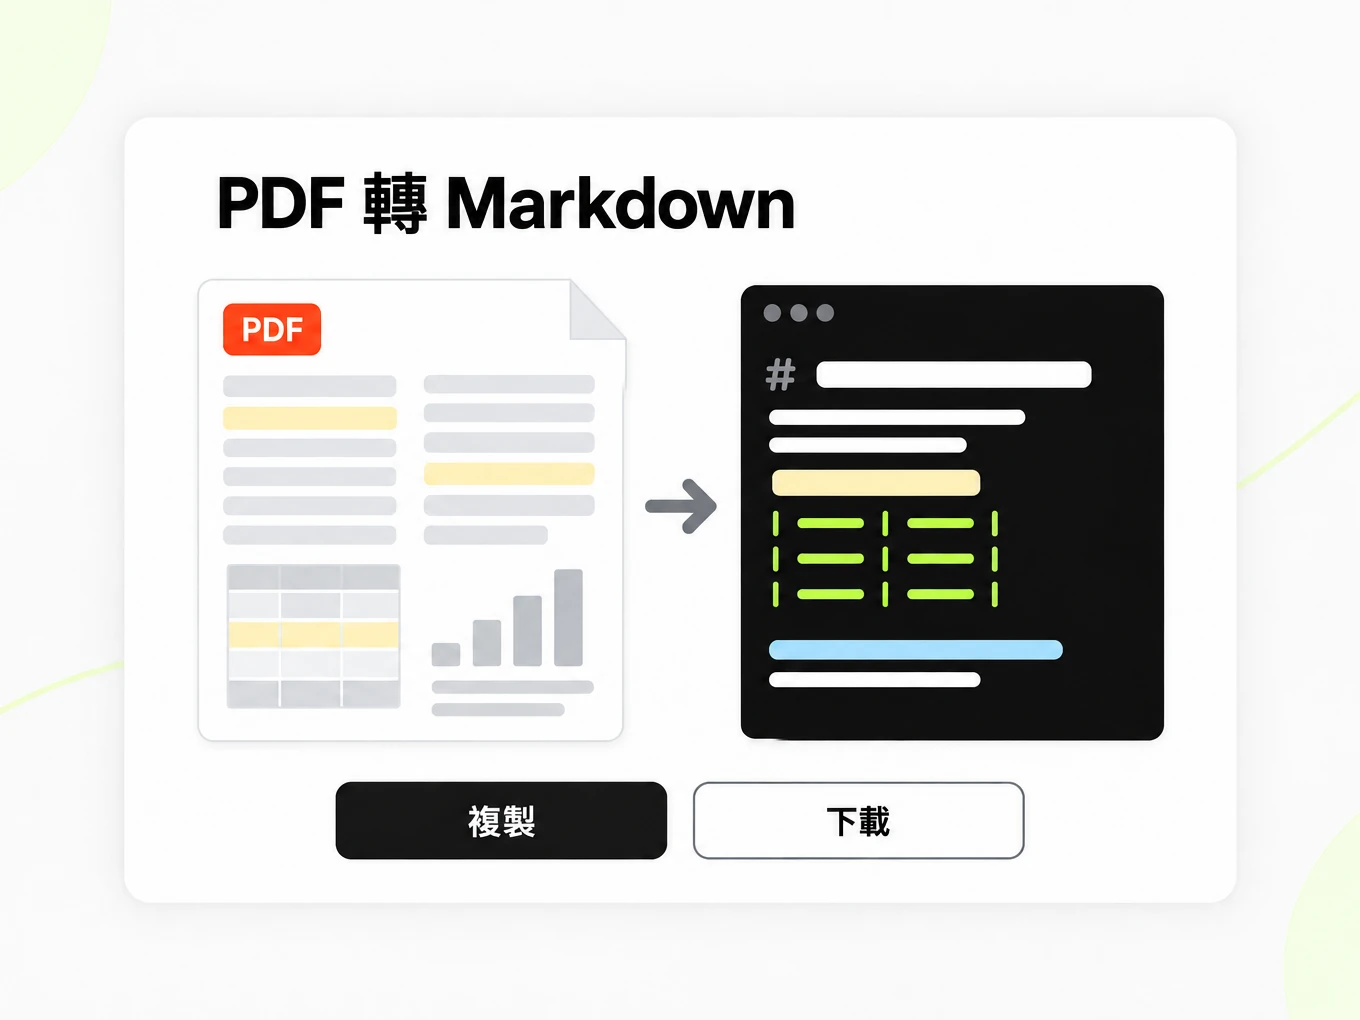
PDF 轉 Markdown 是一款把 PDF 轉文字與表格重建為結構化 Markdown 的轉換器,適合 RAG。匿名試用接受最大 10 MB 的檔案。
如何操作
如何把 PDF 轉 Markdown
可以上傳什麼
- 檔案類型:.pdf
- 無需帳號即可試用:單檔案最大 10 MB、25 頁,每小時 3 次、每天 10 次轉換
- Lite 支援最大 100 MB 的檔案,Pro 支援 200 MB
- Max 沒有單檔案大小上限;轉換量由 credit 限制
需要檢查什麼
- 閱讀順序重建 —— PDF 轉換會嘗試重建邏輯閱讀順序。請對照原始檔案檢查分欄處,尤其是複雜的報告和論文。
- 表格與標題 —— 當 PDF 暴露結構中繼資料時,標題層級和表格資料會被保留;純文字 PDF 產出純文字輸出。
- 掃描版和純圖片 PDF —— 沒有文字層的 PDF(掃描頁和插入的圖片)目前用 OCR 處理;準確度取決於掃描品質。
- 受密碼保護的檔案 —— 加密 PDF 無法解析;請在上傳前移除密碼。
Markdown 的去向
- 直接從預覽中複製 Markdown
- 下載 .md 檔案;登入後會儲存到你的文件庫
- 用批次轉換處理整個資料夾或 ZIP 壓縮包
- 用 POST /v1/convert/pdf 和你的 API key 自動完成
為什麼使用
為什麼使用 PDF 轉 Markdown
報告變成可讀文字
把報告的段落和受支援的結構變成 Markdown,便於檢查和編輯,並與源 PDF 並列儲存。
掃描頁走 OCR
純圖片頁面可以用 OCR 辨識。把小字、標點和數字表格與原始掃描件對照。
保留標題上下文
為筆記和檢索工作流保留可辨識的章節,同時檢查視覺化的標題是否被正確解讀。
表格待複核
受支援的表格會變成文字表格。在把匯出的值當作證據前,先檢查複雜或合併的儲存格。
複用前先預覽
在把段落複製進 ChatGPT、Claude 或文件倉庫前,把 Markdown 原始碼與它的渲染檢視對照。
可重複呼叫的 API 路徑
在瀏覽器裡複核代表性輸出後,把 PDF 轉換路徑用於你的攝取指令碼。
問題所在
為什麼 PDF 文字辨識與分欄會難住語言模型
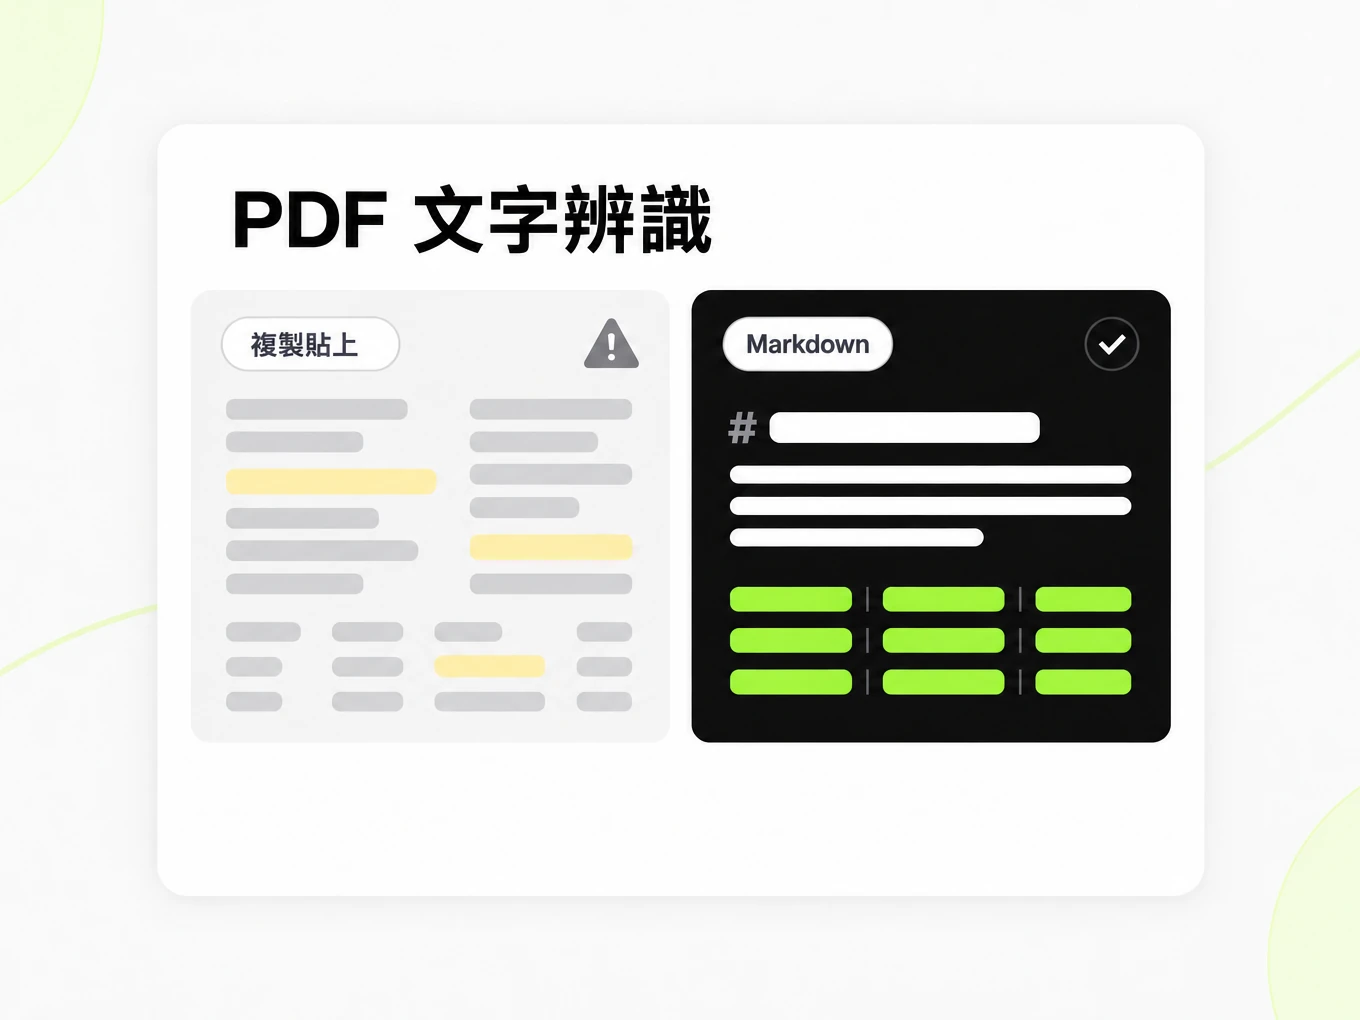
分欄交錯
雙欄報告按自上而下閱讀會混合左右兩股文字,於是模型看到一句在頁面上從未出現過的話。
表格丟失網格
從 PDF 複製貼上,會把一張結果表變成一串數字,下游解析器拿不到表頭行。
掃描件沒有文字層
純圖片頁面攜帶的是像素,不是字形,所以掃描版 PDF 目前用 OCR 處理。
保留什麼
這款 PDF 轉換器保留什麼
- 閱讀順序重建
- PDF 轉換會嘗試重建邏輯閱讀順序。請對照原始檔案檢查分欄處,尤其是複雜的報告和論文。Source: ISO 32000-2 (PDF 2.0)
- 表格與標題
- 當 PDF 暴露結構中繼資料時,標題層級和表格資料會被保留;純文字 PDF 產出純文字輸出。Source: CommonMark Spec
- 掃描版和純圖片 PDF
- 沒有文字層的 PDF(掃描頁和插入的圖片)目前用 OCR 處理;準確度取決於掃描品質。Source: product pipeline
- 受密碼保護的檔案
- 加密 PDF 無法解析;請在上傳前移除密碼。Source: ISO 32000-2 (PDF 2.0)
示例:NIST Cybersecurity Framework 2.0,第 15 頁· https://nvlpubs.nist.gov/nistpubs/CSWP/NIST.CSWP.29.pdf
## Appendix A. CSF Core This appendix describes the Functions, Categories, and Subcategories of the CSF Core. Table 1 lists the CSF 2.0 Core Function and Category names and unique alphabetic identifiers. Each Function name in the table is linked to its portion of the appendix. The order of Functions, Categories, and Subcategories of the Core is not alphabetical; it is intended to resonate most with those charged with operationalizing risk management within an organization. The numbering of the Subcategories is intentionally not sequential; gaps in numbering indicate CSF 1.1 Subcategories that were relocated in CSF 2.0. **Table 1. CSF 2.0 Core Function and Category names and identifiers** | Function | Category | Category Identifier || --- | --- | --- || **Govern (GV)** | Organizational Context | GV.OC || | Risk Management Strategy | GV.RM || | Roles, Responsibilities, and Authorities | GV.RR || | Policy | GV.PO || | Oversight | GV.OV || | Cybersecurity Supply Chain Risk Management | GV.SC || **Identify (ID)** | Asset Management | ID.AM || | Risk Assessment | ID.RA || | Improvement | ID.IM || **Protect (PR)** | Identity Management, Authentication, and Access Control | PR.AA || | Awareness and Training | PR.AT || | Data Security | PR.DS || | Platform Security | PR.PS || | Technology Infrastructure Resilience | PR.IR || **Detect (DE)** | Continuous Monitoring | DE.CM || | Adverse Event Analysis | DE.AE | 使用場景
PDF 轉 Markdown 的真實工作流
研究筆記
把論文提取成可編輯的筆記,核對引用段落,並保留 PDF 引用以備後續複核。
報告攝取
為切分準備報告,同時保留表頭、章節上下文和指向原始文件的連結。
政策庫
把複核過的政策轉成可搜尋文字,並把已發布的 PDF 保留為權威版本。
文件評估
在自動化整個集合前比較有代表性的 PDF,包括掃描件、分欄和一張棘手的表格。
API
PDF 轉 Markdown API
用 POST /v1/convert/pdf,帶上 x-api-key 請求標頭和受支援的原始檔。已完成的請求可以內嵌返回輸出;HTTP 202 表示轉換仍在進行。讀取 Location 回應標頭並在存取檔案輸出前輪詢它。一次 multipart 請求最多接受 100 個檔案;訂閱額度和總請求限額同樣適用。把 API 金鑰放在你的伺服器環境裡。API 存取需要 Lite、Pro 或 Max 訂閱。
閱讀 API 指南curl -i "https://api.markitdown.ai/v1/convert/pdf" \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F "file=@source.pdf"# If HTTP 202, GET the Location URL with the same API key.指南
檢查輸出結果
在把 PDF 轉 Markdown 的輸出當作依據之前,先拿它和原始 PDF 對照。從一頁同時包含分欄、腳註和表格的頁面開始,而不是簡單的標題頁。讀一欄的最後一句和下一欄的第一句:它們應當連成人在 PDF 裡讀到的同一順序。再對照一個表頭、一個負值和一個單位。一份可讀的 Markdown 預覽仍可能包含 OCR 替換錯誤或錯位的儲存格。如果這份文件要支撐財務或技術決策,請把 PDF 與 Markdown 一併保留,並核對打算引用的段落。轉換讓文字更好處理,但它並不為來源或其轉錄背書。
有哪些變化
PDF 轉 Markdown 用文字結構取代視覺定位。大標題可能變成標題標記,段落變成段落,受支援的表格變成用豎線分隔的行。頁面幾何、裝飾線、字型選擇和原始換行都不是輸出的約定。當你想編輯摘錄或建構檢索索引時,這很有用;但當目標是精確復刻一本宣傳冊時,它並不合適。若要保留權威版式,請留存原始 PDF。當某個版式無法用簡單的 Markdown 表格表達時,請考慮一段簡短說明或人工核對過的表格是否是更清晰的呈現方式。
RAG 素材
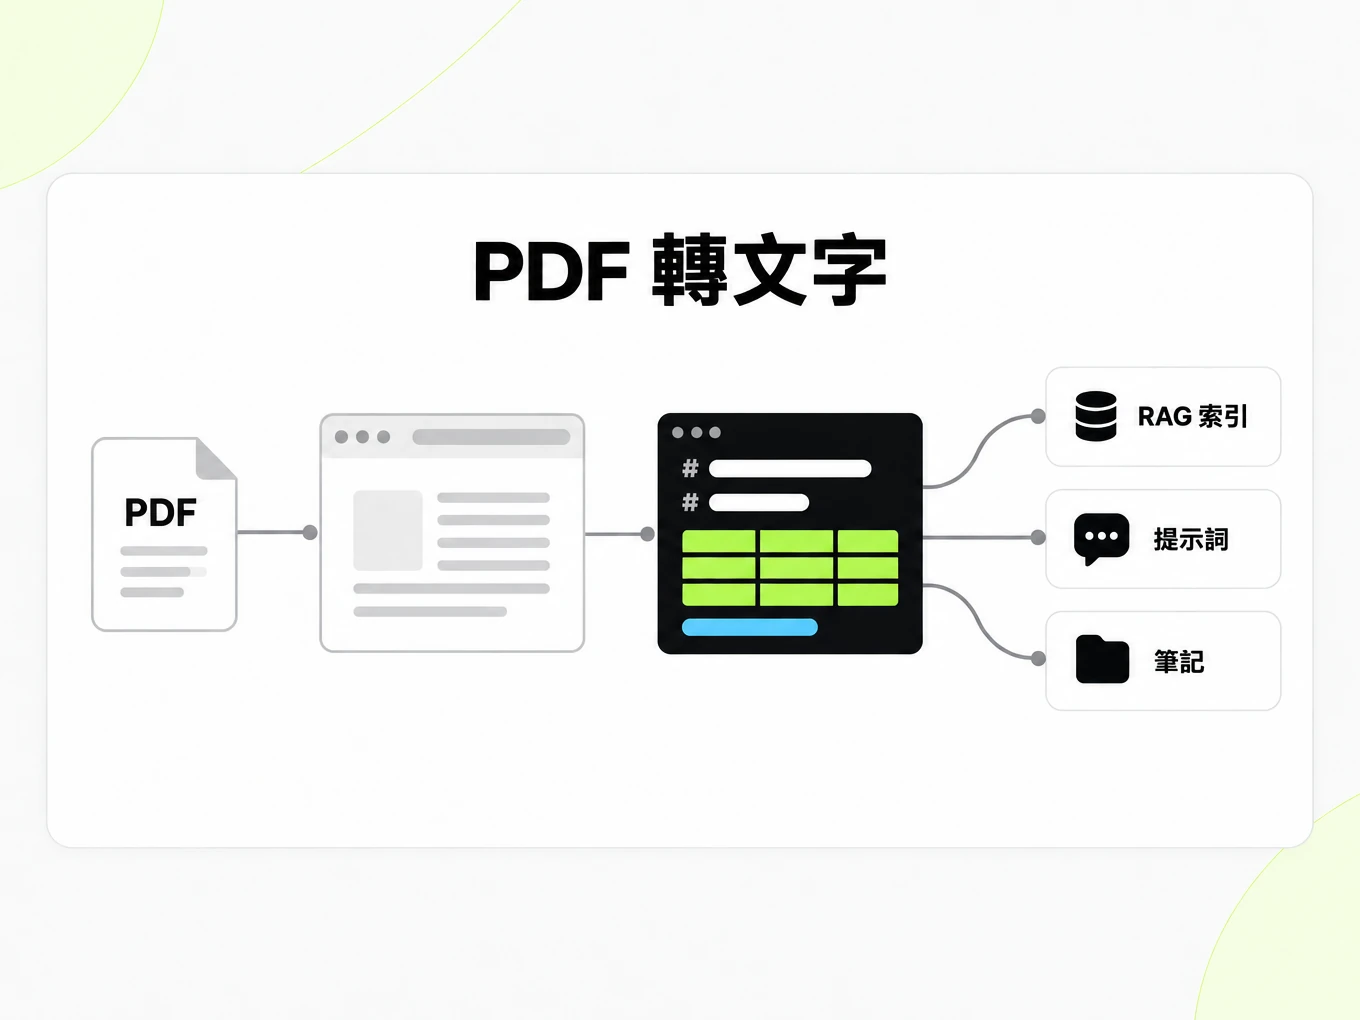
把 Markdown 切分成段落時,用 PDF 標題和有意義的章節標題來保留上下文。一個只以 Results 為標題的分塊在離開文件後可能有歧義;你的攝取程式碼可以把檔名和父級標題與該段落一起保留。讓表頭與它的行待在一起,也不要把一個列表從限定條件處截斷。單獨儲存原始 PDF 的引用,這樣檢索到的答案能把讀者帶回來源。LangChain 和 LlamaIndex 可以消費你自己攝取流程產出的文字,但選擇切分器、嵌入模型和檢索策略仍是你應用本身的工作。用你已在 PDF 裡核對過答案的問題來測試檢索。
如何挑選 PDF
只要原始 PDF 匯出含可讀文字,就優先用它。對該 PDF 截圖會引入額外的影像辨識步驟,可能在轉換開始前就丟失細小文字。對掃描版 PDF,先把旋轉的頁面擺正,並使用在正常縮放下標點和表格邊框仍清晰可辨的版本。上傳加密 PDF 前先移除密碼。如果長報告裡只有一部分相關,就準備相關的源頁,並在筆記裡保留它們的原始引用。反覆重試同一份損壞的掃描件不太可能補回缺失的細節;先改善來源,再把新的 PDF 轉 Markdown 輸出與此前的結果對照。
分塊邊界
檢索品質取決於與人類閱讀的文件相匹配的分塊邊界。這款轉換器會重排分欄並保留標題層級,好讓切分器產出一個個段落,而不是雙欄論文裡交錯的碎片。
- 把 Markdown 當作你切分和嵌入的產物,而不是一堆拍平的文字。
- 在有帳號的套餐裡,標準頁和 OCR 頁按每頁 1 credit 計費。
- 受密碼保護的檔案必須先解鎖再上傳;加密 PDF 會被拒絕。
更多 Markdown 轉換器
- Word → Markdown保留標題與列表的 DOCX
- PPT → Markdown幻燈片文字、備註與表格
- Excel → Markdown每個工作表一張表
- Image → Markdown掃描件與截圖的 OCR
- HTML → Markdown貼上或上傳 HTML
- URL → Markdown任意公開網頁,清理後輸出
- Markdown → HTML乾淨、語義化的 HTML
- Markdown → Text去掉標記的純文字
- Markdown → PDF本機列印為 PDF
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
PDF 轉 Markdown 常見問題
PDF 轉 Markdown 是怎麼工作的?
PDF 轉 Markdown 把受支援的來源轉換成可讀的 Markdown,便於複核和複用。匿名試用接受每個檔案最大 10 MB、25 頁,每個 IP 每小時 3 次轉換、每天 10 次。使用前請把結果與來源對照。
PDF 最大能有多大?
公開轉換器接受最大 10 MB 的 PDF 檔案。Lite 支援最大 100 MB 的檔案;Pro 和 Max 有更高的上限。
它處理掃描版 PDF 嗎?
處理。基於圖片的 PDF 目前用 OCR 辨識;乾淨、高解析度的掃描件效果最好。
多欄研究論文能處理嗎?
能。PDF 轉 Markdown 會嘗試重建閱讀順序。請把分欄處與來源對照,因為複雜版式仍可能需要人工修正。
財務表格能保留下來嗎?
帶有結構中繼資料的 PDF 表格會轉換成 Markdown 表格。拍平成圖片的表格需要 OCR 來恢復。
可以轉換受密碼保護的 PDF 嗎?
不可以。加密 PDF 無法解析。請在上傳前移除密碼。
輸出品質足以切分後用於 RAG 嗎?
Markdown 會在可能的情況下保留標題、列表和表格,因此與複製貼上相比,切分和嵌入更可預測。
可以從程式碼裡轉換 PDF 嗎?
可以。用 API 金鑰把檔案 POST 到 /v1/convert/pdf,再從回應裡讀回 Markdown。見 /developers。