
轉換器
URL 轉 Markdown 轉換器
URL 轉 Markdown 轉換器把公開可存取的網頁變成乾淨、結構化的 Markdown,可直接用於 LLM、RAG 流程和筆記。試用無需註冊;試用允許每個 IP 每小時 3 次轉換、每天 10 次。
如何操作
如何把網頁轉成 Markdown
可以貼上什麼
- 任意公開的 http(s) 頁面 —— 文章、文件、部落格文章
- 需要登入或位於付費牆後的頁面無法抓取
- 頁面在我們的伺服器上抓取,不會執行其 JavaScript
- 無需帳號即可試用:單檔案最大 10 MB、25 頁,每小時 3 次、每天 10 次轉換
需要檢查什麼
- 服務端抓取 —— 頁面在服務端被抓取,然後像 HTML 檔案一樣被轉換;無需瀏覽器外掛或本機工具。
- 僅限公開頁面 —— 位於身分驗證、付費牆或登入牆之後的頁面無法抓取。只支援公開可存取的 URL。
- 依賴 JavaScript 的頁面 —— 嚴重依賴客戶端 JavaScript 渲染內容的頁面可能無法完整轉換,因為抓取器接收的是初始的服務端渲染 HTML。
- 大小與身分 —— 抓取的頁面受回應大小限制限制,過大時會被拒絕。抓取器的 user agent 記錄在 /docs/fetcher。
Markdown 的去向
- 直接從預覽中複製 Markdown
- 下載 .md 檔案;登入後會儲存到你的文件庫
- 在 POST /v1/convert/url 上用 urls 陣列一次轉換多個頁面
- 用 POST /v1/convert/url 和你的 API key 自動完成
為什麼使用
為什麼使用這款 URL 轉 Markdown 轉換器
網頁是寫給瀏覽器看的。Markdown 是寫給人看、給模型讀的。這款轉換器保留承載含義的部分,丟掉它們周圍的標記。
能留存下來的結構
標題、列表、連結、表格和程式碼塊都以 Markdown 形式呈現,頁面仍然像一個大綱一樣可讀。
抓取公開頁面
文章、文件、部落格和產品頁。頁面在服務端抓取——無需安裝擴充功能或本機工具。
免費試用,無需登入
無需帳號即可預覽並複製 Markdown,每小時最多 3 次轉換、每天 10 次。登入後可下載 .md 檔案。
預覽或原始原始碼
在把內容複製進提示詞、筆記庫或程式碼倉庫前,在渲染後的 Markdown 和它的原始文字之間切換。
有禮、表明身分的抓取器
每次請求都會用有文件記錄的 user agent 表明身分,網站擁有者可以阻擋它——見文件裡的抓取器頁面。
與 API 同一套引擎
本頁的轉換器和 POST /v1/convert/url 執行同一份程式碼,所以指令碼每次呼叫最多可轉換 20 個 URL。
問題所在
為什麼線上頁面對模型來說很嘈雜
頁面很嘈雜
線上網頁把內容埋在導航、廣告、橫幅和指令碼之下。
標記很亂
手寫和生成的 HTML 很少能幹淨地對應為可讀結構。
AI 需要的是文章
RAG 和 agent 想要的是文章本身,而不是它周圍的頁面外殼——而且它們想要一個 URL,而不是手動儲存。
保留什麼
這款 URL 轉換器抓取什麼
- 服務端抓取
- 頁面在服務端被抓取,然後像 HTML 檔案一樣被轉換;無需瀏覽器外掛或本機工具。Source: RFC 9110: HTTP Semantics
- 僅限公開頁面
- 位於身分驗證、付費牆或登入牆之後的頁面無法抓取。只支援公開可存取的 URL。Source: RFC 9110: HTTP Semantics
- 依賴 JavaScript 的頁面
- 嚴重依賴客戶端 JavaScript 渲染內容的頁面可能無法完整轉換,因為抓取器接收的是初始的服務端渲染 HTML。Source: HTML Living Standard
- 大小與身分
- 抓取的頁面受回應大小限制限制,過大時會被拒絕。抓取器的 user agent 記錄在 /docs/fetcher。Source: product pipeline
示例:透過 URL 抓取 markitdown.ai 部落格文章· https://markitdown.ai/blog/why-pdfs-break-llms
# Why PDFs break LLMs — and what clean Markdown fixes Jun 12, 2026 · The markitdown.ai team · 3 min read A PDF renders perfectly for a human and falls apart the moment a model reads it. The page you see — columns, tables, headers, footnotes — is a *visual* arrangement, not a logical one. When you pull raw text out of it, that visual order rarely survives, and whatever you feed a language model is only as good as the text it actually receives. ## What actually goes wrong When teams pipe documents straight into an LLM or a retrieval index, a few failure modes show up again and again: - **Reading order breaks.** Multi-column layouts interleave. A two-column page becomes "line 1 left, line 1 right, line 2 left, line 2 right…", so a sentence a human reads top-to-bottom arrives at the model scrambled.- **Tables collapse.** Copy-paste turns a table into a loose run of numbers. The relationship between a header and its cell — the entire point of a table — is gone.- **Headings disappear.** The visual hierarchy (this is a section, this is a subsection) is encoded as font size and weight, not structure. Strip the styling and you get one undifferentiated wall of text.- **Noise creeps in.** Page numbers, running headers, hyphenated line breaks, and stray ligatures end up inline, polluting prompts and embeddings alike. 使用場景
網頁轉 Markdown 的使用場景
從 AI agent 到內容遷移,把網頁變成 Markdown 是許多工作流都依賴的一小步。
AI 與 LLM 流程
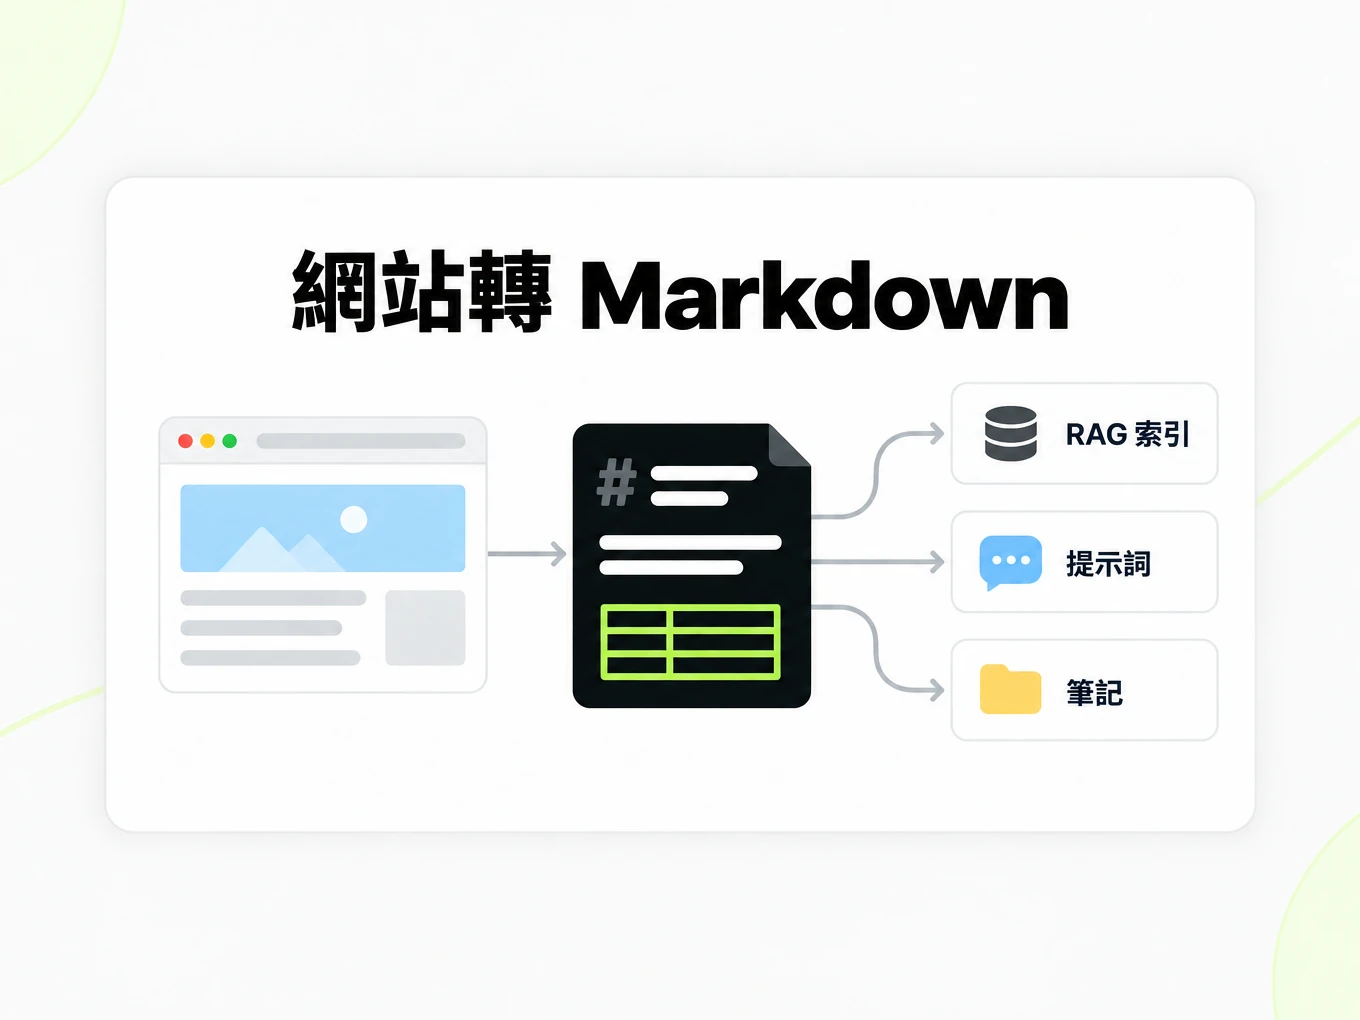
把文章和文件作為帶完整標題的乾淨文字餵給 RAG 索引、agent 工具和提示詞,而不是原始 HTML。
研究與筆記
把來源儲存為 Markdown,用於引用、批註或留在 Obsidian 或筆記倉庫裡——原始連結依然在位。
內容團隊
把文章和幫助中心頁面從一個 CMS 遷到另一個,或把參考資料拉進基於 Markdown 的文件站。
開發者
在你已有的攝取任務和爬蟲裡呼叫 API,拿到與瀏覽器轉換器顯示的同一份 Markdown。
API
專為開發者的 URL 轉 Markdown API
要從程式碼轉換頁面?把一個 URL——或 urls 陣列裡最多 20 個——發到帶 API 金鑰的 POST /v1/convert/url。頁面在等待視窗內完成時,Markdown 會在同一個回應裡返回;否則你會拿到一個可輪詢的轉換,或它完成時的一個 webhook。API 存取在付費套餐上提供。
閱讀 API 指南curl -X POST https://api.markitdown.ai/v1/convert/url \ -H "x-api-key: mdai_…" \ -H "content-type: application/json" \ -d '{"url":"https://markitdown.ai/blog/why-pdfs-break-llms"}'指南
檢查輸出結果
把 URL 轉 Markdown 的輸出與你提交的公開頁面對照。確認文章或文件文字存在,然後檢查開頭和結尾有沒有導航、Cookie 提示和重複的頁尾連結。轉換器從伺服器接收 HTML;它不執行頁面應用去載入僅在 JavaScript 執行後才出現的內容。如果輸出裡除了一個導航外殼幾乎什麼都沒有,就核實該頁面是如何交付它的文章的。可讀的匯出仍可能包含正文之外的材料,所以在使用前先決定哪些內容屬於你的筆記或檢索索引。把來源 URL 與 Markdown 一起保留,讓讀者能回到原始頁面。
保留來源上下文
在你自己的工作流裡,把提交的 URL 和你的檢索日期與 URL 轉 Markdown 的結果一起保留。公開頁面在你轉換之後可能改動,後來的訪客可能看到修改過的段落。API 的 metadata 欄位可以攜帶你提供的上下文,但它不會自動從頁面提取經過核實的作者身分或釋出日期。如果你的研究需要這些事實,請在來源處核對。在引用一張表或一段話之前,先與頁面對照,並保留足夠的周邊上下文以免改變含義。Markdown 讓網頁內容更易複用;它並不確立該頁面是否準確,也不確立你是否有權轉載它。
儲存的 HTML 與 URL
當你已經擁有需要處理的確切頁面快照時,選擇 HTML 轉換器。當公開可存取的地址就是本次轉換的輸入時,選擇 URL 轉 Markdown。這是兩種相關但來源控制不同的工作流:儲存的檔案固定了你提交的輸入,而 URL 則取決於網站在請求時返回什麼。兩條路徑都不會繞過存取限制,也不保證移除廣告。如果某個網站拒絕抓取器或要求登入,請使用你有授權透過合適工作流獲取的材料。不要反覆重試一個無法存取的 URL,彷彿再轉換一次就能獲得存取權限。
LLM 研究
研究者貼上的是一個來源,而不是一個檔案。這個轉換器抓取你提交的 URL,轉換服務端渲染的 HTML,並返回你可以引用、切分或放進筆記庫的 Markdown。它不登入付費牆,也不執行頁面的客戶端 JavaScript。
- 只支援公開可存取的 URL。
- 抓取器會表明自身身分;運營方可以拒絕該 user agent——見 /docs/fetcher。
- 儲存的 HTML 檔案屬於 /html-to-markdown,不屬於這裡。
更多 Markdown 轉換器
- PDF → Markdown正文、表格與掃描件
- Word → Markdown保留標題與列表的 DOCX
- PPT → Markdown幻燈片文字、備註與表格
- Excel → Markdown每個工作表一張表
- Image → Markdown掃描件與截圖的 OCR
- HTML → Markdown貼上或上傳 HTML
- Markdown → HTML乾淨、語義化的 HTML
- Markdown → Text去掉標記的純文字
- Markdown → PDF本機列印為 PDF
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
URL 轉 Markdown 轉換器常見問題
URL 轉 Markdown 轉換器是怎麼工作的?
貼上一個公開網頁 URL。頁面在服務端被抓取並解析成 Markdown——無需上傳檔案。
它會從線上頁面裡去掉廣告和導航嗎?
目前不能可靠地做到。目前轉換器可能把導航、廣告和頁尾文字與正文一起保留。
抓取的頁面有大小限制嗎?
公開轉換器對公開網頁生效。抓取的頁面受回應大小限制限制,過大時會被拒絕。
對登入後的頁面有效嗎?
無效。只支援公開可存取的 URL。位於身分驗證、付費牆或登入牆之後的頁面無法抓取。
依賴 JavaScript 渲染的頁面呢?
轉換器抓取初始的服務端渲染 HTML。依賴客戶端 JavaScript 載入內容的頁面可能無法完整轉換。
可以一次轉換多個 URL 嗎?
把最多 20 個公開 URL 的 urls 陣列發到 POST /v1/convert/url。逐個追蹤檔案結果並處理非同步回應。見 /developers。
URL 轉 Markdown 免費嗎?
免費。無需帳號即可預覽並複製 Markdown,每小時最多 3 次轉換、每天 10 次;下載 .md 檔案需要登入。僅限公開網頁(不支援內部網路或私有 URL)。
轉換器保留哪些內容?
標題、段落、列表、連結、表格和程式碼塊都會變成 Markdown。指令碼和樣式會被丟棄。導航、頁尾和廣告仍可能出現在正文旁邊。
有 URL 轉換 API 嗎?
有。可以透過 REST API 以程式設計方式透過 URL 轉換網頁。見 /developers。儲存的 HTML 檔案請改用 /html-to-markdown。