
Markdown-Konverter für Dokumente und Webseiten.
Ein Markdown-Konverter für Dokumente und öffentliche Webseiten: PDF, Word, PowerPoint, Excel, Bilder und HTML werden zu Text, den du prüfen, weiterverwenden und in einen KI-Workflow geben kannst.
Anonyme Testnutzung · 10 MB · 3 Konvertierungen / Stunde · 10 / Tag
In Markdown umwandeln aus
- DOCX
- PPTX
- XLSX
- PNG / JPG
- HTML
- URL
So funktioniert es
So funktioniert der Markdown-Konverter
markitdown.ai ist ein Markdown-Konverter, der PDFs, Office-Dateien, Bilder und Webseiten in sauberes, KI-taugliches Markdown für ChatGPT, Claude, RAG-Pipelines und Agenten verwandelt – über eine anonyme Testnutzung oder ein kostenpflichtiges Konto mit Entwickler-API-Zugang.
What happens
Lade eine Datei hoch oder füge eine URL ein. Die Konvertierung läuft auf unseren Servern und nicht als Copy-&-Paste-Trick im Browser, sodass dieselbe Datei überall dasselbe Markdown ergibt. Jede Seite wird nach ihrem Inhalt behandelt, und Überschriften, Listen und Tabellen kommen als echte Markdown-Struktur heraus.
What you get
- Seiten mit Textebene werden direkt gelesen; Scans und Bilder laufen automatisch durch die OCR
- URL-Abrufe laufen über unsere Server, private und interne Adressen sind blockiert
- Öffentlicher Konverter: bis zu 10 MB und 25 Seiten, ohne Anmeldung
- Pläne mit Anmeldung heben beide Limits an, bis zu 200 MB und 200 Seiten bei Pro
What happens
Der Viewer stellt das Quelldokument und das erzeugte Markdown nebeneinander, damit du Überschriften, Tabellen und Lesereihenfolge prüfen kannst, bevor du das Ergebnis verwendest. Wechsle zwischen der gerenderten Vorschau und dem rohen Markdown, um genau zu sehen, was ein Modell oder eine Pipeline erhält.
What you get
- Quelle und Markdown werden im Viewer nebeneinander dargestellt
- Wechsle im Markdown-Bereich zwischen gerenderter Vorschau und Rohquelle
- Kopiere das Ergebnis kostenlos, ohne Konto
- Lade die .md-Datei herunter, sobald du angemeldet bist
What happens
Dieselben Einstellungen, die für eine Datei funktioniert haben, gelten auch für einen Stapel Dateien oder einen Pipeline-Aufruf, und jedes Ergebnis landet in deiner Bibliothek. Batch verfolgt jede Datei mit eigenem Status und Wiederholungsversuch, und die API gibt dasselbe Markdown direkt an deinen Code weiter.
What you get
- Dieselbe Parsing-Engine für Web-App, Batch (ZIP oder URL-Liste) und API
- POST /v1/convert/{name} liefert Markdown in einem Aufruf innerhalb von 60 Sekunden oder eine Konvertierung, die du abfragst oder per Webhook erhältst
- Die Bibliothek speichert jeden Lauf für das Historienfenster deines Plans: 30, 60 oder 90 Tage
Credits
Markdown-Präzision, pro Seite abgerechnet.
Eine Rechnung mit Textebene und eine gescannte Bilanz kosten pro Seite gleich viel: Die Pipeline wählt für dich zwischen direkter Extraktion und OCR. KI-Extras für Abbildungen und Bilder sind optional und werden separat abgerechnet.
- pro Seite, Text oder Scan
- 1 Credit
- pro Seite, Text oder Scan
PDF mit Textebene, Office-Dateien und HTML
OCR für gescannte Seiten, Fotos und Screenshots
Diagramme und Abbildungen in PDFs beschrieben · kostenpflichtige Pläne
Bildinhalt beschrieben, nicht nur OCR · kostenpflichtige Pläne
Markdown-API
Eine Markdown-API für deine RAG-Pipeline.
- Dieselbe Parsing-Pipeline wie in der Web-App
- Tausende Dateien im Batch mit Webhooks bei Abschluss
- API-Schlüssel mit Geltungsbereich und vollständiges Aktivitätsprotokoll
- Markdown in einem Aufruf oder eine Konvertierung zum Abfragen, wenn eine Datei länger als 60 Sekunden braucht
curl -X POST https://api.markitdown.ai/v1/convert/word \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F file=@vendor-security-review-q3-2026.docx # If HTTP 202, GET the Location URL with the same API key.# Verified local parser output for vendor-security-review-q3-2026.docx:# ## Review Findings# # Risk ratings follow the standard High / Medium / Low scale defined in the vendor risk management policy.# # | Vendor | Risk Rating | Finding | Owner |# | --- | --- | --- | --- |# | CloudScan OCR | Medium | No documented data retention limit on uploaded scans | Security |# | PayBridge | Low | SOC 2 Type II renewed; no open items | Finance |# | LingoTrans API | High | Sub-processor list not disclosed on request | Legal |# | ArchiveNow Storage | Medium | Encryption at rest confirmed; key rotation overdue | Security |Preise
Einfache Preise für die Markdown-Konvertierung.
Das Problem
Dokumente sind nicht KI-bereit
Die meisten Dokumente wurden für Menschen und Drucker gebaut, nicht für Sprachmodelle. Bevor eine Datei eingebettet, abgerufen oder von einem Modell verarbeitet werden kann, muss sie zu vorhersehbarem Text werden. Das ist schwieriger, als es aussieht, und genau hier scheitert naive Extraktion.
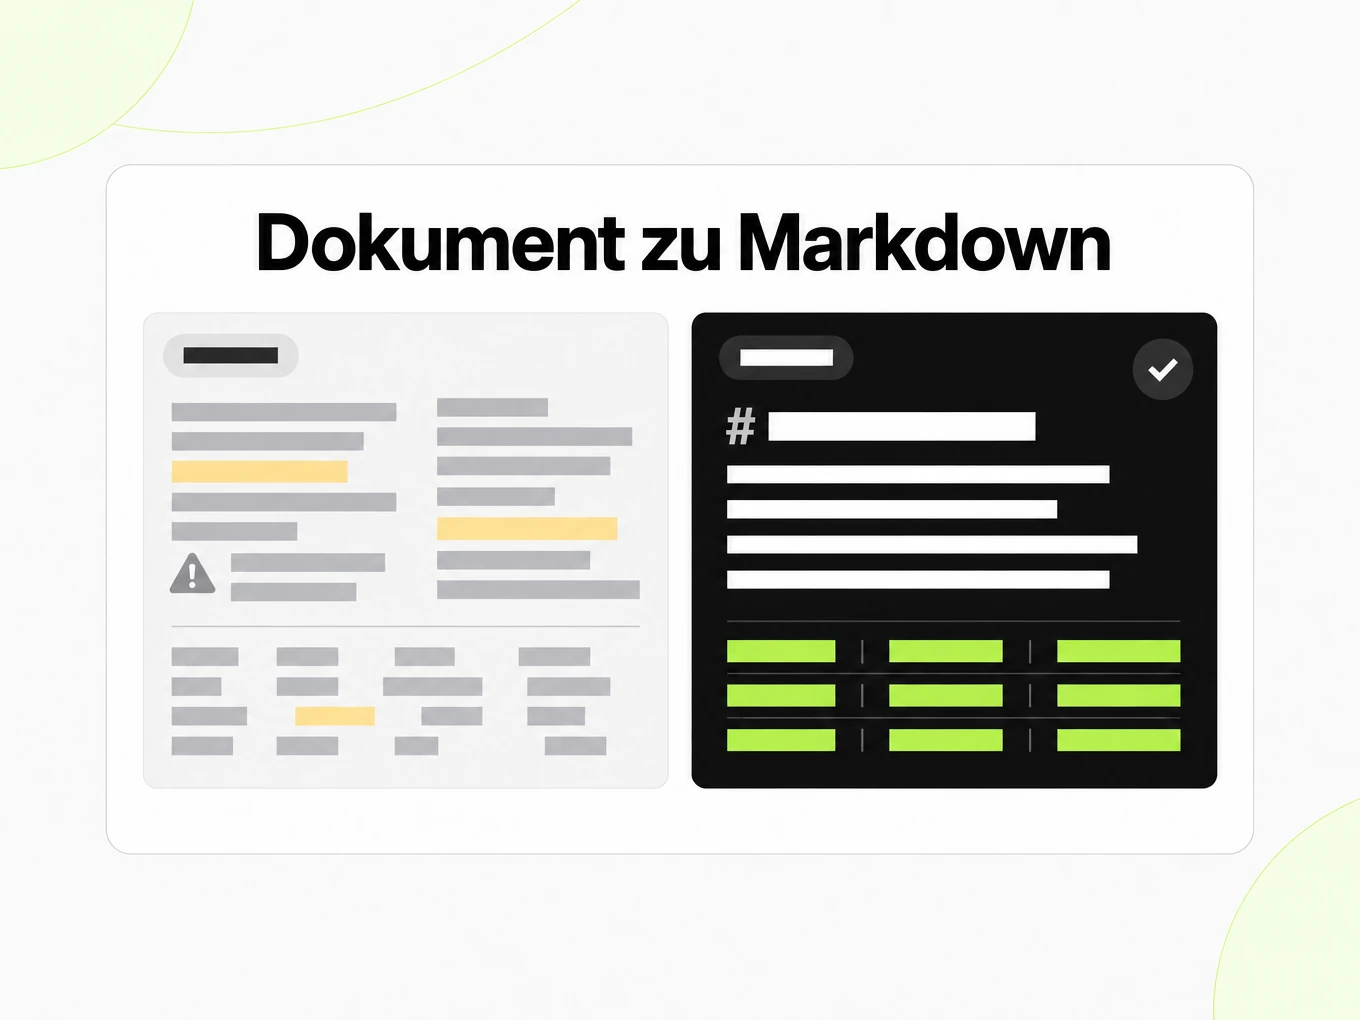
Die Lesereihenfolge bricht
Mehrspaltige PDFs, Kopfzeilen und Fußnoten werden ineinander verschachtelt, sodass der Text, den ein LLM liest, nicht mehr zum Dokument passt, das ein Mensch sieht.
Tabellen und Überschriften verflachen
Copy & Paste presst Tabellen zu Zahlenkolonnen zusammen und verliert die Überschriftenhierarchie, die einem Dokument seine Struktur gibt.
Scans brauchen OCR
Bildbasierte Seiten und gescannte Verträge haben gar keine Textebene, bis sie durch optische Zeichenerkennung laufen.
Rohtext ist verrauscht
Improvisierte Extraktion hinterlässt Seitenzahlen, falsche Trennstriche und verirrte Zeichen, die Prompts und Abrufergebnisse verunreinigen.
RAG-Pipelines und Agenten brauchen konsistente Struktur, nicht nur extrahierte Zeichen. Vorhersehbares Markdown sorgt dafür, dass Chunking, Embedding und Retrieval über Tausende Dokumente hinweg gleich funktionieren, statt bei den unordentlichen leise zu versagen. Der Parser, der die hässlichen Dateien meistert, hält die sauberen verlässlich.
Eingabeformate
Wandle jedes Dokument in Markdown um
Jedes Eingabeformat hat seine eigene Konverterseite mit Limits, Formathinweisen und einer Beispielausgabe. Alle teilen eine Parsing-Engine – wähle die Seite, die zu deiner Datei passt:
- PDF zu Markdown — Berichte, Fachartikel, Handbücher und Verträge. Native Text-PDFs werden direkt geparst und die mehrspaltige Lesereihenfolge wird rekonstruiert; gescannte PDFs laufen Seite für Seite durch die OCR.
- Word zu Markdown — .docx- und alte .doc-Dateien mit erhaltenen Überschriften, Listen, Tabellen und Kommentaren, sodass eine Richtlinie oder Spezifikation als Gliederung statt als ein Block lesbar wird.
- PPT zu Markdown — .pptx- und .ppt-Präsentationen Folie für Folie, mit Folientiteln als Überschriften und erhaltenen Aufzählungen und Tabellen – so wird eine 40-Folien-Präsentation durchsuchbar.
- Excel zu Markdown — .xlsx- und .xls-Arbeitsmappen, in denen jedes Tabellenblatt unter seinem Blattnamen zu einer Markdown-Tabelle wird.
- Bild zu Markdown — PNG- und JPG-Screenshots und Scans per OCR. Das KI-Bildverständnis ist eine separate Option für angemeldete Nutzer.
- HTML zu Markdown — gespeicherte Seiten, Exporte und Fragmente mit entfernten Skripten und Styles, während Artikelstruktur, Links und Tabellen erhalten bleiben.
- URL zu Markdown — füge eine öffentliche Webadresse ein und erhalte die Seite als Markdown, serverseitig abgerufen mit Größenlimit und Timeout, damit eine langsame Seite die Anfrage nicht blockiert.
Ausgabeformate
Von Markdown in jedes Format
Markdown ist das Austauschformat, also funktioniert die Konvertierung auch andersherum. Die Markdown-Editoren unten rendern beim Tippen im Browser und laden deinen Text nie hoch:
- Markdown zu HTML — sauberes semantisches HTML mit GitHub-Tabellen, Aufgabenlisten und Code-Hervorhebung, bereit zum Einfügen in ein CMS oder eine E-Mail.
- Markdown zu Text — Klartext mit lesbar verebneten Überschriften, Listen und Tabellen für Chatfenster, Tickets und Formulare.
- Markdown zu PDF — eine lokale Druckvorschau; nutze Drucken / Als PDF speichern in deinem Browser und prüfe die gespeicherten Seiten.
Strukturierte JSON-Extraktion sowie Audio- und Video-Transkription sind geplante Ebenen über Markdown. Sie sind als Roadmap aufgeführt, nicht als bereits verfügbare Funktionen.
Anwendungsfälle
Für jedes Team gemacht
Der Markdown-Konverter bietet eine anonyme Testnutzung, um ein erstes Ergebnis zu prüfen. Der Grund, warum Teams dabeibleiben, ist alles nach der ersten Datei: Verlauf, Stapel, größere Dokumente und eine API, die die Konvertierung in deine bestehenden Systeme einbindet. Der Schritt vom Dokument zu Markdown ist dabei erst der Anfang – dasselbe Markdown funktioniert, egal ob es ein Mensch, ein Suchindex oder ein Modell verbraucht.
RAG und KI-Pipelines
Wandle Quelldokumente in sauberes Markdown um, bevor du chunkst, einbettest oder Agenten darauf laufen lässt. Vorhersehbare Struktur bedeutet, dass dein Splitter echte Überschriften und Tabellen sieht statt einer Wand aus extrahiertem Text – das hält das Retrieval relevant und die Prompts frei von Layout-Rauschen.
Recherche und Berichte
Mach aus Fachartikeln, Whitepapers und Präsentationen bearbeitbares, durchsuchbares Markdown. Forschende und Analysten können zitieren, kommentieren, zusammenfassen und Ergebnisse wiederverwenden, ohne Tabellen neu zu tippen oder die Lesereihenfolge eines dichten PDFs zu verlieren.
Betriebsdokumente
Verarbeite Richtlinien, Verträge, Rechnungen und interne Dateien ohne manuelles Copy-&-Paste-Aufräumen. Ein gespeicherter Markdown-Verlauf macht wiederkehrende Dokumentarbeit im Teamalltag leichter prüfbar, vergleichbar und wiederverwendbar.
Entwickler-Automatisierung
Nutze die API, um Dateien in Ingestion-Jobs, internen Tools und Dokument-Workflows zu konvertieren. Sende eine Anfrage, erhalte Markdown und speise es in ein CMS, eine Wissensdatenbank, einen Support-Bot oder eine Agenten-Pipeline mit verlässlicher Ausgabe ein.
Wissensdatenbanken und Support
Führe Produkthandbücher, Release Notes und interne Wikis in einem Markdown-Korpus zusammen, den ein Support-Bot oder ein interner Assistent durchsuchen kann. Weil Überschriften und Tabellen erhalten bleiben, verweisen Antworten auf den richtigen Abschnitt statt auf einen seitenlangen Block.
Agenten und Tools
Gib einem Agenten einen Markdown-Konverter für unterstützte Dateien und öffentliche URLs und prüfe den Abschluss, bevor er das Ergebnis verbraucht. Lies diese Website genauso: Jede öffentliche Seite antwortet auf Accept: text/markdown mit einem Markdown-Zwilling, und llms.txt listet sie alle auf.
Ausgabequalität
Struktur, nicht nur Text
Ein nützlicher Markdown-Dateikonverter bewahrt mehr als einzelne Zeichen aus einer PDF. Das Ziel hier ist Markdown, das die Struktur erhält, auf die deine nachgelagerten Tools angewiesen sind – erzeugt von einer serverseitigen Parsing-Pipeline statt von fragiler Copy-&-Paste-Arbeit im Browser.
- Bewahrt Überschriften, Listen, Tabellen, Links und Lesereihenfolge, wo die Quelle sie hat.
- Verarbeitet PDF, Word, PowerPoint, Excel, Bilder, HTML und URLs in einer Pipeline.
- Verarbeitet gescannte PDFs und Bilder schon heute mit OCR; die Erkennungsqualität hängt vom Quellbild ab.
- Führt lange Dokumente asynchron aus, damit große Berichte und Präsentationen fertig werden statt in einen Timeout zu laufen.
Standardseiten und OCR-Seiten kosten 1 Credit pro Seite; Konten mit kostenpflichtigem Plan können das KI-Bildverständnis für 5 Credits pro Bild nutzen. Die Ausgabe folgt CommonMark mit GitHub-Tabellen, rendert also in jedem Markdown-Viewer und lässt sich mit jeder Markdown-Bibliothek parsen. Jede Konvertierung sollte ein Artefakt erzeugen, das du prüfen, speichern und wiederverwenden kannst – das ist der Anspruch.
Drei Zugänge
Browser, API oder Agent
Der Markdown-Konverter in der Web-App deckt die einmalige und wiederkehrende manuelle Konvertierung ab. Batch deckt Stapel von Dateien ab. Die API deckt alles ab, was automatisch passieren soll, einschließlich Agenten, die sie als Tool aufrufen. Alle drei teilen ein Konto, ein Credit-Guthaben und eine Parsing-Engine. Die meisten Teams starten im Browser und wechseln zur API, sobald die Konvertierung Teil eines Produkts oder eines internen Workflows wird.
| Aspect | Browser | Batch | API |
|---|---|---|---|
| Ideal für | Eine Datei nach der anderen | Viele Dateien in einem Lauf | Pipelines, Tools und Agenten |
| Anmeldung | Für die erste Datei nicht nötig | Kostenpflichtige Pläne | Kostenpflichtige Pläne, API-Schlüssel |
| Eingabe | Upload oder URL | Eine Liste von Uploads oder Datei-IDs | Upload, URL, Inline-Text oder Datei-ID |
| Ausgabe | Vorschau, Kopieren, .md herunterladen | Bibliothek mit Status pro Datei | JSON mit Markdown, Ausgabe pro Seite, Webhooks |
| Limits | 10 MB und 25 Seiten ohne Anmeldung | Parallelität des Plans | 20 bis 60 Anfragen pro Minute je nach Plan |
| Wartezeit | Sekunden, auf der Seite | Im Hintergrund | Sync bis zu 60 s, danach eine Konvertierung zum Abfragen |
Web-App
- Lade Dateien hoch oder füge URLs ein und sieh dir gerendertes Markdown in der Vorschau an
- Speichere den Konvertierungsverlauf und lade .md-Ergebnisse herunter
- Konvertiere wiederkehrende Arbeit im Batch mit Status pro Datei
- Verfolge Credits und Nutzung pro Plan
Entwickler-API
- POST /v1/convert/{name} liefert Markdown in einem Aufruf oder eine Konvertierung, wenn eine Datei länger als 60 Sekunden braucht
- Frage Konvertierungen ab oder erhalte Webhooks, wenn sie abgeschlossen sind
- Sende Accept: text/markdown, um jede öffentliche Seite als Markdown zu lesen
- Maschinenlesbare Spezifikation unter /v1/openapi.json
FAQ
Fragen, die Teams stellen
Was macht ein Markdown-Konverter?
Ein Markdown-Konverter für Dokumente ist ein Werkzeug, das ein PDF, Word-, PowerPoint- oder Excel-Dokument, ein Bild oder eine Webseite liest und den Inhalt als Markdown neu schreibt: Überschriften werden zu #-Zeilen, Tabellen zu Pipe-Tabellen, Listen bleiben Listen. Ziel ist vorhersehbarer Klartext, den Sprachmodelle, RAG-Pipelines und Agenten ohne Layout-Rauschen chunken, einbetten und zitieren können.
Ist die kostenlose Testnutzung des Konverters wirklich kostenlos?
Ja. Die öffentlichen Seiten des Markdown-Konverters brauchen kein Konto und keine Karte. Dateien bis 10 MB und 25 Seiten werden im Browser konvertiert, und du kannst das Markdown in der Vorschau ansehen und kopieren. Die Abos Lite, Pro und Max starten bei $20 pro Monat und ergänzen eine gespeicherte Bibliothek, Batch und die API.
Wie funktionieren gescannte PDFs und Bilder?
Seiten, die nur aus Bildern bestehen, haben keine Textebene, deshalb führt die Pipeline automatisch OCR aus und liefert Markdown genauso wie bei digitalem Text. Standardseiten und OCR-Seiten kosten 1 Credit pro Seite. Die Erkennungsqualität hängt vom Quellbild ab: Ein Scan mit 300 dpi liest sich deutlich besser als das Handyfoto einer Seite.
Kann ich den Markdown-Konverter aus Code oder von einem Agenten aus ausführen?
Ja. POST /v1/convert/{name} akzeptiert einen Upload, eine URL oder Inline-Text mit einem API-Schlüssel und liefert Markdown in einem Aufruf, wenn die Datei innerhalb von 60 Sekunden fertig wird, oder eine Konvertierung, die du abfragen oder per Webhook erhalten kannst. Agenten können Accept: text/markdown auf jeder öffentlichen Seite anfordern, und die maschinenlesbare Spezifikation liegt unter /v1/openapi.json.
Was passiert nach der Konvertierung mit meinen Dateien?
Wenn du eine Konvertierung löschst, verschwindet sie sofort aus deiner Bibliothek und ihre gespeicherten Dateien werden innerhalb einer Stunde gelöscht; eine Quelldatei, die eine andere Konvertierung ebenfalls nutzt, bleibt erhalten, bis auch diese gelöscht wird. Beim Löschen deines Kontos werden alle gespeicherten Quell- und Ergebnisdateien gelöscht. Kostenpflichtige Pläne bewahren den Verlauf je nach Plan 30, 60 oder 90 Tage lang auf.
Wandle deine erste Datei in Markdown um.
Kostenlos testen – keine Anmeldung nötig.