
Konverter
PDF in Markdown umwandeln
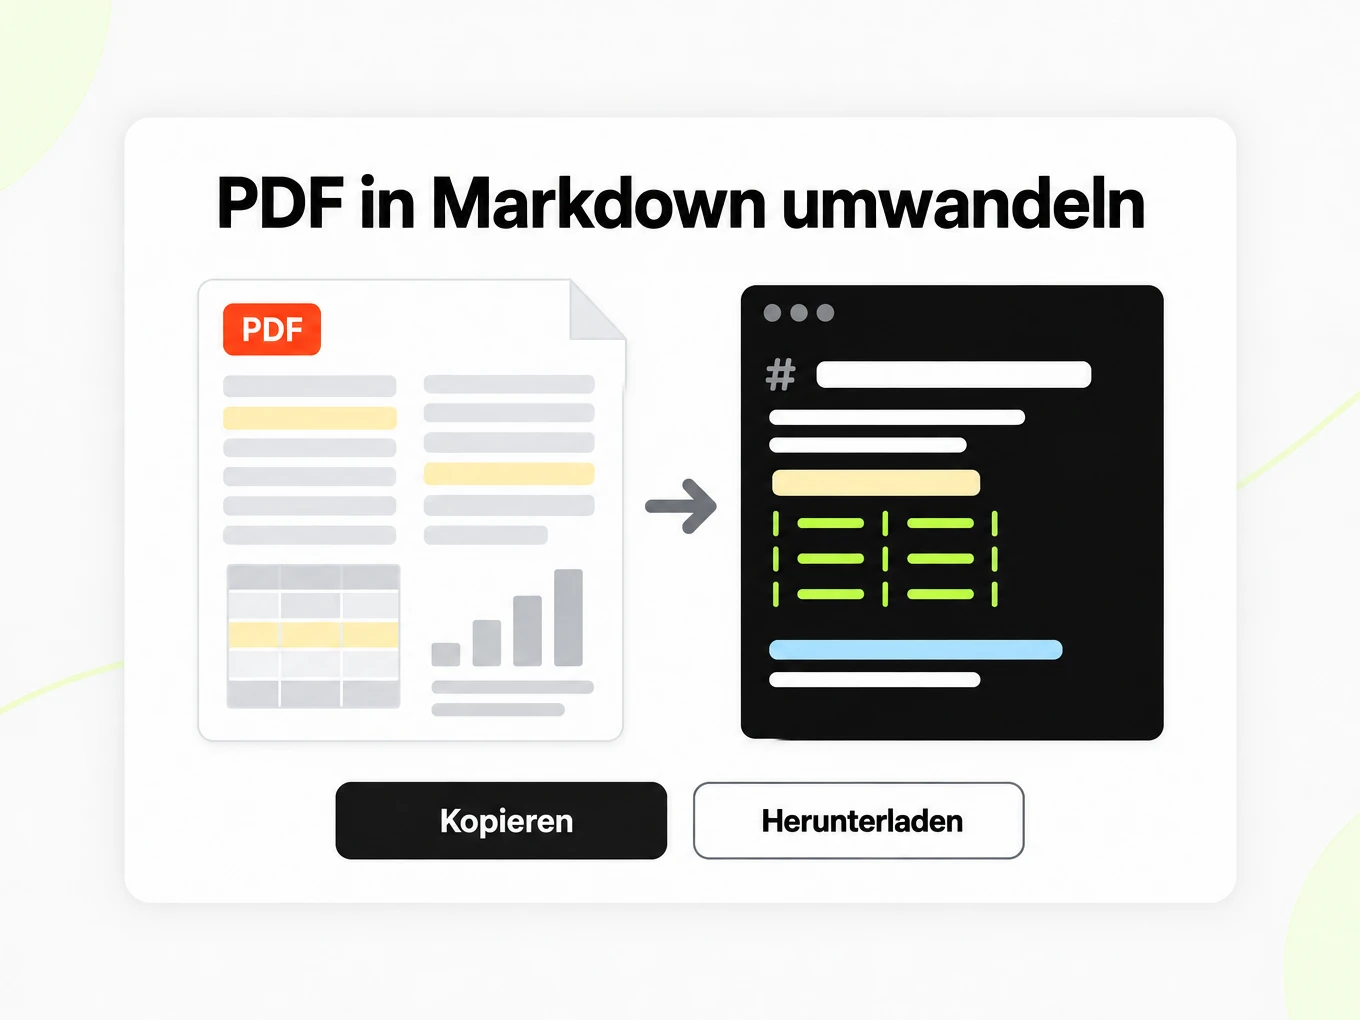
PDF in Markdown umwandeln ist ein Konverter, der die mehrspaltige Lesereihenfolge in strukturiertes Markdown für RAG rekonstruiert; für gescannte Seiten greift PDF OCR. Ob du PDF zu Text oder in Markdown brauchst – die öffentliche Testnutzung akzeptiert Dateien bis 10 MB.
Teste eine Datei, bevor du einen Plan wählst.
- Ohne Konto: bis 10 MB und 25 Seiten pro Datei, 3 Konvertierungen pro Stunde und 10 pro Tag, Vorschau und Kopieren im Browser.
- Angemeldet: 20 kostenlose Konvertierungen pro Tag, in deiner Bibliothek gespeichert.
- Lite, Pro und Max enthalten Konvertierungs-Credits, Batch-Verarbeitung, API-Zugang und gespeicherten Verlauf. Lite enthält 30 Tage Verlauf.
So geht's
So wandelst du PDF in Markdown um
Was du hochladen kannst
- Dateitypen: .pdf
- Teste ohne Konto: bis 10 MB und 25 Seiten pro Datei, 3 Konvertierungen pro Stunde und 10 pro Tag
- Lite nimmt Dateien bis 100 MB, Pro bis 200 MB
- Max hat kein Größenlimit pro Datei; Konvertierungen werden durch Credits begrenzt
Was du prüfen solltest
- Rekonstruktion der Lesereihenfolge — Die PDF-Konvertierung versucht, eine logische Lesereihenfolge zu rekonstruieren.
- Tabellen und Überschriften — Überschriftsebenen und tabellarische Daten werden bewahrt, wo das PDF Strukturmetadaten offenlegt; PDFs aus reinem Text liefern reinen Text.
- Gescante und reine Bild-PDFs — PDFs ohne Textebene (gescannte Seiten und eingefügte Bilder) werden heute mit OCR verarbeitet; die Genauigkeit hängt von der Scanqualität ab.
- Passwortgeschützte Dateien — Verschlüsselte PDFs können nicht geparst werden; entferne das Passwort vor dem Upload.
Wohin das Markdown geht
- Kopiere das Markdown direkt aus der Vorschau
- Lade die .md-Datei herunter und behalte sie in deiner Bibliothek, sobald du angemeldet bist
- Konvertiere ganze Ordner oder ZIP-Archive mit Batch Convert
- Automatisiere es mit POST /v1/convert/pdf und deinem API-Schlüssel
Warum nutzen
Warum PDF zu Markdown nutzen
Berichte als lesbarer Text
Verwandle die Absätze und die unterstützte Struktur eines Berichts in Markdown, das du prüfen, bearbeiten und neben dem Quell-PDF behalten kannst.
OCR für gescannte Seiten
Seiten, die nur aus Bildern bestehen, können per OCR erkannt werden. Vergleiche kleinen Text, Interpunktion und numerische Tabellen mit dem Original-Scan.
Überschriften-Kontext
Bewahre erkennbare Abschnitte für Notizen- und Retrieval-Workflows auf und prüfe dabei, ob visuell gestylte Überschriften korrekt interpretiert wurden.
Tabellen zur Prüfung
Unterstützte Tabellen werden zu Texttabellen. Prüfe komplexe oder zusammengeführte Zellen, bevor du die exportierten Werte als Beleg behandelst.
Vor der Wiederverwendung ansehen
Vergleiche die Markdown-Quelle mit ihrer gerenderten Ansicht, bevor du eine Passage in ChatGPT, Claude oder ein Dokumentations-Repository kopierst.
Ein wiederholbarer API-Weg
Nutze den PDF-Konvertierungsweg in einem Ingestion-Skript, nachdem du repräsentative Ausgaben im Browser geprüft hast.
Das Problem
Warum PDF-Spalten Sprachmodelle brechen
Spalten verschachteln sich
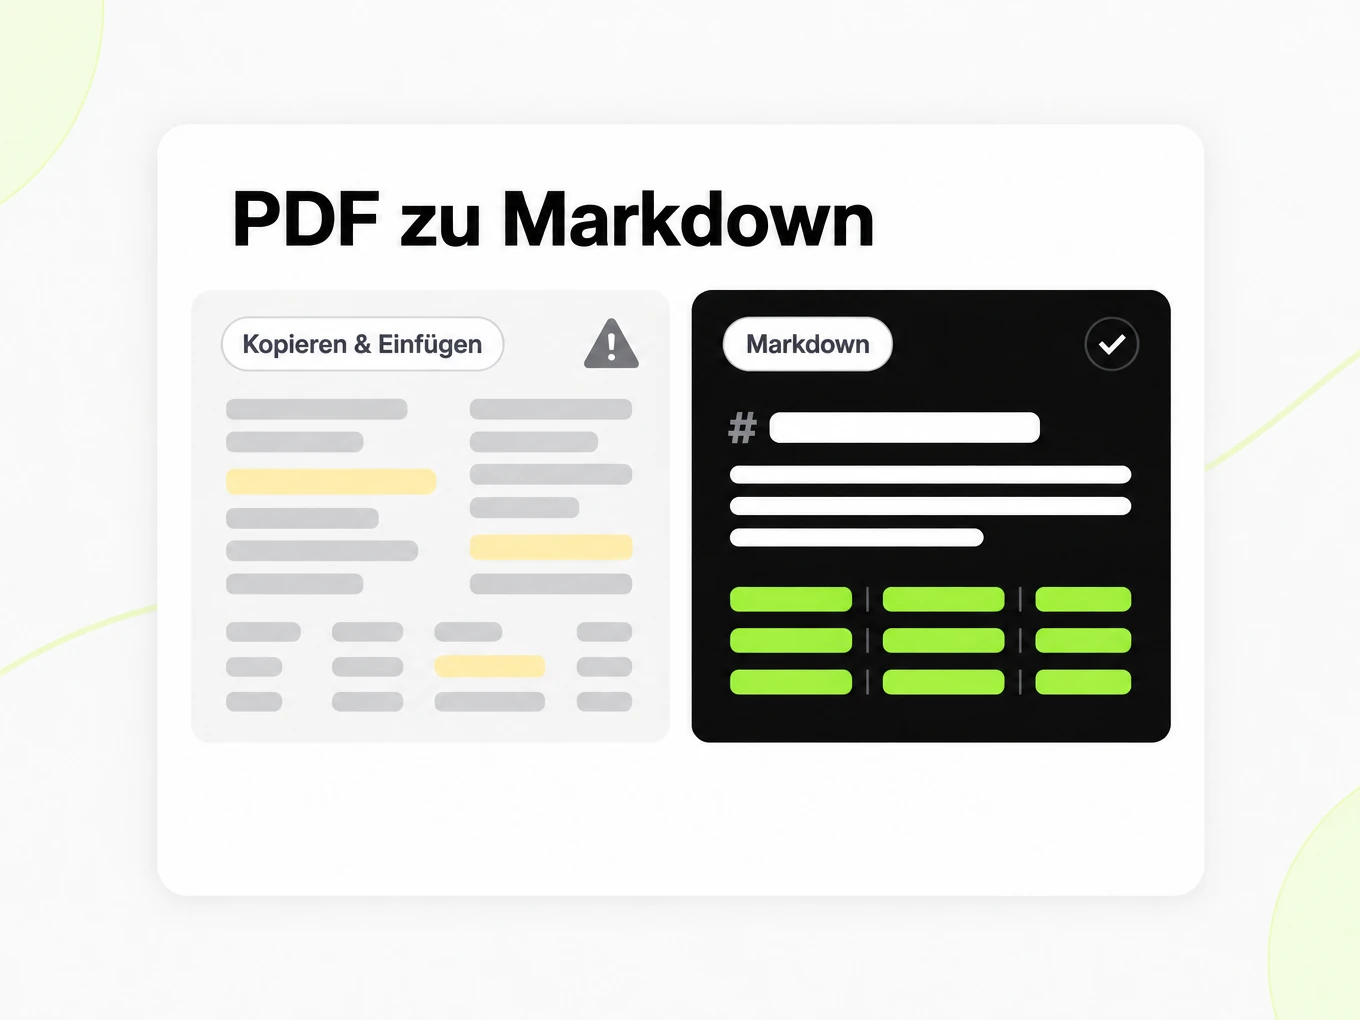
Ein zweispaltig von oben nach unten gelesener Bericht mischt den linken und rechten Strom, sodass das Modell einen Satz sieht, den es auf der Seite nie gab.
Tabellen verlieren ihr Raster
Copy & Paste aus einem PDF macht aus einer Ergebnistabelle eine Zahlenfolge ohne Kopfzeile für einen nachgelagerten Parser.
Scans haben keine Textebene
Seiten, die nur aus Bildern bestehen, tragen Pixel statt Glyphen, deshalb werden gescannte PDFs heute mit OCR verarbeitet.
Was erhalten bleibt
Was dieser PDF-Konverter bewahrt
- Rekonstruktion der Lesereihenfolge
- Die PDF-Konvertierung versucht, eine logische Lesereihenfolge zu rekonstruieren. Prüfe Spaltenübergänge gegen das Original, besonders bei komplexen Berichten und Fachartikeln.Source: ISO 32000-2 (PDF 2.0)
- Tabellen und Überschriften
- Überschriftsebenen und tabellarische Daten werden bewahrt, wo das PDF Strukturmetadaten offenlegt; PDFs aus reinem Text liefern reinen Text.Source: CommonMark Spec
- Gescante und reine Bild-PDFs
- PDFs ohne Textebene (gescannte Seiten und eingefügte Bilder) werden heute mit OCR verarbeitet; die Genauigkeit hängt von der Scanqualität ab.Source: product pipeline
- Passwortgeschützte Dateien
- Verschlüsselte PDFs können nicht geparst werden; entferne das Passwort vor dem Upload.Source: ISO 32000-2 (PDF 2.0)
Beispiel: NIST Cybersecurity Framework 2.0, Seite 15· https://nvlpubs.nist.gov/nistpubs/CSWP/NIST.CSWP.29.pdf
## Appendix A. CSF Core This appendix describes the Functions, Categories, and Subcategories of the CSF Core. Table 1 lists the CSF 2.0 Core Function and Category names and unique alphabetic identifiers. Each Function name in the table is linked to its portion of the appendix. The order of Functions, Categories, and Subcategories of the Core is not alphabetical; it is intended to resonate most with those charged with operationalizing risk management within an organization. The numbering of the Subcategories is intentionally not sequential; gaps in numbering indicate CSF 1.1 Subcategories that were relocated in CSF 2.0. **Table 1. CSF 2.0 Core Function and Category names and identifiers** | Function | Category | Category Identifier || --- | --- | --- || **Govern (GV)** | Organizational Context | GV.OC || | Risk Management Strategy | GV.RM || | Roles, Responsibilities, and Authorities | GV.RR || | Policy | GV.PO || | Oversight | GV.OV || | Cybersecurity Supply Chain Risk Management | GV.SC || **Identify (ID)** | Asset Management | ID.AM || | Risk Assessment | ID.RA || | Improvement | ID.IM || **Protect (PR)** | Identity Management, Authentication, and Access Control | PR.AA || | Awareness and Training | PR.AT || | Data Security | PR.DS || | Platform Security | PR.PS || | Technology Infrastructure Resilience | PR.IR || **Detect (DE)** | Continuous Monitoring | DE.CM || | Adverse Event Analysis | DE.AE | Anwendungsfälle
PDF zu Markdown in echten Workflows
Recherchenotizen
Extrahiere einen Fachartikel in bearbeitbare Notizen, prüfe zitierte Passagen und behalte den PDF-Verweis für die spätere Kontrolle.
Bericht-Ingestion
Bereite Berichte fürs Chunking vor und behalte dabei Tabellenüberschriften, Abschnittskontext und einen Link zum Originaldokument.
Richtlinienbibliotheken
Wandle eine geprüfte Richtlinie in durchsuchbaren Text um und bewahre das veröffentlichte PDF als maßgebliche Version auf.
Dokumentbewertung
Vergleiche repräsentative PDFs, bevor du eine Sammlung automatisierst, einschließlich Scans, Spalten und einer schwierigen Tabelle.
API
PDF zu Markdown API
Nutze POST /v1/convert/pdf mit einem x-api-key-Header und einer unterstützten Quelldatei. Eine abgeschlossene Anfrage kann Ausgaben direkt zurückgeben; HTTP 202 bedeutet, dass die Konvertierung noch läuft. Lies den Location-Antwortheader und frage ihn ab, bevor du auf Dateiausgaben zugreifst. Eine Multipart-Anfrage akzeptiert höchstens 100 Dateien; Abo- und Gesamtanfragelimits gelten zusätzlich. Bewahre API-Schlüssel in der Serverumgebung auf. Der API-Zugang erfordert ein Lite-, Pro- oder Max-Abo.
API-Leitfaden lesencurl -i "https://api.markitdown.ai/v1/convert/pdf" \ -H "x-api-key: $MARKITDOWN_API_KEY" \ -F "file=@source.pdf"# If HTTP 202, GET the Location URL with the same API key.Leitfaden
Die Ausgabe prüfen
Vergleiche die Ausgabe von PDF in Markdown mit dem Original-PDF, bevor du sie als Beleg verwendest. Beginne mit einer Seite, die Spalten, eine Fußnote und eine Tabelle enthält, statt mit einer einfachen Titelseite. Lies den letzten Satz einer Spalte und den ersten Satz der nächsten: Sie sollten dieselbe Reihenfolge bilden, der eine Person im PDF folgt. Vergleiche dann eine Tabellenüberschrift, einen negativen Wert und eine Einheit. Eine lesbare Markdown-Vorschau kann dennoch eine OCR-Verwechslung oder eine verrutschte Zelle enthalten. Wenn das Dokument eine finanzielle oder technische Entscheidung stützt, bewahre das PDF neben dem Markdown auf und prüfe die Passage, die du zitieren willst. Die Konvertierung macht den Text leichter nutzbar; sie beglaubigt weder die Quelle noch ihre Übertragung.
Was sich ändert
Die Konvertierung von PDF in Markdown ersetzt visuelle Positionierung durch eine Textstruktur. Eine große Überschrift kann zu einem Überschriftsmarker werden, Absätze zu Absätzen und eine unterstützte Tabelle zu durch Pipes getrennten Zeilen. Seitengeometrie, dekorative Linien, Schriftwahl und der ursprüngliche Zeilenumbruch gehören nicht zum Ausgabevertrag. Das ist nützlich, wenn du einen Auszug bearbeiten oder einen Retrieval-Index aufbauen willst, aber ungeeignet, wenn es darum geht, eine Broschüre exakt zu reproduzieren. Bewahre das Original-PDF für sein maßgebliches Layout auf. Wo ein Layout sich nicht durch eine einfache Markdown-Tabelle darstellen lässt, prüfe, ob eine kurze Erläuterung oder eine manuell geprüfte Tabelle die klarere nachgelagerte Darstellung ist.
RAG-Quellen
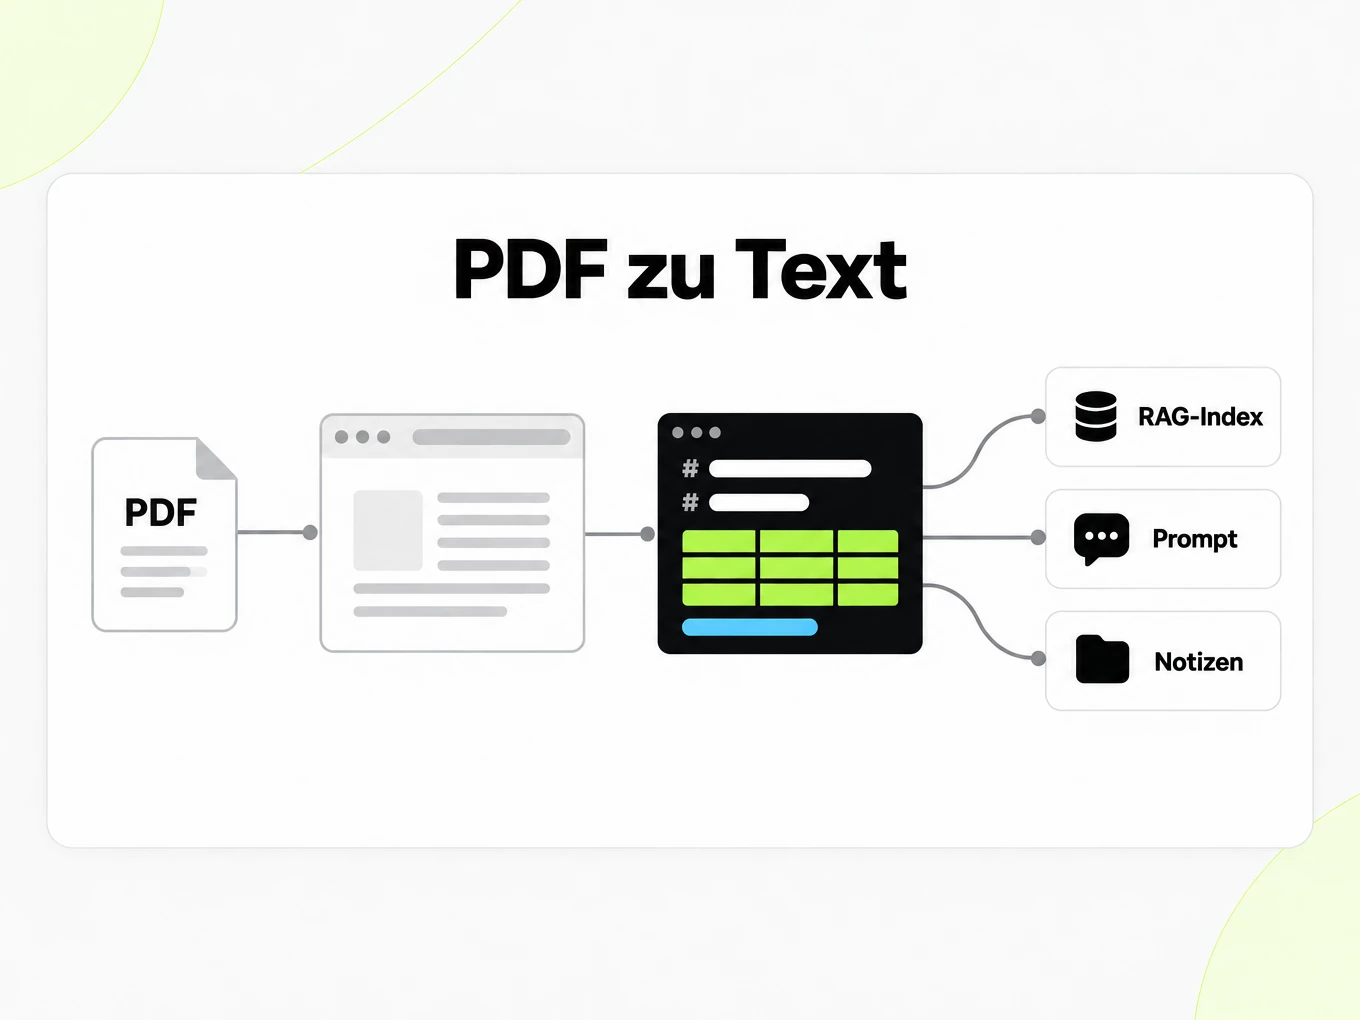
Nutze den PDF-Titel und aussagekräftige Abschnittsüberschriften, um den Kontext beim Aufteilen des Markdowns in Passagen zu bewahren. Ein Chunk mit der Überschrift nur „Ergebnisse“ kann mehrdeutig werden, sobald er das Dokument verlässt; dein Ingestion-Code kann den Dokumentnamen und die übergeordnete Überschrift bei dieser Passage behalten. Halte eine Tabellenüberschrift mit ihren Zeilen zusammen und vermeide es, eine Liste mitten in einer Einschränkung zu teilen. Bewahre den Verweis auf das Original-PDF separat auf, damit eine abgerufene Antwort Lesende zur Quelle zurückführen kann. LangChain und LlamaIndex können Text aus deinem eigenen Ingestion-Prozess verarbeiten, aber die Wahl von Splitter, Embedding-Modell und Retrieval-Richtlinie bleibt Aufgabe deiner Anwendung. Teste das Retrieval mit Fragen, deren Antworten du im PDF geprüft hast.
Das PDF auswählen
Bevorzuge den ursprünglichen PDF-Export, wenn er lesbaren Text enthält. Ein Screenshot dieses PDFs führt einen weiteren Bilderkennungsschritt ein und kann kleine Zeichen verlieren, bevor die Konvertierung beginnt. Bei gescannten PDFs solltest du gedrehte Seiten gerade ausrichten und eine Version verwenden, in der Interpunktion und Tabellenrahmen bei normalem Zoom lesbar bleiben. Entferne ein Passwort, bevor du ein verschlüsseltes PDF hochlädst. Wenn nur ein Teil eines langen Berichts relevant ist, bereite die relevanten Quellseiten vor und behalte ihren ursprünglichen Verweis in deinen Notizen. Denselben beschädigten Scan zu wiederholen, repariert fehlende Details wahrscheinlich nicht; verbessere zuerst die Quelle und vergleiche dann die neue Ausgabe von PDF in Markdown mit dem vorherigen Ergebnis.
Chunk-Grenzen
Die Retrieval-Qualität hängt von Chunk-Grenzen ab, die zum Dokument passen, das ein Mensch lesen würde. Dieser Konverter ordnet Spalten neu und behält Überschriftsebenen, damit ein Splitter Passagen ausgeben kann statt ineinander verschachtelter Fragmente eines zweispaltigen Fachartikels.
- Nutze das Markdown als das Artefakt, das du chunkst und einbettest, nicht als flachgedrückten Textauswurf.
- Standardseiten und OCR-Seiten werden in Plänen mit Anmeldung mit 1 Credit pro Seite abgerechnet.
- Passwortgeschützte Dateien müssen vor dem Upload entsperrt werden; verschlüsselte PDFs werden abgelehnt.
Weitere Markdown-Konverter
- Word → MarkdownDOCX mit Überschriften und Listen
- PPT → MarkdownFolientext, Notizen und Tabellen
- Excel → MarkdownJedes Blatt als Tabelle
- Image → MarkdownOCR für Scans und Screenshots
- HTML → MarkdownHTML einfügen oder hochladen
- URL → MarkdownJede öffentliche Webseite, bereinigt
- Markdown → HTMLSauberes, semantisches HTML
- Markdown → TextKlartext ohne Markup
- Markdown → PDFLokal als PDF drucken
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
Fragen zu PDF in Markdown umwandeln
Wie funktioniert PDF in Markdown umwandeln?
PDF in Markdown umwandeln konvertiert die unterstützte Quelle in lesbares Markdown zur Prüfung und Wiederverwendung. Die anonyme Testnutzung akzeptiert bis 10 MB und 25 Seiten pro Datei, mit 3 Konvertierungen pro IP und Stunde und 10 pro Tag. Vergleiche das Ergebnis mit der Quelle, bevor du es verwendest; so lässt sich PDF Text extrahieren, ohne das Layout von Hand nachzubauen.
Wie groß darf ein PDF höchstens sein?
Der öffentliche Konverter akzeptiert PDF-Dateien bis 10 MB. Lite unterstützt Dateien bis 100 MB; Pro und Max haben höhere Limits.
PDF OCR: Wie werden gescannte PDFs verarbeitet?
Ja. Bildbasierte PDFs werden heute mit OCR verarbeitet; saubere, hochauflösende Scans liefern die besten Ergebnisse.
Werden mehrspaltige Fachartikel verarbeitet?
Ja. PDF in Markdown umwandeln versucht, die Lesereihenfolge zu rekonstruieren. Vergleiche Spaltenübergänge mit der Quelle, weil komplexe Layouts trotzdem Korrektur brauchen können.
Überleben Finanztabellen?
Tabellen in PDFs, die Strukturmetadaten tragen, werden in Markdown-Tabellen umgewandelt. Als Bild flachgedrückte Tabellen brauchen OCR zur Rückgewinnung.
Kann ich passwortgeschützte PDFs konvertieren?
Nein. Verschlüsselte PDFs können nicht geparst werden. Entferne das Passwort vor dem Upload.
Ist die Ausgabe gut genug, um sie für RAG zu chunken?
Das Markdown bewahrt Überschriften, Listen und Tabellen, wo es möglich ist, sodass Chunking und Embedding im Vergleich zu Copy & Paste vorhersehbar bleiben.
Kann ich PDFs aus Code konvertieren?
Ja. Nutze einen API-Schlüssel, um die Datei direkt an /v1/convert/pdf zu senden, und lies das Markdown aus der Antwort. Siehe /developers.
PDF in großem Umfang in Markdown umwandeln.
Kostenlos testen – keine Anmeldung nötig.