
Konverter
URL zu Markdown umwandeln
URL zu Markdown umwandeln ist ein kostenloser Konverter, der eine öffentlich erreichbare Webseite in sauberes Markdown ihres Hauptinhalts verwandelt – den Artikel, die Doku-Seite oder den Thread ohne die Seitennavigation – bereit für LLMs, RAG-Pipelines und Notizen. Keine Anmeldung zum Testen; die Testnutzung erlaubt 3 Konvertierungen pro IP und Stunde und 10 pro Tag.
So geht's
So wandelst du eine Webseite in Markdown um
Was du einfügen kannst
- Jede öffentliche http(s)-Seite – Artikel, Dokumentation, Blogbeiträge
- Seiten hinter einem Login oder einer Paywall können nicht abgerufen werden
- Die Seite wird auf unserem Server abgerufen, ohne ihr JavaScript auszuführen
- Teste ohne Konto: bis 10 MB und 25 Seiten pro Datei, 3 Konvertierungen pro Stunde und 10 pro Tag
Was du prüfen solltest
- Serverseitiger Abruf — Die Seite wird serverseitig abgerufen, wobei zuerst Markdown und dann HTML angefragt wird; das eigene Markdown einer Website wird nur verwendet, wenn es eine Qualitätsprüfung besteht.
- Hauptinhalt-Extraktion — Mehrere Extraktoren – Readability-Scoring, Boilerplate-Erkennung, Textdichte-Analyse und das eigene main- oder article-Element der Seite – treten gegeneinander an, und der, der am meisten Struktur und Fließtext behält, gewinnt.
- JavaScript-gerenderte Seiten — Eine leere Anwendungs-Hülle wird in einem Headless-Browser gerendert, der wartet, bis die Seite sich beruhigt hat, und dann das gerenderte DOM an dieselbe Extraktion übergibt.
- Öffentliche Seiten, Umfang und Identität — Nur öffentlich erreichbare URLs werden unterstützt: Seiten hinter Authentifizierung, Paywalls oder Login-Walls können nicht abgerufen werden.
Wohin das Markdown geht
- Kopiere das Markdown direkt aus der Vorschau
- Lade die .md-Datei herunter und behalte sie in deiner Bibliothek, sobald du angemeldet bist
- Konvertiere viele Seiten auf einmal mit einem urls-Array an POST /v1/convert/url
- Automatisiere es mit POST /v1/convert/url und deinem API-Schlüssel
Warum nutzen
Warum du diesen URL-zu-Markdown-Konverter nutzen solltest
Eine Webseite ist für einen Browser geschrieben. Markdown ist für Menschen und Modelle geschrieben. Dieser Konverter findet den Teil der Seite, der die Bedeutung trägt, behält dessen Struktur und lässt das Seitenbeiwerk zurück.
Hauptinhalt, nicht die ganze Seite
Mehrere Extraktoren lesen die Seite, und das Ergebnis, das am meisten vom Artikel behält, gewinnt, sodass Menüs, Cookie-Banner, Fußzeilen und Leisten mit verwandten Beiträgen aus dem Markdown herausbleiben.
Struktur, die überlebt
Überschriften, Listen, Tabellen und Codeblöcke kommen als Markdown durch, und jeder relative Link- und Bildpfad wird zu einer vollständigen URL umgeschrieben, die auch außerhalb der Seite funktioniert.
Auch JavaScript-Seiten werden gerendert
Wenn das erste HTML nur eine leere Anwendungs-Hülle ist, wird die Seite in einem Headless-Browser gerendert und stattdessen der gerenderte Inhalt konvertiert.
Kostenlos testen, kein Login
Sieh dir das Markdown ohne Konto in der Vorschau an und kopiere es, bis zu 3 Konvertierungen pro Stunde und 10 pro Tag. Melde dich an, um die .md-Datei herunterzuladen.
Ein höflicher, identifizierter Abrufer
Jede Anfrage identifiziert sich mit einem dokumentierten User-Agent, und Seitenbetreiber können sie blockieren – siehe die Fetcher-Seite in der Dokumentation.
Dieselbe Engine wie die API
Der Konverter auf dieser Seite und POST /v1/convert/url führen denselben Code aus, sodass ein Skript bis zu 20 URLs pro Aufruf konvertieren kann.
Das Problem
Warum eine lebende Seite für Modelle verrauscht ist
Seiten sind verrauscht
Lebende Webseiten vergraben Inhalt unter Navigation, Werbung, Bannern und Skripten – oft mehrere Male so viel Text wie der Artikel selbst.
Markup ist unordentlich
Handgeschriebenes und generiertes HTML bildet sich selten sauber auf lesbare Struktur ab.
KI braucht den Artikel
RAG und Agenten wollen den Artikel, nicht das Seitenbeiwerk darum herum – und manche Seiten zeigen den Artikel erst, nachdem JavaScript ausgeführt wurde.
Was erhalten bleibt
Was dieser URL-Konverter abruft
- Serverseitiger Abruf
- Die Seite wird serverseitig abgerufen, wobei zuerst Markdown und dann HTML angefragt wird; das eigene Markdown einer Website wird nur verwendet, wenn es eine Qualitätsprüfung besteht. Kein Browser-Plugin oder lokales Tool ist nötig.Source: RFC 9110: HTTP Semantics
- Hauptinhalt-Extraktion
- Mehrere Extraktoren – Readability-Scoring, Boilerplate-Erkennung, Textdichte-Analyse und das eigene main- oder article-Element der Seite – treten gegeneinander an, und der, der am meisten Struktur und Fließtext behält, gewinnt. Bekannte Seiten wie Dokumentationsgeneratoren, GitHub und Wikipedia nutzen eigene Site-Regeln.Source: HTML Living Standard: the main element
- JavaScript-gerenderte Seiten
- Eine leere Anwendungs-Hülle wird in einem Headless-Browser gerendert, der wartet, bis die Seite sich beruhigt hat, und dann das gerenderte DOM an dieselbe Extraktion übergibt. Inhalt, der erst nach einem Klick oder einem Scroll erscheint, wird nicht erfasst.Source: HTML Living Standard
- Öffentliche Seiten, Umfang und Identität
- Nur öffentlich erreichbare URLs werden unterstützt: Seiten hinter Authentifizierung, Paywalls oder Login-Walls können nicht abgerufen werden. Abgerufene Seiten unterliegen Größenlimits der Antwort, und der User-Agent des Abrufers ist unter /docs/fetcher dokumentiert.Source: product pipeline
Beispiel: markitdown.ai-Blogbeitrag per URL-Abruf· https://markitdown.ai/blog/why-pdfs-break-llms
# Why PDFs break LLMs — and what clean Markdown fixes _Published 2026-06-12 · The markitdown.ai team_ > A PDF that looks perfect to a human often falls apart the moment a model reads it. Here's what goes wrong, and why converting to clean Markdown first makes downstream AI far more reliable. A PDF renders perfectly for a human and falls apart the moment a model reads it. The page you see — columns, tables, headers, footnotes — is a *visual* arrangement, not a logical one. When you pull raw text out of it, that visual order rarely survives, and whatever you feed a language model is only as good as the text it actually receives. ## What actually goes wrong When teams pipe documents straight into an LLM or a retrieval index, a few failure modes show up again and again: - **Reading order breaks.** Multi-column layouts interleave. A two-column page becomes "line 1 left, line 1 right, line 2 left, line 2 right…", so a sentence a human reads top-to-bottom arrives at the model scrambled.- **Tables collapse.** Copy-paste turns a table into a loose run of numbers. The relationship between a header and its cell — the entire point of a table — is gone.- **Headings disappear.** The visual hierarchy (this is a section, this is a subsection) is encoded as font size and weight, not structure. Strip the styling and you get one undifferentiated wall of text. Anwendungsfälle
Anwendungsfälle für die Website-zu-Markdown-Konvertierung
Von KI-Agenten bis zur Content-Migration: eine Webseite in Markdown umzuwandeln ist ein kleiner Schritt, von dem viele Workflows abhängen.
KI- und LLM-Pipelines
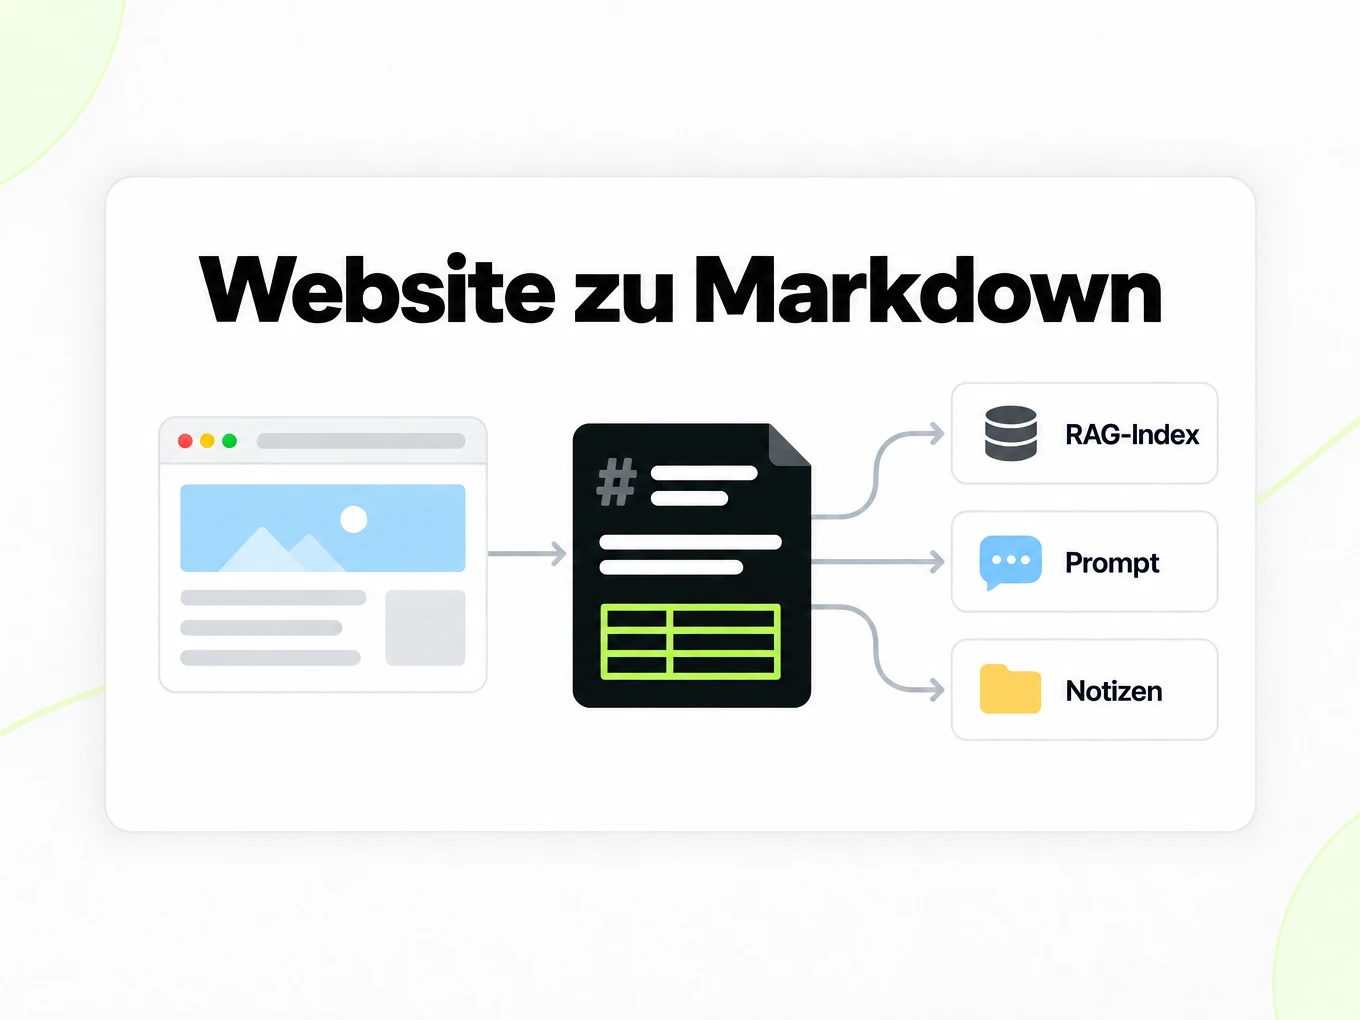
Speise Artikel und Dokumentation als sauberen Text mit intakten Überschriften in RAG-Indizes, Agenten-Tools und Prompts ein, statt rohes HTML.
Recherche und Notizen
Speichere eine Quelle als Markdown zum Zitieren, Kommentieren oder Aufbewahren in Obsidian oder einem Notiz-Repository – mit den ursprünglichen Links an Ort und Stelle.
Content-Teams
Verschiebe Beiträge und Hilfe-Center-Seiten von einem CMS in ein anderes oder ziehe Referenzmaterial in eine Markdown-basierte Doku-Seite.
Entwickler
Rufe die API aus Ingestion-Jobs und Crawlern auf, die du bereits betreibst, und erhalte dasselbe Markdown, das der Browser-Konverter zeigt.
API
URL-zu-Markdown-API für Entwickler
Konvertierst du Seiten aus Code? Sende eine URL – oder bis zu 20 in einem urls-Array – an POST /v1/convert/url mit deinem API-Schlüssel. Setze render auf auto, force oder skip, um das JavaScript-Rendering zu steuern, und frontmatter auf true, um Seitentitel, Autor und Veröffentlichungsdatum in YAML-Front-Matter zu packen. Das Markdown kommt in derselben Antwort zurück, wenn die Seite innerhalb des Wartefensters fertig wird; andernfalls erhältst du eine Konvertierung zum Abfragen oder einen Webhook, wenn sie abgeschlossen ist. API-Zugang gibt es in kostenpflichtigen Plänen.
API-Leitfaden lesencurl -X POST https://api.markitdown.ai/v1/convert/url \ -H "x-api-key: mdai_…" \ -H "content-type: application/json" \ -d '{"url":"https://markitdown.ai/blog/why-pdfs-break-llms","frontmatter":true}'Leitfaden
Die Ausgabe prüfen
Prüfe die Ausgabe von URL zu Markdown neben der öffentlichen Seite, die du eingereicht hast. Der Konverter behält den Hauptinhalt und lässt Navigation, Cookie-Hinweise und Fußzeilenlinks weg, aber eine Seite ohne klaren Artikel – eine Produktseite, eine Landingpage, eine Startseite mit vielen Teasern – kann trotzdem ein Seitenpanel verlieren oder einen Block behalten, den du nicht zitieren würdest. Prüfe den ersten und letzten Absatz gegen die Seite, bevor du das Ergebnis indexierst. Seiten, die ihren Inhalt mit JavaScript aufbauen, werden zuerst in einem Browser gerendert; eine Seite, die ihren Text erst nach einem Klick, einem Scroll oder einem Login lädt, kann weiterhin nicht erfasst werden. Wenn eine Website Clients, die danach fragen, bereits ihr eigenes Markdown ausliefert, verwendet der Konverter diese Version, sofern sie eine Qualitätsprüfung besteht, und fällt auf die HTML-Seite zurück, wenn sie wie ein Menü der ganzen Website oder ein Archiv-Dump aussieht. Bewahre die Quell-URL beim Markdown auf, damit Lesende zur Originalseite zurückkehren können.
Quellkontext bewahren
Bewahre die eingereichte URL und dein Abrufdatum zusammen mit einem Ergebnis von URL zu Markdown in deinem eigenen Workflow auf. Eine öffentliche Seite kann sich ändern, nachdem du sie konvertiert hast, sodass ein späterer Besuch eine überarbeitete Passage sehen kann. Mit aktivierter Front Matter beginnt das Ergebnis mit der Quell-URL, der kanonischen URL, dem Titel und – wenn die Seite sie angibt – Autor, Veröffentlichungsdatum, Beschreibung, Site-Namen, Sprache und Leitbild, gelesen aus den Meta-Tags, strukturierten Daten und der Byline der Seite. Diese Felder geben wieder, was die Seite über sich selbst angibt; prüfe sie an der Quelle, wenn deine Recherche darauf angewiesen ist. Das metadata-Feld der API ist anders: Es trägt nur von dir gelieferten Kontext. Vergleiche vor dem Zitieren einer Tabelle oder eines Absatzes mit der Seite und behalte genug umgebenden Kontext, um die Bedeutung nicht zu verändern. Markdown macht Webinhalte leichter wiederverwendbar; es stellt nicht fest, ob die Seite korrekt ist oder ob du sie veröffentlichen darfst.
Gespeichertes HTML vs. URL
Wähle den HTML-Konverter, wenn du bereits den genauen Seiten-Schnappschuss besitzt, den du verarbeiten musst. Wähle URL zu Markdown, wenn eine öffentlich erreichbare Adresse die Eingabe für die aktuelle Konvertierung ist. Das sind verwandte Workflows mit unterschiedlicher Quellenkontrolle: Eine gespeicherte Datei legt die Eingabe fest und wird vollständig konvertiert, während eine URL davon abhängt, was die Website zum Zeitpunkt der Anfrage zurückgibt, und auf ihren Hauptinhalt reduziert wird. Kein Weg umgeht Zugriffsbeschränkungen. Wenn eine Seite den Abrufer ablehnt oder einen Login verlangt, nutze Material, das du über einen geeigneten Workflow beschaffen darfst. Wiederhole nicht wiederholt eine unerreichbare URL, als ob ein weiterer Konvertierungsversuch Zugang gewährt.
LLM-Recherche
Forschende fügen eine Quelle ein, keine Datei. Dieser Konverter ruft die von dir eingereichte URL ab, behält den Artikel- oder Dokumentationstext und gibt Markdown zurück, das du zitieren, chunken oder in einen Notizspeicher legen kannst, mit Links, die weiterhin aufgelöst werden. Er rendert JavaScript-Seiten, wenn der Server eine leere Hülle sendet, und meldet sich nicht in Paywalls an.
- Nur öffentlich erreichbare URLs werden unterstützt.
- Der Abrufer identifiziert sich; Betreiber können den User-Agent ablehnen – siehe /docs/fetcher.
- Gespeicherte HTML-Dateien gehören auf /html-to-markdown, nicht hierher.
Weitere Markdown-Konverter
- PDF → MarkdownText, Tabellen und Scans
- Word → MarkdownDOCX mit Überschriften und Listen
- PPT → MarkdownFolientext, Notizen und Tabellen
- Excel → MarkdownJedes Blatt als Tabelle
- EPUB → MarkdownE-Book-Kapitel als Überschriften
- Image → MarkdownOCR für Scans und Screenshots
- HTML → MarkdownHTML einfügen oder hochladen
- Markdown → HTMLSauberes, semantisches HTML
- Markdown → TextKlartext ohne Markup
- Markdown → PDFLokal als PDF drucken
Need it in your code? Use the developer API. Converting at scale? See plans and pricing.
FAQ
Fragen zu URL zu Markdown
Wie funktioniert URL zu Markdown umwandeln?
URL zu Markdown ruft die öffentliche Seite ab, die du einfügst, behält ihren Hauptinhalt und wandelt ihn mit vollständigen URL-Links in Markdown um – keine Datei zum Hochladen. Seiten, die JavaScript brauchen, werden zuerst in einem Browser gerendert.
Entfernt es Werbung und Navigation aus einer lebenden Seite?
Ja, bei Seiten mit einem klaren Hauptinhaltsbereich. URL zu Markdown behält den Artikel, den Dokumentationstext oder den Thread und lässt Menüs, Cookie-Banner und Fußzeilen weg; eine Landingpage oder Produktseite ohne einen klaren Hauptblock kann ein Seitenpanel trotzdem behalten oder verlieren, also prüfe das Ergebnis.
Gibt es Größenlimits für eine abgerufene Seite?
Der öffentliche Konverter arbeitet mit öffentlichen Webseiten. Abgerufene Seiten unterliegen Größenlimits der Antwort und können abgelehnt werden, wenn sie zu groß sind.
Funktioniert es bei Seiten hinter einem Login?
Nein. Nur öffentlich erreichbare URLs werden unterstützt. Seiten hinter Authentifizierung, Paywalls oder Login-Walls können nicht abgerufen werden.
Was ist mit JavaScript-gerenderten Seiten?
JavaScript-gerenderte Seiten werden in einem Headless-Browser gerendert, wenn das erste HTML eine leere Hülle ist, und dann wie jede andere Seite konvertiert. Über die API rendert render auf force immer und skip nie. Text, der erst nach einem Klick, einem Scroll oder einem Login erscheint, wird nicht erfasst.
Kann ich mehrere URLs auf einmal konvertieren?
Sende ein urls-Array mit bis zu 20 öffentlichen URLs an POST /v1/convert/url. Verfolge jedes Dateiergebnis und behandle asynchrone Antworten. Siehe /developers.
Ist URL zu Markdown kostenlos?
Ja. Vorschau und Kopieren des Markdowns sind kostenlos ohne Konto, bis zu 3 Konvertierungen pro Stunde und 10 pro Tag; das Herunterladen der .md-Datei erfordert eine Anmeldung. Nur öffentliche Webseiten (keine internen oder privaten URLs).
Welchen Inhalt bewahrt der Konverter?
Der Konverter bewahrt die Überschriften, Absätze, Listen, Links, Bilder, Tabellen und Codeblöcke des Hauptinhalts, wobei relative Links zu vollständigen URLs umgeschrieben werden. Skripte, Styles, Navigation und Fußzeilen entfallen; mit aktivierter Front Matter stehen Seitentitel, Autor und Veröffentlichungsdatum oben.
Gibt es eine URL-Konvertierungs-API?
Ja. Konvertiere Webseiten per URL programmatisch über die REST-API. Siehe /developers. Gespeicherte HTML-Dateien nutzen stattdessen /html-to-markdown.
URL in großem Umfang in Markdown umwandeln.
Kostenlos testen – keine Anmeldung nötig.